

















26
16
TiDB 如何稳定承载 Kimi 在 AI 时代的应用服务?
2026-11-09 19:42:14
0点赞
0收藏
0评论
引言:
100 万虚拟库、亿级 QPS、单库生命周期缩至一周 —— 这是月之暗面 Kimi 在 TiDB 之上的实际运行规模。当 AI 原生应用的数据量、租户数和生命周期全部失控,传统数据库架构已经接不住这种业务。Kimi Harness Team Engineer田鹏飞在 TiDB 社区活动北京站现场首次公开:他们如何用 TiDB 把这套 “AI 时代最难的数据底座” 跑起来。
 Drawing 0
一、为什么 Kimi 要重写"数据库底座"
过去两年,AI Agent 从"工具"演化为"执行者"。在 Kimi 的业务版图里,每一个项目背后都可能站着几十甚至上百个 Agent 共同协作——它们读写数据库、调用工具、生成报告、维护记忆。
直接连数据库的传统模式很快失效。 田鹏飞把这个趋势浓缩成一个判断:“AI 时代,Agent 既是使用者也是生产者。当 Agent 变成了 DBA 本身,传统数据库的一库一应用假设就被彻底打破。”
这给数据库带来三组新的需求:
1.海量独立租户:每个项目、每个 Agent 沙箱都需要一个独立数据库环境,量级从"几十"跳到"百万级"
2.流量完全不可预测:Agent 工作负载是脉冲式的——任务来了,瞬间并发;任务结束,立刻静默
3.库生命周期极短:调试、试错、记忆沉淀,让数据库实例的"半衰期"从"按年计"变成"按天甚至按小时计"
传统数据库架构在这三组需求面前几乎全线失灵:
四条路都走不通,意味着 Kimi 没有“渐进式改良”的选项。要么继续在传统架构上做加法、把每一条痛点都靠工程补丁临时糊上;要么换一套从设计上就为 AI 业务特征而生的底座。Kimi 选了后者,而这套底座最终落到了 TiDB 身上。
二、选型逻辑:为什么最终选定 TiDB
SQL 协议层不动,应用层 0 改造。底层换成能扛住 AI 流量的分布式引擎,这是 Kimi 选型的核心思路。田鹏飞在演讲中分享了选型三原则:
1.MySQL 协议兼容——AI Agent 生成的 SQL 不可控,必须最大程度继承 MySQL 生态
2.海量逻辑库 + 共享底层——单集群承载百万级租户
3.存算分离 + 弹性伸缩——闲置资源自动释放,应对脉冲式流量
Kimi 团队把市面主流方案都过了一遍,最终选择兼容 MySQL 的分布式 TiDB。关键打动点有三个:
•存算分离 2.0 架构:让"按用量付费"成为可能,AI 业务的资源浪费被压缩到极致
•虚拟数据库设计:每个项目 = 一个独立逻辑库,对应底层的共享分布式 KV
•MySQL 协议原生兼容:现有 MySQL 工具链、ORM、BI 工具 0 改造直接复用
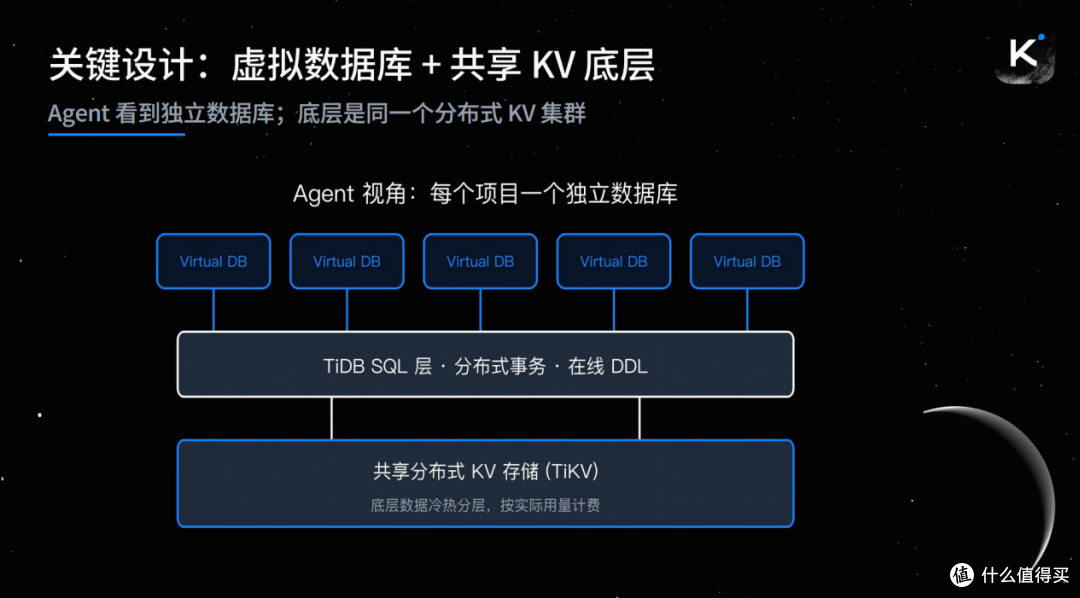
三、关键架构:虚拟数据库 + 共享 KV 底层
 Drawing 1
Kimi 整体的数据底座可以划分为四层。
最上层是 Agent 本身。 在 Kimi 的设计中,Agent 并不直接与数据库交互,所有数据访问都通过中间的 “主调度服务”完成。这种 “Agent 与数据之间隔一层调度”的设计,让 Agent 只关心任务逻辑,不必感知数据库的存在,也避免了上百万个 Agent 直接冲击数据库带来的连接风暴与运维复杂度。
第二层是 Kimi 自研的主调度服务。 这是整个数据底座最关键的一环。它同时承担两个角色:一是数据库元数据的管理者,二是租户级的调度中枢。主调度服务可以按需为每个租户创建逻辑库,对单个租户的库做秒级扩缩容,并在租户生命周期结束后将库销毁。在百万级虚拟库的规模下,这层调度能力决定了 Kimi 能否在成本和性能之间保持平衡。
第三层是 TiDB 的 SQL 层。 负责承接所有结构化数据的存储与计算,提供分布式事务、在线 DDL、MySQL 协议兼容等能力。无论上层租户如何动态变化,SQL 层始终保持统一的接口和一致的事务语义。
最底层是共享的分布式 KV 存储(TiKV)。 所有租户的数据最终汇聚在这一层,通过冷热分层存放。冷热分层不仅降低整体存储成本,也使 Kimi 能够在百万级逻辑库的规模下,依然把 "为每个租户独占一整套数据库" 作为默认形态 —— 而真实存储则在底层共享、按用量计费。
这套设计解决了 AI 业务三个最棘手的问题:
•每个 Agent 不直接连库——必须经由调度层,避免 Agent 误操作直接打到底层存储
•主调度服务统一管控——一个项目 = TiDB 上一个独立逻辑库;生命周期由调度层托管
•底层数据冷热分层——长尾租户的数据自然落冷存储,计算资源随用随开
对比传统"一应用一库"模式,Kimi 这套架构的核心收益是:
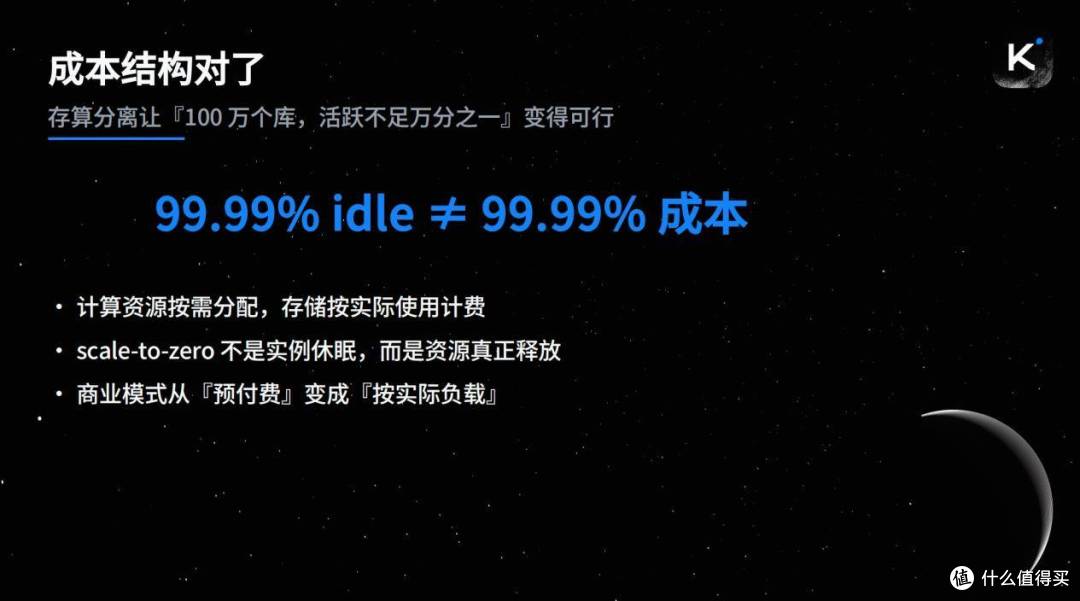
四、落地效果:让"百万库、零闲置"从概念变成可计费的现实
 Drawing 2
1. 百万级轻量租户的"零边际成本托管"
长尾 Agent 沙箱按秒级开关,单个数据库实例成本可压缩到分级别。这让 Kimi 能放心为开发者提供"开箱即用"的数据库沙箱,不必担心资源爆炸。
2. 脉冲流量下的"自动吸收"
Agent 任务带来瞬时并发高峰,存算分离架构让计算层可以快速横向扩;任务结束立即缩容。对 AI 业务常见的"几百倍突发"具备原生吸收能力。
3. AI Agent 的"原生 MySQL 体验"
Agent 自动生成 SQL 的场景下,MySQL 兼容性意味着零额外适配层。Agent 写什么、TiDB 就能跑什么,这是 Kimi 选型最朴素也最关键的标准。
4. 平台化能力开箱即用
集群内置高可用(Raft 多副本)、自动备份、PITR(时间点恢复),无需 Kimi 工程团队从零搭建运维体系。DBA 精力从"保稳定"转向"促业务"。
五、Kimi案例给同行企业的启示
Kimi 给出了"AI 时代数据库底座"的判断方法论,对于同样在做 AI Agent 平台、AI SaaS、智能助手的企业,可以从三个维度审视自己的选型:
① 你的租户量级是多少?
•几十 → MySQL/PG 够用
•几百 → 考虑中间件或云 RDS
•上千 / 百万级 → 必须用存算分离的分布式数据库
② 你的流量模型是什么?
•平稳可预测 → 传统数据库
•白天有规律波动 → 云 RDS
•脉冲式 / 不可预测 → 必须支持秒级弹性扩缩
③ 你的库生命周期有多长?
•按年计 → 任何方案都行
•按月计 → 需要自动化运维
•按天 / 按小时计 → 必须有"自动销毁、自动释放"机制
六、结语
Kimi 的实践验证了一件事:AI 时代的数据库底座,不是"性能更强的 MySQL",而是"以 MySQL 协议为入口、以存算分离为骨架、以多租户为默认"的全新形态。
平凯数据库(TiDB 企业版)正是沿着这个方向在演进。2026 年 4 月推出平凯数据库云服务,让百万级轻量租户、脉冲流量、按用量计费成为开箱即用的能力。
AI 业务的“数据库焦虑”,正在成为过去时。










