






17
11
Opus 5.5 太烧 Token?可能是你的提示词在拖后腿
2026-11-02 16:19:23
1点赞
2收藏
0评论
大家好,我是小林。
最近看到 Anthropic 官方博客发了一篇《Reducing cost and improving performance with Claude Platform》,聊的是怎么让 Claude 少花钱,同时把活干好。
 image-20261009191514987
如果你用 API 做过 AI 应用,可能遇到过这种情况。
功能跑通了,效果也还行,可一看费用,又有点肉疼。换个便宜模型吧,担心做不好,让模型少想一会吧,又怕漏掉关键步骤。
想省钱,就得接受效果变差吗?倒也不一定。
有些费用花在了反复处理同样的资料、重复做已经完成的检查上。
先把这些多余的工作找出来,可能不用换模型,就能省下一部分。
────一、差不多的内容,为什么还要反复花钱?────
假设你做了个客服 Agent,每轮请求都带着退款政策、工具说明和之前的对话。用户只补了一句「订单号找到了」,前面那一大段资料还是得一起发过去。
资料没变,能不能少算一遍?提示词缓存就能帮这个忙。
Claude 处理输入后,平台会保存供模型继续计算的内部数据,也就是 KV cache。下次请求带着相同的开头,就有机会直接复用,读取费用也更低。省掉的是重复处理输入的开销,新问题仍然需要模型回答。
▲ 相同客服资料复用缓存后继续回答新问题
那为什么内容差不多,缓存却没命中?
因为「意思一样」不够,请求开头要复用的那段内容,也就是前缀,必须逐字节一致,还得是同一个模型,并且缓存没有过期。 时间戳或请求 ID 放在前面,每次一变,就可能让后面的大段资料没法照旧复用。
遇到这种情况,先去 Claude Console 看缓存诊断,或用诊断 API 比较相邻请求,找到前缀从哪里开始变化。组织请求时,稳定的工具定义、系统提示词放前面,新对话往后追加,工具定义的内容和顺序也尽量保持不变。
▲ 追加消息与改变前缀对缓存复用的影响
不常用的工具,可以先声明并标记 defer_loading,暂时不把定义放进缓存前缀,等 Claude 通过工具搜索找到时再追加。中途补系统指令,也可以使用平台的「对话中追加系统消息」功能,不用回头改开头那段提示词。
设置也会影响前缀。effort 控制模型投入多少精力,和 thinking 这类思考设置一样,聊到一半直接改请求设置,可能破坏缓存。
Opus 5、Opus 5.5 和 Fable 5.1 支持用新增消息调整后续 effort,采用这种方式可以保留缓存。分出子 Agent 或对话分支时,也要核对模型、前缀和 effort 是否一致,不能默认共享。
如果确实要换模型,或采用会破坏缓存的方式调整 effort,可以和上下文压缩一起做。压缩本来就要改写大量旧消息,相关缓存也要重建。对话不断增长时,则可以用自动缓存,把「缓存到哪里」的断点移到最后一个可缓存的内容块。
想让首次正式提问少等一会,还可以提前发送 max_tokens: 0 的请求,并明确设置缓存断点。这样只处理输入、写缓存,不生成回答,正式请求就有机会命中。预热只是把处理时间提前,本身仍有缓存写入费用。
最后留意等待时间。5 分钟缓存从请求开始计时,主 Agent 等工具或子 Agent 返回结果,超过这个时间,下一轮就可能需要重新写入。
这类任务可以考虑 1 小时缓存,但写入价格也更高,5 分钟缓存是普通输入的 1.25 倍,1 小时则是 2 倍,要结合复用次数来选。
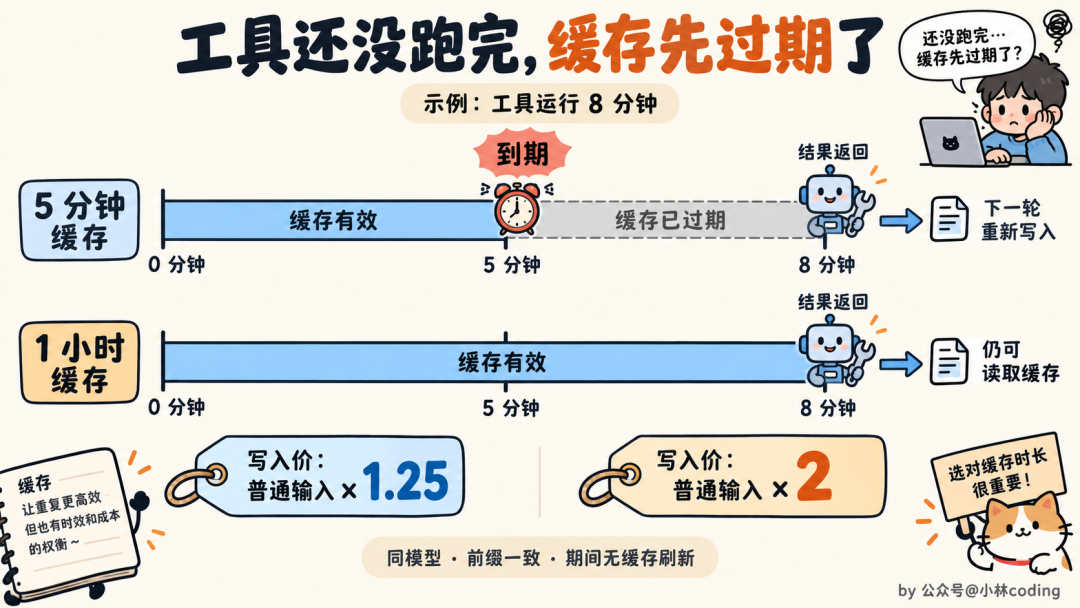 长工具调用与两种缓存有效期对比
────二、以前写的好提示词,怎么反而拖后腿了?────
缓存理顺了,再看看模型拿到请求后都做了什么。
以前模型漏查一次,你就补一句「回答前检查两遍」。回答不够详细,再补一句「尽可能全面」。这些规则积累下来,模型升级后还都需要吗?
有些叮嘱是为旧模型补短板,新模型已经会做了,你继续强调,反而可能让模型多做几轮。
翻翻自己的提示词,可以重点找这六类问题。
• 反复验证,比如「再检查一遍」「回复前验证两次」,模型可能真的重复做一遍相同操作。• 过度强调,比如「尽可能全面」「非常重要,你必须始终……」,可能引出冗长回复和额外工具调用。• 强制流程,比如「在草稿区一步一步思考」,或不管什么任务都走固定六步,可能让模型在自带的推理之外,又照着模板写一遍。• 过时示例,为了教旧模型写出的长推理样例,可能让新模型连简单请求也照着展开。• 互相矛盾的规则,比如一边要求「符合政策就退款」,一边又要求「任何退款都要先提交上一级处理」。遇到符合条件的退款,模型还是可能卡住。• 旧配置,例如为上一代手动设定的思考 token 预算,新模型可能已经不支持,带着旧参数发请求,API 就会报错。
▲ 重复验证导致两次相同订单查询
不想自己一条条翻,可以让 Claude 帮你检查。
官方把这项能力放进了 claude-api Skill,在 Claude Code 中加载支持该功能的版本后,运行这个命令。
● ● ●/claude-api prompt-audit
检查范围包括工作目录里的提示词、Skills、工具描述,也包括调用 Claude API 的应用代码,以及 CLAUDE.md 这类配置。
这类修改能省多少?Anthropic 做过一个客服实验,准备了六份提示词,每份各加入一个问题,再比较使用旧模型、只换新模型,以及换模型后清理提示词的结果。
从 Opus 4.8 换到 Opus 5.5,平均费用先降了约 18%,主要来自输入和缓存读取价格降低。清理提示词后,费用又降了约 9%,准确率提高约 2 个百分点。
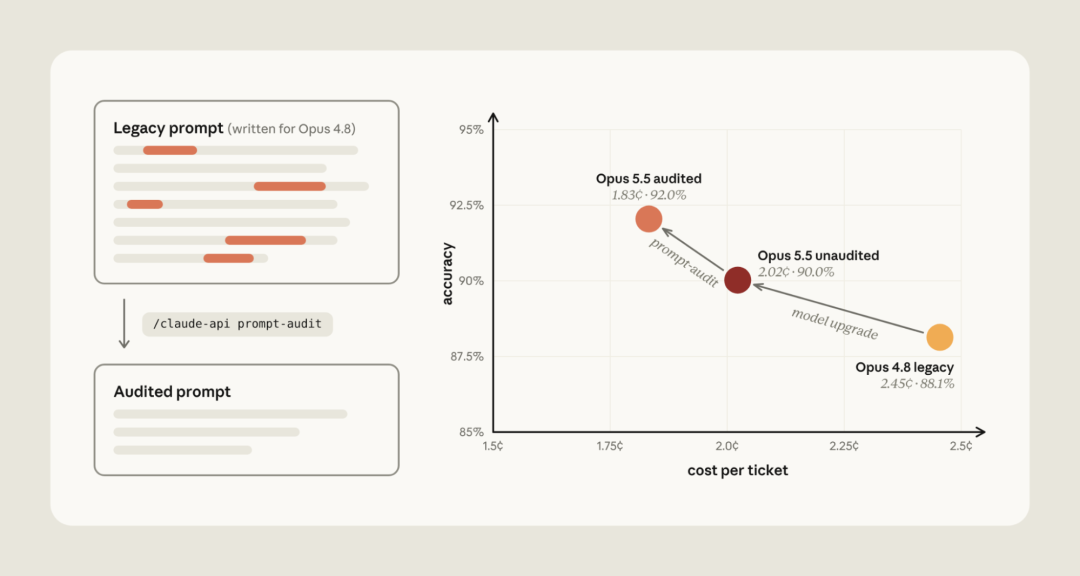 模型升级与提示词审查对客服任务费用和准确率的影响
六组客服提示词实验的平均结果。横轴越往左,每张工单费用越低;纵轴越往上,准确率越高。 图源 Anthropic。
为什么改几句话还能提高准确率?实验里的旧配置让请求直接报错,矛盾规则让模型遇到四笔该退的款时,停下来等客户确认。还有三张工单,模型照着要求在草稿里写了工具调用,却没有真正执行。
你看,提示词长短只是表面。
要检查的是,那条规则让模型多做了什么,有没有把任务带偏。业务里必须遵守的退款条件当然得说清楚,别把这些也当成多余叮嘱删掉。
────三、思考强度拉满,效果就一定更好吗?────
有些同学用模型,设置里只要有 max,就先拉满,生怕没用上全部能力。
前面说过,effort 可以调节 Claude 投入多少精力。低档通常更快得出结论,高档会花更多时间推敲、验证和尝试其他方案。但多花的钱能换来多少提升,还得看具体任务。
比如让 Fable 5 做 FrontierCode Diamond 最难的 50 道编程任务,从 low 调到 max,得分从 11.5% 升到 30.9%,每题费用从 5.35 美元升到 19 美元。这组难题上,多想一会确实换来了提升。
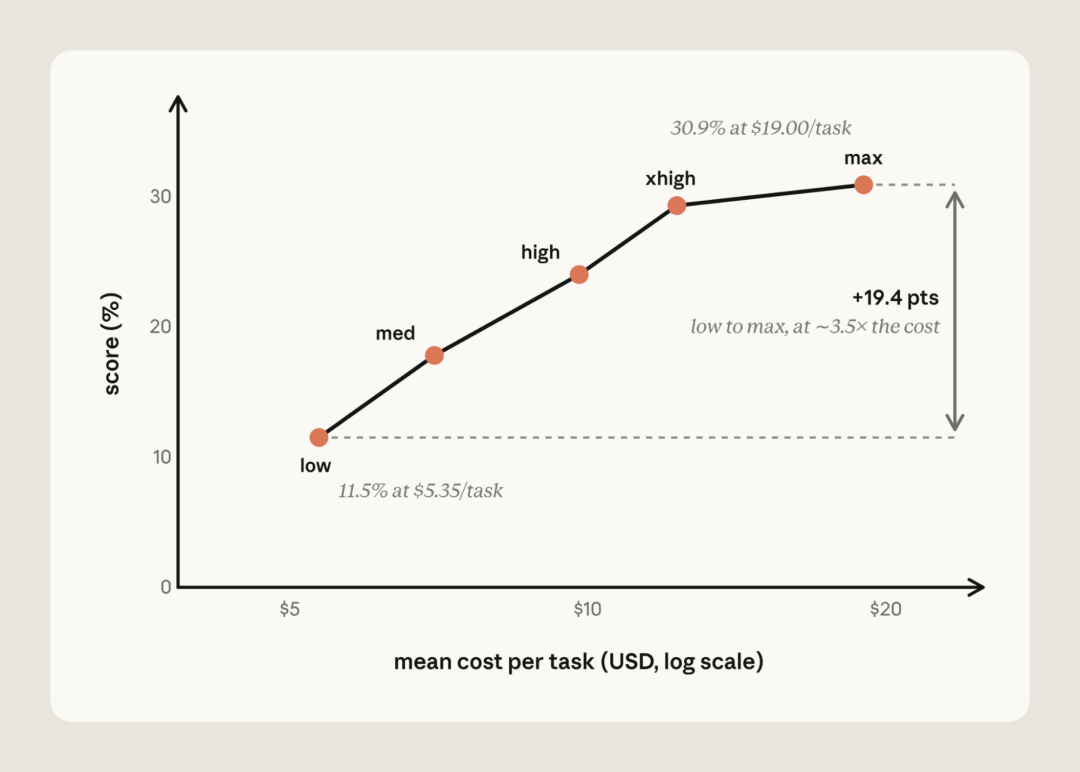 Fable 5 在 FrontierCode Diamond 上不同 effort 的得分与费用
这组编程任务中,从 low 到 max,得分提高 19.4 个百分点,费用约为原来的 3.5 倍。横轴为每题美元费用,采用对数刻度。 图源 Anthropic。
换成 Fable 5.1 做 Humanity’s Last Exam,也就是「人类最后的考试」,在不使用工具的条件下,从 low 到 max,得分约从 53% 升到 61%,每题费用约从 0.30 美元升到 2.23 美元。
乍看也有提升,可最后从前一档升到 max,费用又多了 46%,得分只多约半个百分点。这个差距还没有超出重复测试本身的波动,不能据此说多花的钱换来了稳定提升。
▲ Fable 5.1 升至 max 的最后一档收益
所以,档位拉满未必划算。明明已经没有新证据可找,模型还在反复琢磨,既慢又贵,有时还会把判断带偏。
看到这里,你可能想,那我默认调低,遇到难题再说?问题是,模型未必会告诉你「这道题我没想够」。
调得太低,Claude 可能只看第一条搜索结果就交卷,本来该查的证据、该做的检查都没完成。回答看起来挺完整,依据却只找了一半。档位合不合适,要看实际完成任务的效果。
选模型时,也可以把「更强的模型配低 effort」放进对比。
在 CursorBench 3.2 上,Fable 5.1 用 low,达到了 Fable 5 用 high 的表现,费用约为后者的三分之一。
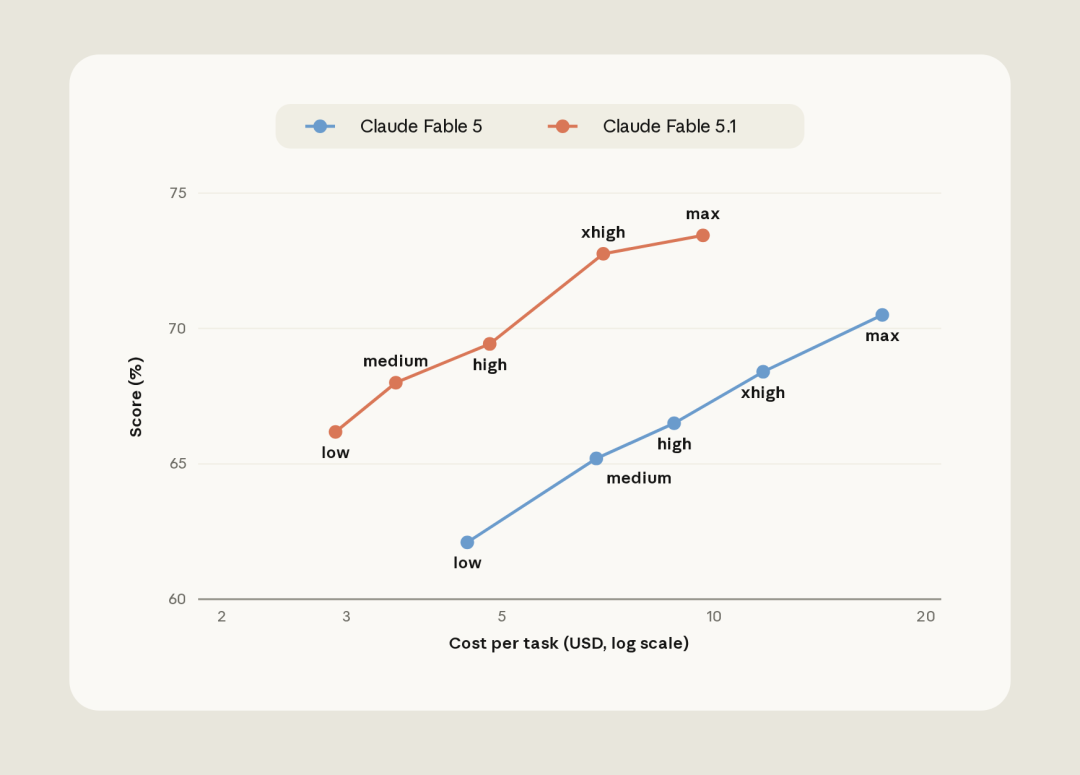 Fable 5 与 Fable 5.1 在 CursorBench 3.2 上的成本与得分
CursorBench 3.2 上,橙线是 Fable 5.1,蓝线是 Fable 5。Fable 5.1 的 low 与 Fable 5 的 high 得分接近,费用更低。 图源 Anthropic。
省下来的钱有两部分原因,一是低档完成任务时做的工作更少,二是 Fable 5.1 的缓存读取价格更低。即使按 Fable 5 的价格重新算,Fable 5.1 用 low 仍便宜约 40%。
别只比每百万 token 的单价,还要看把同一个任务做完,总共花多少钱。
自己的任务怎么选?拿一组能评判对错的任务,分别测试不同模型和 effort,记录成绩与费用。
如果模型还远没做到满分,调高 effort 后成绩却没什么变化,就值得查查是不是缺资料、提示词没说清楚,光让模型多想,未必能解决问题。
这些组合不用全靠自己手动试,claude-api Skill 还有一个命令。
● ● ●/claude-api hillclimb
给 Claude 一组评测任务后,Claude 会拆成训练集和测试集,尝试在保持现有成绩的同时降低费用。先用训练集尝试配置,查看失败案例,再调整提示词。这里的「训练」是调应用配置和提示词,并不更新模型本身。
测试集则留到最后验收,看看换一批没参与调优的题,效果还能不能保持。否则盯着同一批题反复改,很容易变成只会答这几道题。
▲ 训练集调优与留出测试集验收流程
Anthropic 用客服任务试过这个过程。从 Opus 4.8 默认的高档起步,改用 Opus 5 低档并清理提示词后,训练准确率达到 98.9%,每张工单费用降到 2.6 美分。接着换 Sonnet 5 低档,费用降到 1 美分,准确率却掉到了 88.9%。
Claude 没有就此换回更贵的模型,而是检查答错的工单,补上不同请求该如何分流的规则,以及核对退款上限时该参考哪些规定。训练准确率回到 98.9%,费用仍是 1 美分。
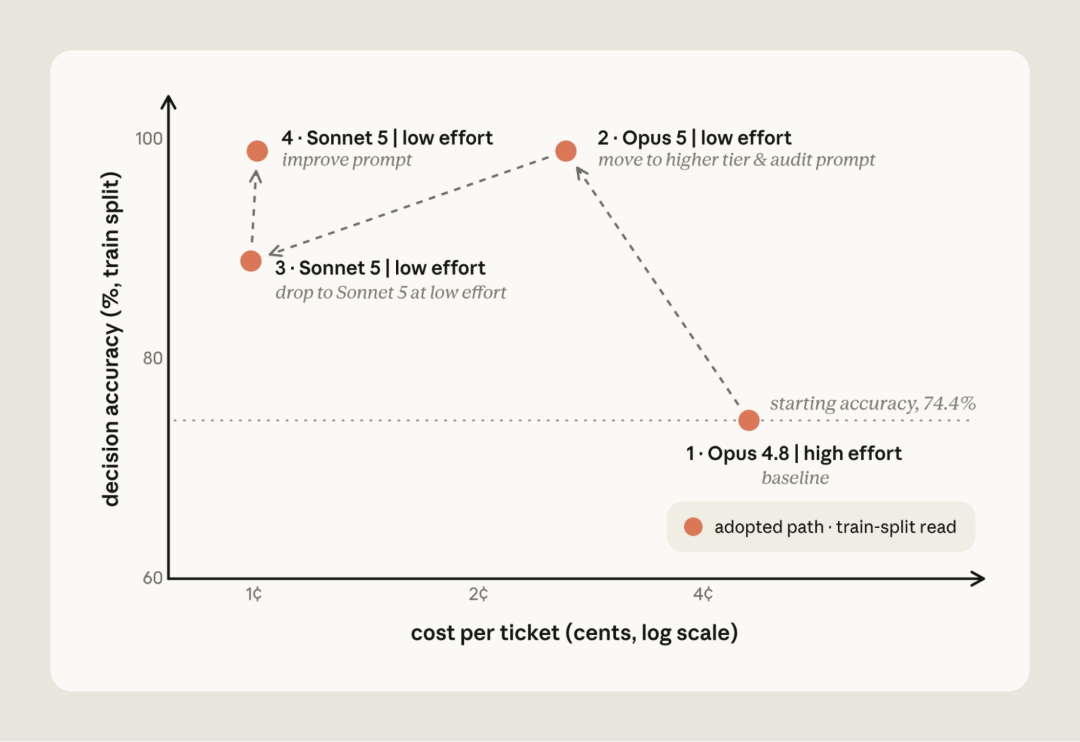 客服任务在训练集上的模型、effort 和提示词优化过程
箭头按 1 到 4 展示调优顺序。图中是训练集成绩,起点为 74.4%;下文另报测试集成绩。横轴为每张工单的美分费用,采用对数刻度。 图源 Anthropic。
最后,在留出的 14 张工单上,这组配置的得分为 90.5%,初始配置是 78.6%,费用约为初始配置的五分之一。
工单数量不多,自己的业务能省多少,还得自己测。不过这个过程挺有启发,模型答错了,先看究竟缺了什么,再决定是补信息、改规则,还是提高思考强度。
────四、这些省钱办法,能让 Claude 自己找吗?────
前面每个地方都检查一遍,听着还是有点费劲。如果你的应用调用了 Claude API,可以让 Claude 从费用和请求入手,帮你找出值得改的地方。
● ● ●/claude-api cost-optimize
运行 cost-optimize 后,Claude 会先看钱花在哪里。
有 Claude Admin API key,就读取组织的用量和费用报告。没有的话,可以看应用日志里每次 API 响应的 usage,也就是用量记录。两样都没有,就检查代码怎么组装请求,估算可能的开销。
前两种有实际用量作依据,最后一种只是估算,读结果时得分清楚。
▲ 成本审查的数据来源选择流程
找到开销后,Claude 会判断哪些地方值得优先优化,比如增加缓存、删掉每次请求里用不到的内容、审查提示词、减少冗长输出。允许晚些拿到结果的工作,还可以交给更便宜的 Batch API 批量处理。
再提供评测集,Claude 就能比较不同模型和 effort 下,省了多少钱、效果有没有变化。
Anthropic 以 Opus 5.5 为起点,在四组公开评测上测试了这个命令。
• LegalBench,组合使用缓存、低 effort 和批处理,费用约降 67%,思考 token 约降 84%,准确率变化不到 1 个百分点。• tau2-bench retail,发现约 93% 的提示词可以缓存,费用约降 73%,得分提高 2.6 个百分点,但未观察到统计上显著的变化。• OfficeQA Pro,使用批处理,并把过大的文档裁到最相关的部分,费用约降 72%,得分没有显著变化。• SWE-bench Verified,原本已经用了缓存,便把 effort 调到 medium,并限制 Agent 用几句简洁的话输出,费用约降 24%,得分提高 1.1 个百分点,同样未观察到统计上显著的变化。
▲ 四组公开评测经过成本优化后的费用与得分变化
左侧展示费用降幅,右侧展示得分变化,单位是百分点。横线是 95% 置信区间,跨过零时,不能认定得分有显著变化。 图源 Anthropic。
你看,同一个命令,几组任务省钱的地方并不一样。有的主要靠缓存,有的靠缩短输入和批处理。已经把缓存用好的编程任务,也还有调整 effort 和输出长度的空间。
所以别只盯着「省了 73%」,也看看自己的应用是不是有同样的问题。
尤其是批处理,要用在允许异步等待的工作上,用户还在聊天窗口等回复,就不适合照搬。
────写在最后────
下次觉得 Claude 花钱太快,先看看有没有反复处理相同资料、重复做检查的情况,老提示词也顺手翻一翻。有些钱,可能就花在这些不起眼的地方。
具体从哪里下手?按你手头的问题选就好:
• 刚换新模型,想检查老提示词、CLAUDE.md 和 Skills 是否还合适,先用 prompt-audit。• 做的是 Claude API 应用,想从账单和请求里找省钱机会,用 cost-optimize。• 手头已有评测任务,想让 Claude 反复尝试模型、effort 和提示词的组合,再用 hillclimb。
不必一次全跑完。先找一处改好,再拿同一组任务跑一遍。
费用降了,事情也照样做对了,这样省下来的钱才踏实。
参考资料:https://claude.com/resources/articles/reducing-cost-and-improving-performance-with-claude-platform
推荐阅读:
Anthropic 重磅发布:Claude Opus 5.5 最佳使用手册!