

最近半年,LLM应用开发的首页反复被同一个问题顶上来:为何LLM的harness(壳)几乎都选择TypeScript开发?opencode、deepseek-harness、Claude Code、Gemini CLI……名单越列越长,唯一的例外是"Codex怎么是Rust"。这怎么看都不像一场语言竞赛,但事实就是这么整齐。我们翻完七大开源Agent的源码实测和Claude Code之父的访谈,答案朴素到让人意外。
一、先把事实摆出来:整个赛道用脚投票
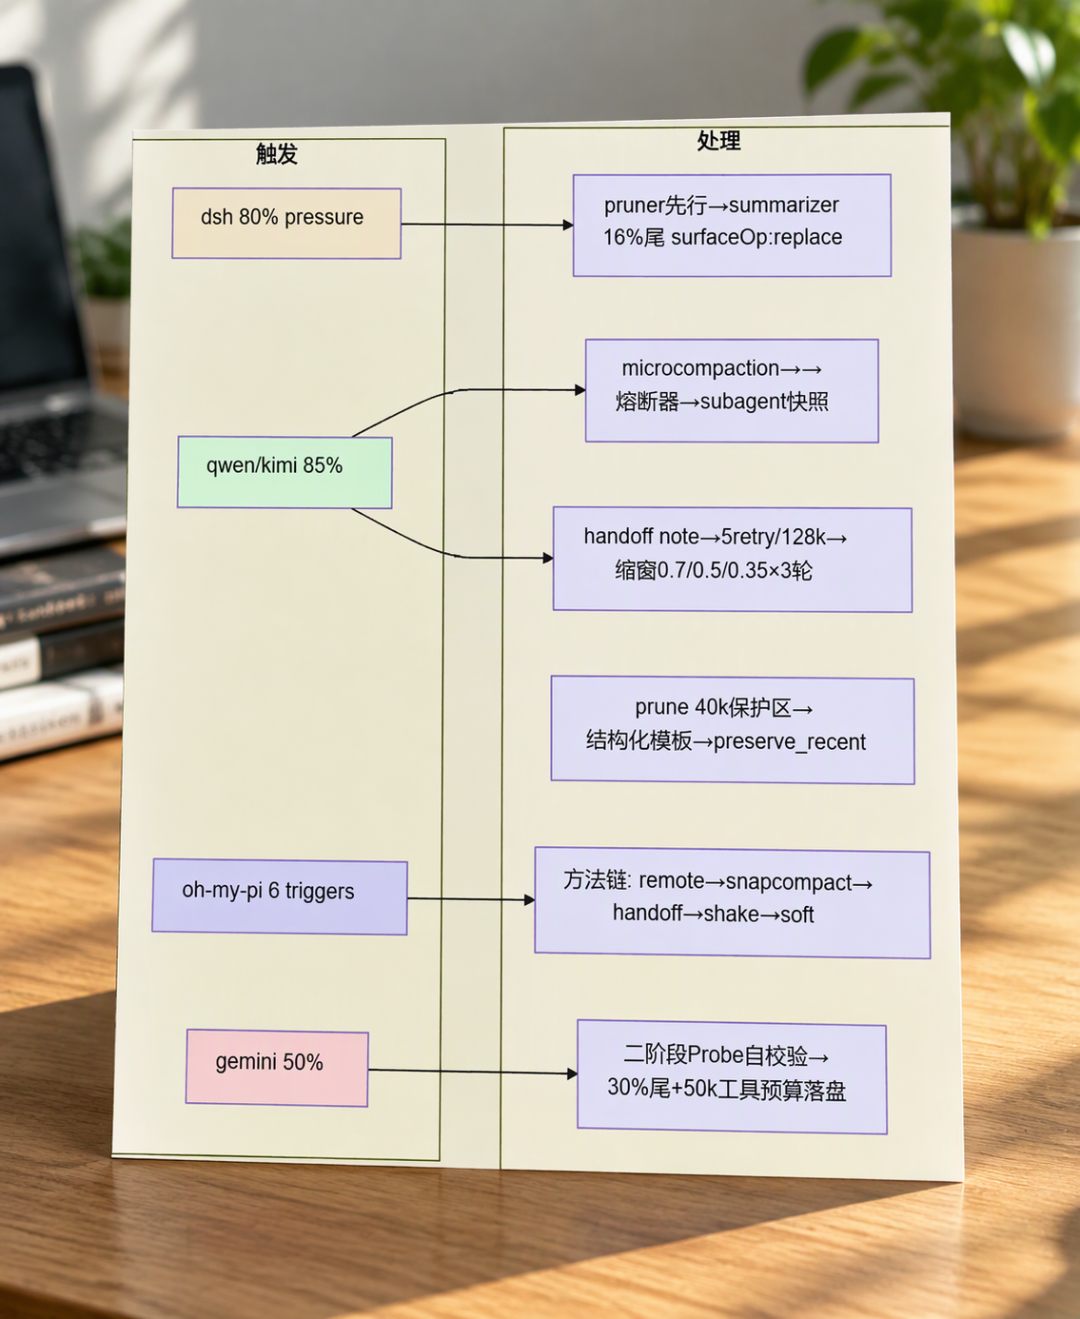
有开发者把codex、gemini-cli、qwen-code、opencode、kimi-code、deepseek-harness、oh-my-pi七个开源编码Agent逐文件拆了一遍,结论是主循环高度趋同,全是ReAct式的"采样 → 工具批执行 → 结果回灌"。而且.ts文件随处可见,kimi和qwen的目标状态机甚至同源。Claude Code的代码库泄露过,扒开一看——“就很朴素,TypeScript加React”。原问题评论区那句最高赞的大实话,反而最接近本质:“所以这是人在哪,不是语言比出了胜负”。知乎专栏知乎知乎
二、为什么是TS?三条理由,没有一条是性能
写胶水的人就在那儿。 harness本质是粘合层:模型API、上下文、编辑器、终端、浏览器。写这层的人基本都长在Web/Node生态里,工具链顺手,插件生态现成,类型能在接口一变时先报错。
分发和IO才是壳的本命。 一个做过大规模Agent的开发者给过很实在的复盘:做本地自动化这类场景"其实用ts,因为跨平台能力更好,而且比较好做异步并行"。一行npm全局安装、一份代码通吃Mac/Win/Linux,流式输出和工具并行调用全是事件循环的主场——而且agent基本都是云+端模式,端侧的壳离不开这套。知乎
套娃逻辑:壳越来越多是模型自己写的。 Claude Code之父Boris Cherny毫不包装:TS和React在训练数据里占比高,“你选的语言和框架在训练分布里权重越高,模型写起来就越顺手”,当年模型不够强,所以老老实实用"大路货"技术栈就是最优解。那个"为什么不用Rust重写Claude Code"的回答给出同款判断:TypeScript是AI和人类协同维护的甜点区。壳的语言选择,从来不是选最快的,是选模型最懂的。知乎知乎
三、那Codex为什么是Rust?
Codex是这份七家名单里唯一的Rust例外,两条独立素材都直接坐实:源码实测的演化路线头一条就是"向系统要纵深",点名的正是codex和omp的Rust化与沙箱。要纵深的地方是安全沙箱和底层控制,这块Rust确实香。知乎专栏知乎
还有人才结构在暗处起作用:有猜测认为,从后端正规军视角出发,就更大概率选Rust。知乎
但注意,连TS生态自己都在底层用Rust写重模块。应用层的归应用层,底层的归底层,这才是王道。知乎
四、比选语言更值钱的,是把壳写薄
这个话题和另一个热问题"AI领域有哪些大道至简的想法"其实是同一个答案的两面。Boris的团队当年故意守着终端形态不动:只有终端这种极简的壳子,才能跟上模型迭代的速度,模型升一级,产品当天就能吃到红利。另一位开发者泼了更冷的工程冷水:agent最不值钱的,就是用来补LLM缺陷的那些东西,每次模型迭代都会消灭一批,最后剩下的窄带,模型公司几乎一定会自己做。知乎知乎
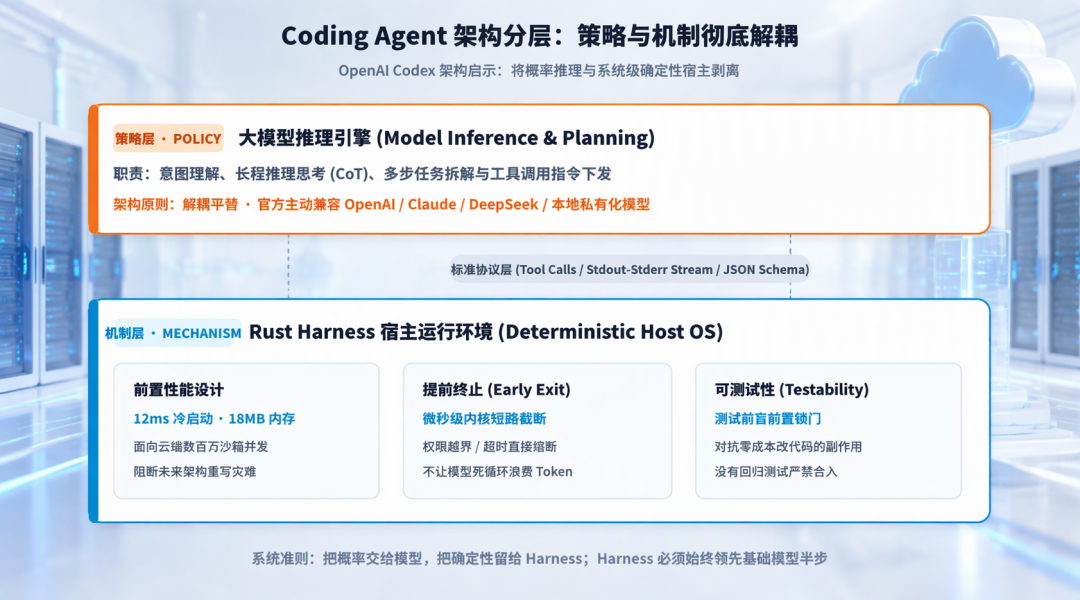
所以真要给出选择建议:写harness,默认TypeScript,直接省掉一轮纠结,除非你要向系统要纵深。而把力气花在不会被模型迭代抹掉的地方,那份源码拆解给出的第一条启示最实在:上下文治理决定长任务上限。事件溯源作为自研架构默认项、安全默认值显式设定,同样值得直接抄进技术计划。知乎专栏
壳选语言,说白了就三问:谁来写、跑在哪、要追多快。TypeScript不是最强的语言,但它是这三问下最乖的那个。模型越来越强,壳越来越薄,选择反而越来越简单。


当前文章无评论,是时候发表评论了