九月的最后两周,AI 圈被一个"哑巴"刷屏了。它叫 Jev,9 月 15 日发布,不会聊天、不会写诗、不会写代码,一个字都不说。但就是这个闭源模型,让背后只有二十来号人的 TypeSafe 公司,估值在不到一个月里从 2 亿美元冲到 100 亿美元。Karpathy 专门下场分析,说它踩中的是"LLM 帕累托曲线上一个投资不足的区域"。36氪微博
6.4 万 star 的开源项目 ai-hedge-fund 把它接成了第 7 个可用的"决策大脑"。OpenAI 则在 9 月 30 日的 DevDay 上掏出对标的 Decisions API,官方演示里处理 1 万个请求比自家 Responses API 快 10 多倍。与此同时,知乎上一个 491 赞、78 条评论的回答冷冷地甩出一句"简直是本年度最烂炒"。知乎知乎知乎

一边是资本和巨头用脚投票,一边是技术社区当面拆台。这种撕裂感本身就在说明:Jev 值得认真看一次——不是看热闹,是看它跟你有没有关系。我把 36氪、知乎实测帖、微博 KOL 和开源社区的信息翻了一遍,帮你把账算清楚。
一、Jev 到底是个啥:把"判断"做成零件
先说清楚它是什么。Jev 是 TypeSafe 定义的"System One 模型"——名字取自《思考,快与慢》里那个不假思索的直觉系统。它的工作方式跟 LLM 完全不同:你给它一段当前状态(一条短信、一个网页 DOM、一份财报快照)加一组预设问题,它返回的是 Choice、Score 或 Boolean 这样的类型化答案,附带一个校准概率。没有解释,没有废话,程序拿到结果直接往下走。36氪

创始人 Diogo Almeida 是 OpenAI 前研究员,参与过 InstructGPT、ChatGPT 和 GPT-4 的研究。他的核心论点很冲:RLHF 是条"史诗级大弯路"——人类反馈把模型训练得越来越会取悦人,却离自动化越来越远。他的方案叫 RLCD(面向校准决策的强化学习),把"概率报得准不准"直接写进训练目标:模型说八成把握,长期统计下来就该八成正确。36氪微博知乎
连名字都在暗示野心——经济学里的"杰文斯悖论":一种技术越便宜高效,用量反而越大。36氪
这个"校准概率"是 Jev 最实用的设计。Agent 拿到概率就能自己设门槛:把握高的自动放行,把握低的转给大模型或转给人。它卖的不是"替你干活",是"帮你更准地判断"——最后那个发送键、确认键,永远留给人按。36氪
二、火的三笔账:快、便宜、踩中趋势
Jev 的火不是玄学,把账摊开看就明白了。
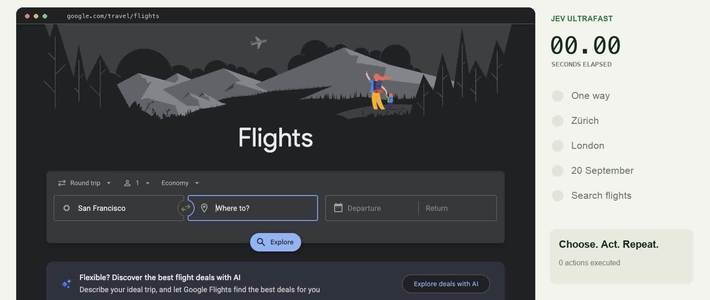
第一笔是速度账。开源项目 BrowserUse 的创始人拿 Jev 搭了个浏览器 Agent,在真实的 Google Flights 页面上查一趟苏黎世到伦敦的机票:全流程 7.1 秒,单次成本 0.0039 美元,Jev 在循环里的中位延迟约 178 毫秒。对比一下,让 GPT 或 Claude 操控浏览器,一个来回就是好几秒——网页上点按钮本质是个离散多选题,确实不需要 AI 会写诗。36氪

第二笔是成本账。Jev 输入约 0.042 美元/百万 token,输出永久免费。知乎有人用 7 个 benchmark 做了 Jev 对比 Qwen3-30b 的实测:准确率差距不大、个别项目还反超,但 Jev 平均响应 0.3 秒,LLM 要几秒到十几秒;整轮测试 Jev 只花了 2 美分,Qwen3 花了将近 5 块钱。官方宣传的"快 20-200 倍、便宜 40-400 倍",在第三方实测里能找到印证。知乎知乎微博

第三笔是趋势账。OpenAI 自己的数据显示,今年 2 月到 6 月,企业 Codex 周活跃用户在法律领域涨了 108 倍、销售招聘 41 倍、市场营销 26 倍。Agent 从写代码扩散到全行业,意味着模型调用从"一天几次"变成"一秒几次"——慢和贵成了行业共同焦虑。36氪
今年以来 Gemini 3.5 Flash、DeepSeek V4 Flash、Qwen3.8-Flash-Next、GLM-5.3-Flash 扎堆发布,Cursor 推出 Router、腾讯 WorkBuddy 上了 Auto 模式,全行业都在做同一件事:按任务复杂度给模型分档。Jev 只是把这个逻辑推到极端——把"判断"这一档单独切出来,做成一个模型。36氪
三、泼冷水:宣传里藏着的三道裂缝
但先别急着吹。反方证据同样扎实,而且大部分来自真金白银的实测。
裂缝一:对标对象偷换了。那个 491 赞的知乎回答戳得很准:任何判别式分类器都比自回归 LLM 快,Jev 声称的数百倍速度优势,对标的是 GPT 这类生成模型,而不是它真正的同类——带分类头的 Transformer Encoder(RoBERTa 那一挂)或者 Reranker。知乎
一个调好系统提示词、带上 logprobs 参数的快 LLM,理论上能完成 Jev 的大部分任务。换句话说,Jev 在架构上可能没那么新,新的是"零样本、免微调、类型安全"这个产品包装——而包装值不值 100 亿,是另一回事。知乎
裂缝二:概率没那么校准。RLCD 的卖点是"报得准的概率",但已有开发者测出:同一个判断正着问一遍、反着问一遍,Jev 给出的两组概率加起来有时超过 1。一个校准得当的系统不该这样。更要注意的是,"结构上不会幻觉"这句宣传有严格边界——schema 由构造保证,它不会返回格式错误的值,但完全可能返回错误的判断。知乎还有人拿开源替代 Kev(0.6B 底座 LoRA 微调)在诗歌知识图谱上做了 5 个决策任务的实测:域内任务微调后能到 0.9 以上,域外任务和需要实体知识的任务直接判不动——这是一把"领域内精排"的好刀,不是万能钥匙。36氪知乎知乎
裂缝三:壁垒可能不存在。Jev 至今没发技术报告,但发布两周,JevBench 榜单上第三方复现版已经逼近原版,参赛者基本都是个人和小厂。Together AI 开源的 tev1 演示了用 Qwen3.5-4B 加 3.8 万条样本,花 17 美元、25 分钟就能微调出一个 Jev 风格的分类器。斯坦福和 NVIDIA 也开源了 CLM。那篇知乎对比测试的作者下了个直白的判断:从社区复制的速度来看,这个模型应该没有太多技术壁垒,TypeSafe 单纯是发现了一个业界盲区的好想法,并把它实现了。这直接引出那个扎眼的问题:二十来号人、无技术报告、复现遍地,100 亿估值撑得住吗?知乎微博知乎

所以网上那两个极端——“革命性"和"新马甲”——其实都吵偏了。这是两个问题:决策模型这个品类有没有价值?有,实测数据摆着。Jev 本身有没有独特性?存疑,壁垒看起来不高。把这两个问题分开,你的判断就清楚了。
四、跟你有什么关系:分人群说
如果你是普通聊天用户,指望它替代 ChatGPT 陪你写东西——不用看了,它一个字都不会说。微博评论区的真实反馈很说明问题:“送了 5 刀,这 5 刀用几个月都用不完”“暂时还没摸出更大用处”。它是给程序和 Agent 用的零件,不是给人用的产品。微博
如果你是开发者或在搭 Agent,现在确实是上手窗口。Jev 已向所有人开放注册(console.typesafe.ai),无等待列表,新用户送 5 美元额度、约合 1.2 亿 token。有评论区反馈国内手机号收不到短信验证码,遇到问题可以先备一个海外号码或邮箱方案。$5 额度建议这么花:别拿它聊天或做开放任务,专挑 Agent 循环里的高频判断点——意图路由、内容分类、工具风险拦截、rerank、置信度分流。低置信度转大模型、高置信度直接放行,这套分流架构才是它的正确打开方式。两个坑提前说:一是不同模型的概率不互通,从别的模型迁移过来必须重新校准阈值;二是先在自己的标注数据上跑一遍,别信任何榜单的通用分数。微博知乎

如果你的团队想生产环境用,或者预算敏感,替代方案已经够多了:Kev 开箱即用但比 Jev 差 4-5 个点,Laya 这类 encoder 小模型 zero-shot 接近随机、必须用自己的标注数据微调。另一个变量是 OpenAI 的 Decisions API——第三方测试显示准确率比 GPT 5.6-Luna 略高、价格比 Jev 贵,目前还是受限预览。如果你在 OpenAI 生态里已经很深,等它全面放开再切换,可能比自己引入一个新供应商更省事。知乎知乎
五、接下来盯什么
Jev 这轮爆火,真正的信号不是那 100 亿估值,而是行业开始承认:Agent 时代,"判断"和"生成"是两种生意。这个方向上值得继续盯四件事:OpenAI Decisions API 何时全面放开、定价怎么打;TypeSafe 会不会补发技术报告;Benchmarkheaven/JevBench 榜单上复现版和原版的差距变化;以及那些"复现版逼近原版"的小厂里,会不会跑出下一个搅局者。
回到开头那个撕裂的画面:资本押的是"品类",知乎骂的是"溢价",两边其实都没说错。对你来说,结论可以很简单——品类值得关注,$5 额度值得花,100 亿估值不值得信。哑巴模型不会说话,但账单会。










