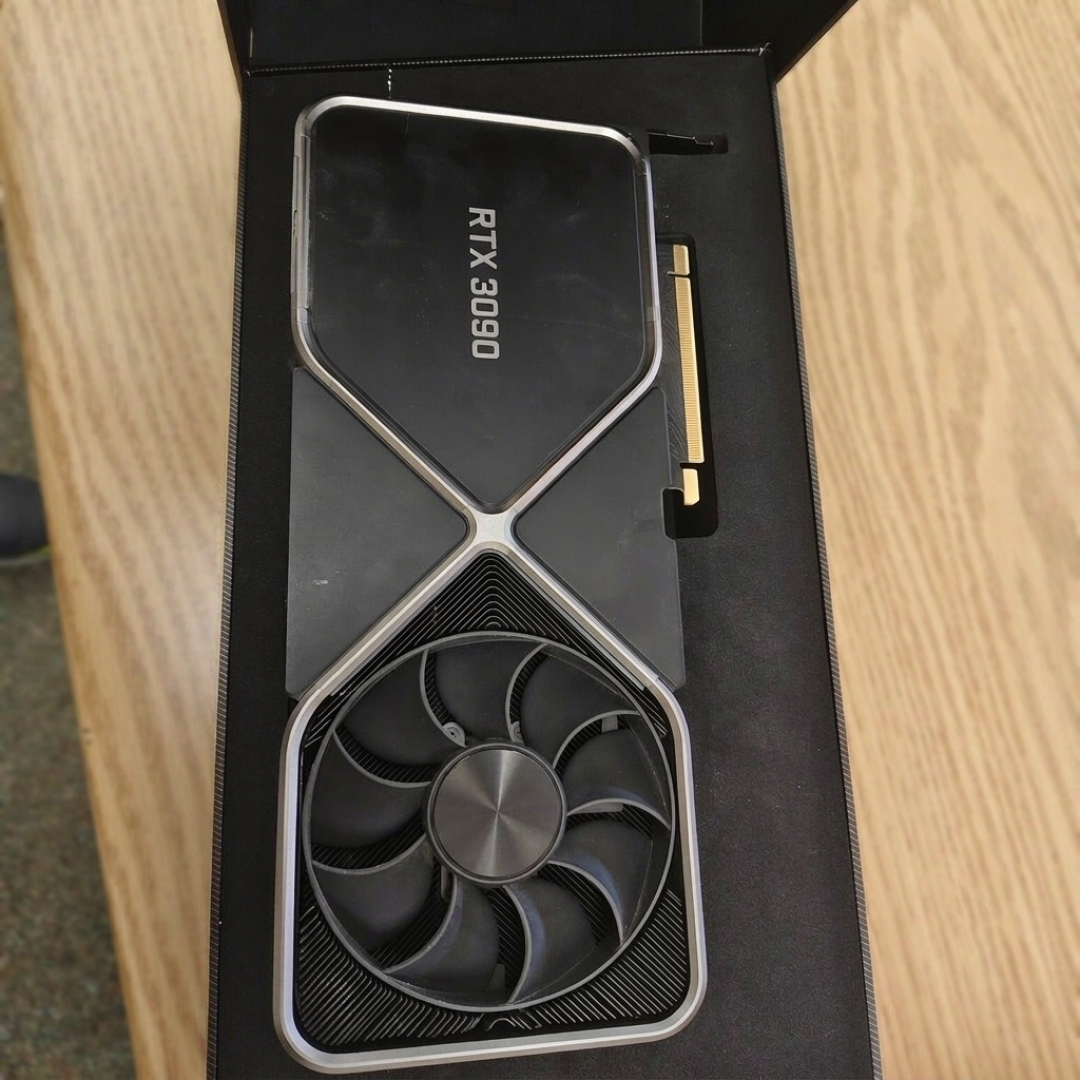
这个十月,想买显卡的人听到的都是坏消息:5090半年里从2万被炒到5万多,5080从首发8000元一路涨到1.7万。但对已经握着老卡的人来说,好消息从另一个方向来了——一个开源项目,把RTX 30/40系显卡里被锁住的AI算力,免费掏了出来。微博微博
发生了什么
10月下旬,GitHub用户Zagitta发布了gpu-unlock:一个1800多行的Linux内核模块。实测数据相当扎眼,RTX 3090 Ti的BF16矩阵吞吐从87.5 TFLOPS涨到157.4,提升接近80%;4090的FP16吞吐从165.6冲到331.6,六天之内,社区又先后移植出Ada(40系)和Turing(20系)分支。连Windows移植版都出现了。哔哩哔哩哔哩哔哩哔哩哔哩哔哩哔哩
英伟达锁的到底是什么
不是散热,不是驱动,是固件里写死的配置。哔哩哔哩
英伟达GPU内部的Tensor Core有一组叫Speed Selector的寄存器,控制矩阵运算指令的发射速率。按官方GA102架构白皮书,3090在FP16累加下标称约142 TFLOPS,换成FP32累加就只剩71——刚好砍半。而AI训练和推理最常用的BF16混合精度(BF16做乘法、FP32做累加),恰好走的就是这条被砍半的路径。同芯片的数据中心卡不受此限制,等于同一颗芯,游戏卡只放行一半算力。哔哩哔哩知乎
这组寄存器还受PLM权限机制保护,拿到Linux内核权限也改不动。gpu-unlock的路子是借助英伟达安全固件(SEC2)里一个缓冲区溢出漏洞,先抢到寄存器写入权限,再把速率档位改成全速。整个过程发生在官方驱动加载之前,完成后做一次PCIe复位,交还原版驱动接管,不刷VBIOS、不改驱动文件、重启即还原。知乎哔哩哔哩
谁能受益,谁可以划走
别急着欢呼,这80%有明确的边界:
能受益:重度依赖BF16/FP16矩阵运算的任务。按项目README的数据,LLM Prefill、模型微调、部分图像生成任务提升约25%~55%。有4060 Ti 16GB用户实测ComfyUI出图明显变快。知乎哔哩哔哩
不受益:逐Token的LLM解码基本没动静,瓶颈在显存带宽不在算力;跑量化模型的收益也不大。至于打游戏——解锁的是AI矩阵运算路径,和图形渲染无关,游戏帧数不会因此变高。
成熟度:30系(GA102~GA106)支持最成熟,20系、40系仍是实验性,Ada分支17个型号里有15个还要精确匹配PCI地址。哔哩哔哩
冷水还是要泼
这是非官方项目,核心依赖固件漏洞——英伟达后续一纸补丁就可能让它失效。项目issue里也有"日志显示解锁成功、实测却没有提升"的反例,Windows移植的成熟度更低。固件级操作是否影响保修,各品牌口径不一,动手前想清楚,别拿生产环境的机器冒险。哔哩哔哩
为什么这件事值得在意
放在平时,这只是极客圈的谈资;放在2026年10月,意义不一样。新卡买不起,二手老卡被AI需求越推越贵,一个免费的25%~80%算力提升,等于给存量老N卡集体续了一次命。对靠消费级显卡跑本地模型的小实验室和个人开发者来说,这是今年最实在的"双十一优惠"——只是这个优惠有门槛:你得用Linux,还得愿意折腾。