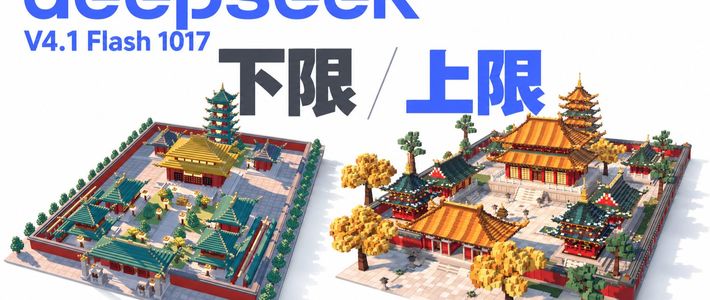
10月17日,DeepSeek把V4.1 Flash升级到V4.1-Flash-1017,网页端、App、API三端同步更新,API调用方式和价格表都没动。模型权重同步开源,MIT许可,HuggingFace和ModelScope都能下载。官方把这次升级定性为“性能-费用的帕累托改进”。而社区真正吵起来的不是官方跑分表,是一场“上下限”双盲测试:同一个模型、同一道题,有人跑出接近旗舰水平的成品,有人连及格线都没够到。 这面镜子照出的格局是:AI的下一段赛程,比的不再只是上限——谁给出最聪明的一次回答,而是谁先把下限抬起来,把活干完、还得又稳又便宜。知乎知乎哔哩哔哩
“上下限测试”出自B站UP主“无机酸-_-"与社区“亿模亿样”做的AI前端/3D能力基准:题目相同,产出结果上传后盲评对比,排行榜来自社区双盲投票。发布当天的横评被作者冠以“前端能力世一Flash”;次日,作者又发了专门一期“上下限”,标题是:依旧神神鬼鬼?哔哩哔哩
社区对这台模型上限下限的观感相当一致:上限对Flash级模型而言“吓人得不行”,而下限,用一条典型评论的话说,“已经把glm5.3这种老东西全一脚踹飞抬走了”。哔哩哔哩
但两者的落差依旧大得离谱,“神鬼二象性”还没消失。测试者也先泼了冷水:他只测了前端,不代表其他方面也很突出,指令遵循仍是Flash类模型难解决的通病。哔哩哔哩
更值得玩味的是,测试本身也被“刷”了:作者发现1017被离谱地投到榜单第二,分析后认为不少人多轮试跑后只上传最好的一次,还有人没认真左右对比就草率投票。 当模型能力开始逼近,评测的公信力自己成了新的战场。哔哩哔哩
官方数据与社区体感同向:涨在执行,输在知识
官方口径里,1017对比9月版11项基准全部上涨,涨幅从2.0分到11.1分不等。最大一涨出现在最能代表“把活干完”的测试上:Terminal-Bench 4.0从31.2跳到42.3,一次拿了11.1分。知乎知乎
反过来读官方的另一句话:“在4项agentic测试中超过Claude Opus 5”,意味着11项里它输了7项,输的多是知识深度和复杂推理。知乎
差距最大的一栏考的是跨学科硬知识:HLE无工具成绩42.6,对Claude Opus 5的56.3,差了13.7分。知乎
为什么是这幅画像
这不是一次架构升级:官方配置文件与9月10日版本完全一致,7630亿总参数规模没变。变的是训练方式:官方把提升归因于基于自反馈的强化学习,让模型自己评判输出再迭代,重点补“从零开始构建完整项目”的能力。知乎知乎
模型结构也决定了能力边界:5520亿参数主干加上1960亿的Engram记忆模块,每处理一个token,输入阶段只激活约80亿、输出阶段约160亿——大存储、小激活。强化学习能教会模型把活干对,教不会它知道得更多,所以涨幅集中在执行类测试,知识型差距原地不动。DeepSeek的定位很清楚:不是最聪明的,是能把活干完、还特别便宜的。知乎
两处口径必须提醒。新版成绩注明Terminal-Bench 4.0用Claude Code框架测试、DeepSWE用Mini-SWE-V2框架测试,旧条目没有给出同样完整的框架说明,自比对要打折。知乎
还有个容易传错的细节:HLE括号里的44.0对应纯文本子集,不是整套题。而截至目前,还没有第三方榜单给1017版独立打分,以上全部是官方自报数据。知乎知乎
下一步卷什么:下限、任务成本、工具链
第一,卷下限。 行业稀缺的能力,已经从“跑出一版神作”变成“几乎不跑出鬼版”。官方这次的原话是:在提升性能的同时,缩短了模型的任务运行时间与输出长度,让用户以更低成本、更快速度完成任务,在多个Harness下达到新的性能-费用帕累托最优。少绕几轮、少说废话,上下限的差距就从两头被压缩。往后评判新版本,优先问“上下限差距多少”,而不是“榜单第几”。哔哩哔哩
第二,卷任务成本。 模型价格表纹丝未动:Flash每百万输出token,空闲时段4元、高峰时段8元。卷的不是每token单价,而是“完成一个任务”的总账单——包括返工和验收花掉的人力。知乎
同一天开放的Search和Fetch两个搜索接口,定价每1000次成功请求5元(约0.75美元),失败、无结果、超时均不计费,11月1日起正式收费——此前在Harness、Claude Code、Codex里经服务端工具调用一直免费的那部分联网能力,从这天起也要花钱。36氪
横向比价更有火药味:Tavily按量付费约8美元/千次,BraveSearch和GoogleCustomSearch约5美元/千次,DeepSeek大约是主流海外方案的一折到两折。据字母榜报道,新版发布两小时内就有海外产品经理实测,称其找BUG、修BUG的能力接近Opus 5.5 xHigh,价格只有对方的三十五分之一。36氪知乎
第三,卷工具链。 模型上限再高,联网搜回来一半是垃圾,交付下限照样保不住。DeepSeek把自研搜索引擎开放成API,并针对DeepSeek Harness、腾讯CodeBuddy、WorkBuddy等框架做了专项优化,还建议把Harness升级到0.2.1-rc.1以上。打包给普通用户的产品形态是“许愿式编程”:一句话需求,模型自己拆解任务、写码、验证、交一个跑得起来的成品,官方演示包括故宫3D建模和用Godot引擎复刻《传送门2》。有B站作者用1017全程代码渲染做了一支MV,耗费4.56亿token、31.62元。从模型权重、执行框架到搜索与信源,模型公司开始沿着Agent技术栈一层层往下吃。知乎知乎哔哩哔哩
下限的另一半:服务的下限
坏消息和好消息要放在一起读。10月15日早上8点后,DeepSeek网页和App陆续显示“服务器暂时不可用”,中断近五个小时,API同样受累。当天傍晚,开放平台发布《服务恢复及补偿通知》,按账号10月8日至14日的消耗金额以赠金形式全额返还,扣费先抵赠金。36氪知乎
这并非偶发:仅9月以来,官方状态页就记录了13起故障,全年粗略计算已宕机约18次。36氪
钱并没有少花:据36氪报道,DeepSeek已经历两轮超过500亿元的融资,估值冲到5000亿级别。模型的神鬼二象性是训练问题,服务的频繁掉线则是工程和算力问题——“下一步卷什么”的答案里,还包括真金白银卷稳定性:返现式补偿、堆算力、扩工程团队。36氪
换不换:先拿自己的任务跑一遍
已经在用deepseek-flash的用户,新版自动生效,价格未动,没有不用的成本。但别因为跑分就把旗舰模型整体换掉:写码、Agent流程、前端生成这类执行任务是1017的舒适区,深度知识问答和复杂推理仍是旗舰模型的领地。更稳妥的做法,是挑几项自己项目里真会发生的任务,保留旧版的结果、耗时与费用,新版跑一遍再比——上下限差距有没有真收窄,账单和返工量会说实话。接下来值得盯两件事:一是社区等待中的V4.1 Pro,能不能补上“知道更多”的短板;二是11月1日搜索接口开始计费后,真实调用质量撑不撑得起“世一Flash”的榜单口碑。













