

给 ComfyUI 挑显卡,标准其实就一条,显存。
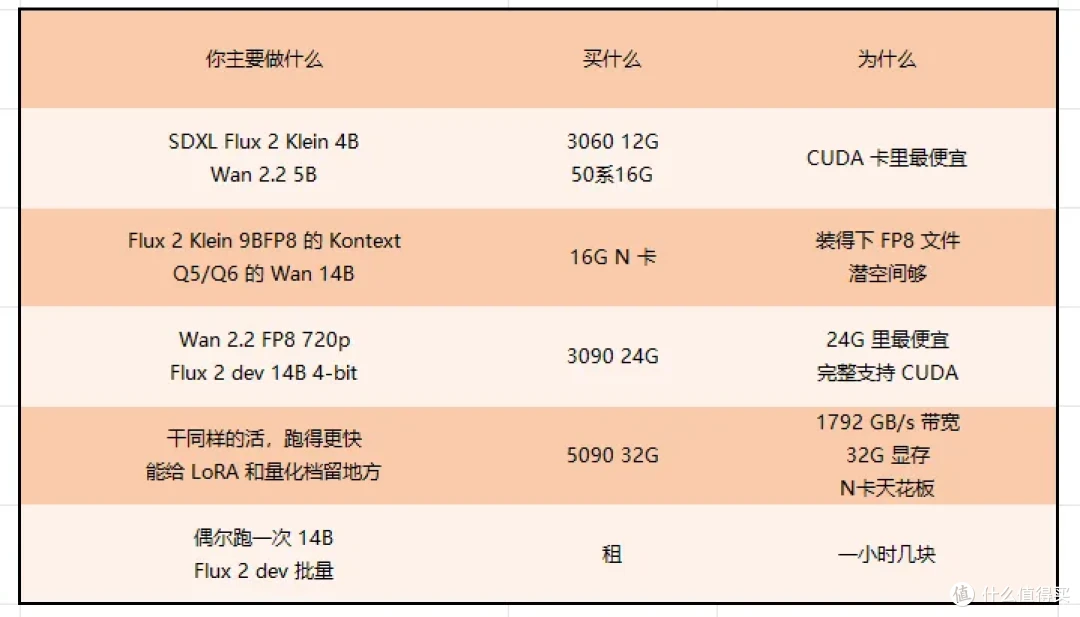
SDXL 和 Flux 2 Klein 在 12G/16G 上很舒服。
Wan 2.2 14B 和 Flux 2 dev 得 24 G。
FP8 和 FP16 得专业卡,5090 32G 也装不下。
按预算和用途选
 图片
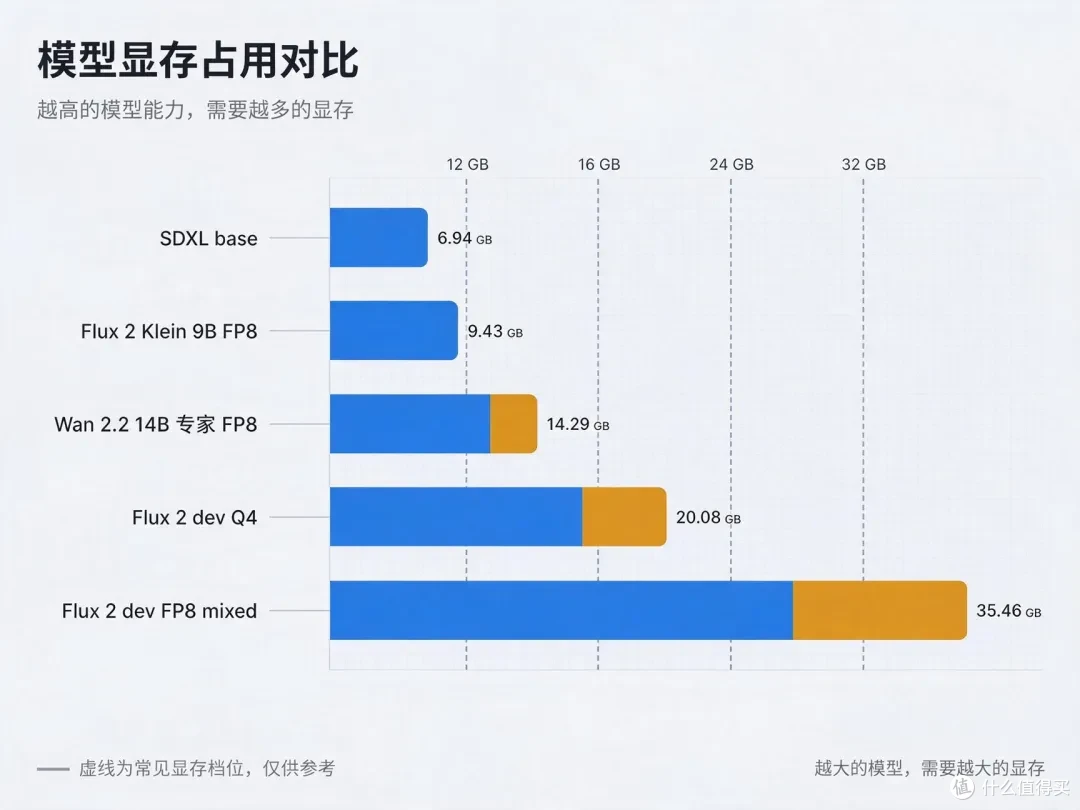
显存占用
 图片
一个 ComfyUI 工作流会先加载扩散模型,再加载文本编码器,还有 VAE,然后一个阶段接一个阶段地跑。
每跑一个阶段,ComfyUI 就在系统内存和显存之间来回倒腾它们。
所以峰值显存占用 ≈ 体积最大的单个模型 + 潜空间占用的显存。
潜空间占用的显存,会根据画面分辨率,如果是视频还有帧数,随之增加。
如果模型装不下,ComfyUI 就从系统内存里,按层流式加载。
官方文件里说,4G 显存 + 8G 内存,也能跑。
能跑是能跑,但每次采样,都得从内存里来回倒腾,这就增加了不必要的数据传输时间了。
所以说呀,一张算力慢,但是能装下完整模型的卡,肯定比算力高装不下模型的卡快。
余量算法
 图片
先搞懂两个单位。
Hugging Face 报文件大小,用的是十进制 GB(1 GB = 1,000,000,000 字节)。
显卡厂商标显存,用的是二进制 GiB(1 GiB = 1,073,741,824 字节)。
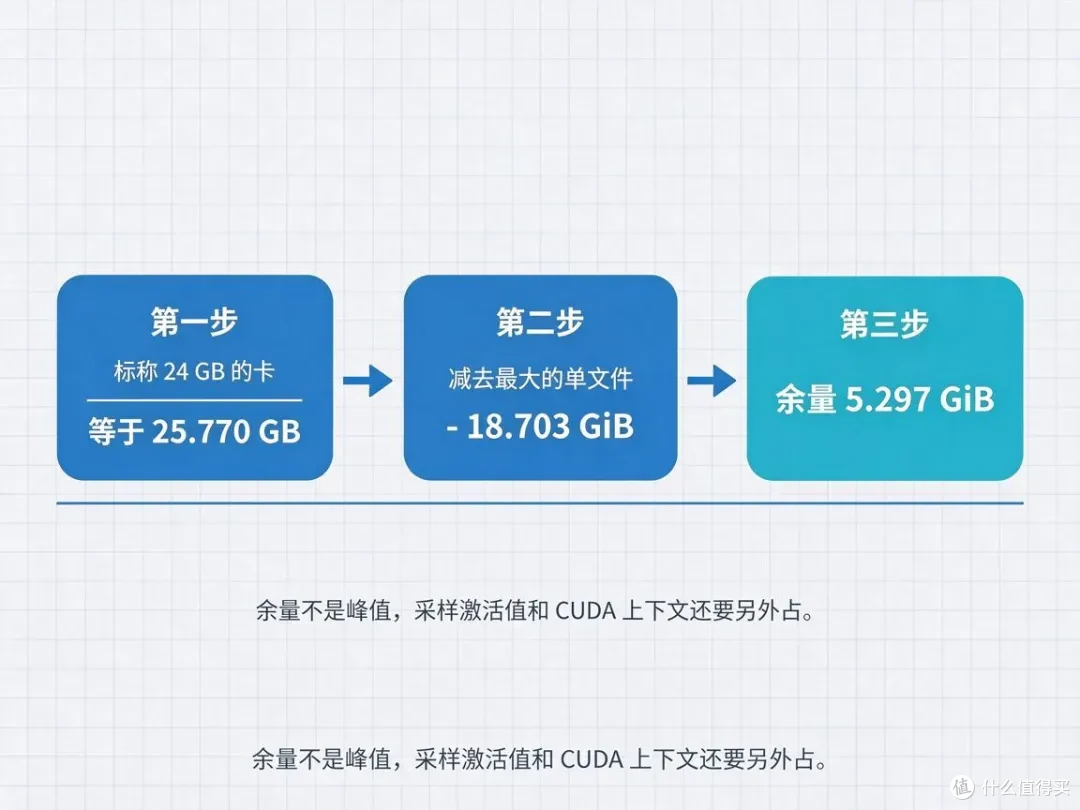
所以一张标 24G 的卡,实际装的是 24 × 1,073,741,824 = 25,769,803,776 字节,换成 Hugging Face 的口径就是 25.770 G。
英伟达的白皮书把 3090 写成了 24,576 MB,也就是 24 × 1024 MiB = 24 GiB
下面 8、12、16、32 G 的卡,全按这套 1024 进制算,扣掉权重之后的剩余显存是:
GiB 计的余量 = 标称 GiB - (文件字节数 ÷ 1,073,741,824)
这个余量,只是当前扩散模型文件,塞进去之后还剩多少,不是实测峰值。
采样时的激活值、CUDA 上下文、桌面显示,都还得从这点余量里分。
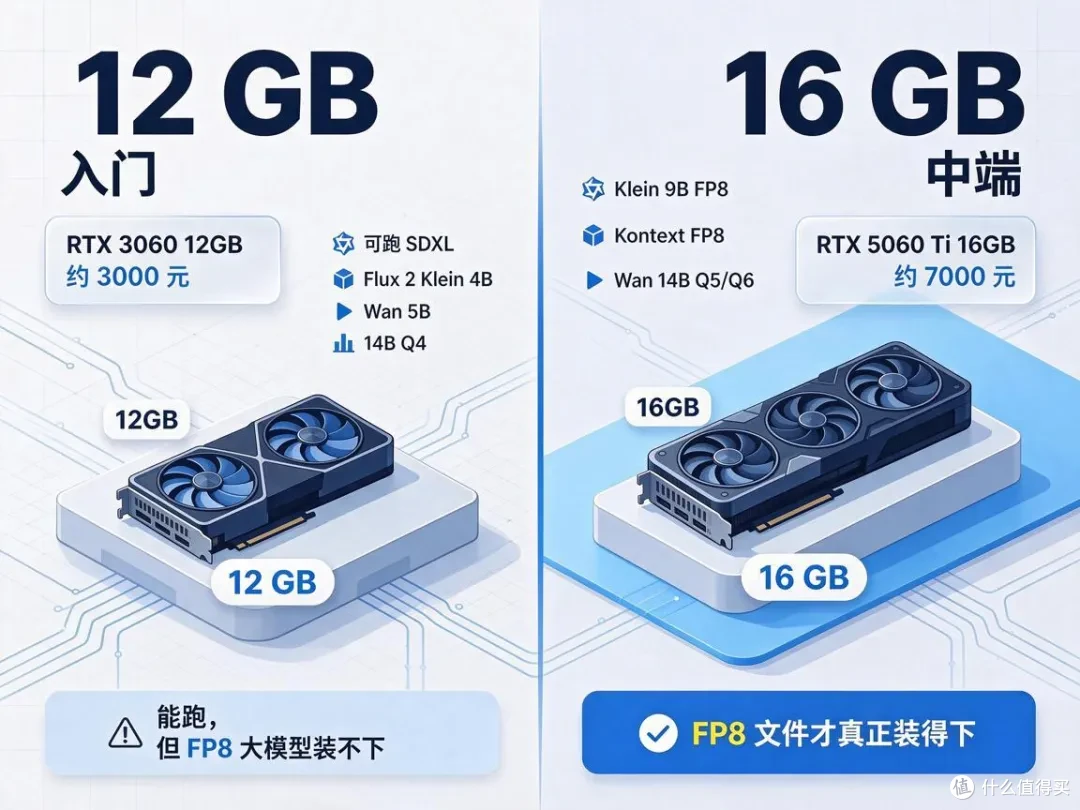
12G、16G
 图片
这个档位能出图。
SDXL 的 6.462 GiB 整合权重文件,在 12G 卡上余 5.538 GiB。
Flux 2 Klein 4B 走 FP8,哪怕是 8G 也余 4.209 GiB。
Klein 9B 走 FP8,12G 上余 3.215 GiB、16G 上余 7.215 GiB,不过那个 8.070 GiB 的 FP8 文本编码器,在 16G 卡上还是得换出去。
Kontext 走 FP8 要 16G,余 4.913 GiB,12G 上就用 6.456 GiB 的 Q4_K_M GGUF。
视频其实也行。
Wan 2.2 的 5B FP16 文件是 9.313 GiB,8G 卡必须卸载,这就是 ComfyUI 文档里那套配置。
14B 模型得上 GGUF 量化,Q4_K_M 在 12G 上余 3.013 GiB,Q6_K 在 16G 上余 4.822 GiB,13.312 GiB 的 FP8 专家,在 16G 上,只剩 2.688 GiB,建议做 480p 视频。
至于选 12G 还是 16G,直接决定 Klein 9B 和 Kontext 是能走 FP8,还是得降到量化档。
16G 的卡里,5060 Ti 16GB、5070 Ti、5080 能装的模型都一样,区别只是谁快谁慢,谁先跑完。
12G 和 16G 的区别,就在 FP8 文件装不装得下。
性价比卡:5060 Ti 16G
适合:SDXL、FP8 的 Flux 2 Klein 和 Kontext,以及 Wan 2.2 5B 视频。
优点:
能装下 Klein 9B 和 Kontext 的 FP8 文件
448 GB/s、GDDR7
板卡功耗 180 W
缺点:
跑 Wan 14B 得用 Q5 或 Q6 量化
Flux 2 dev 只能 Q3 加卸载
嫌贵可以看看 3060 12G,能跑 SDXL、Klein 4B 和 Wan 5B,也能硬塞进 Q4 的 Wan 14B。
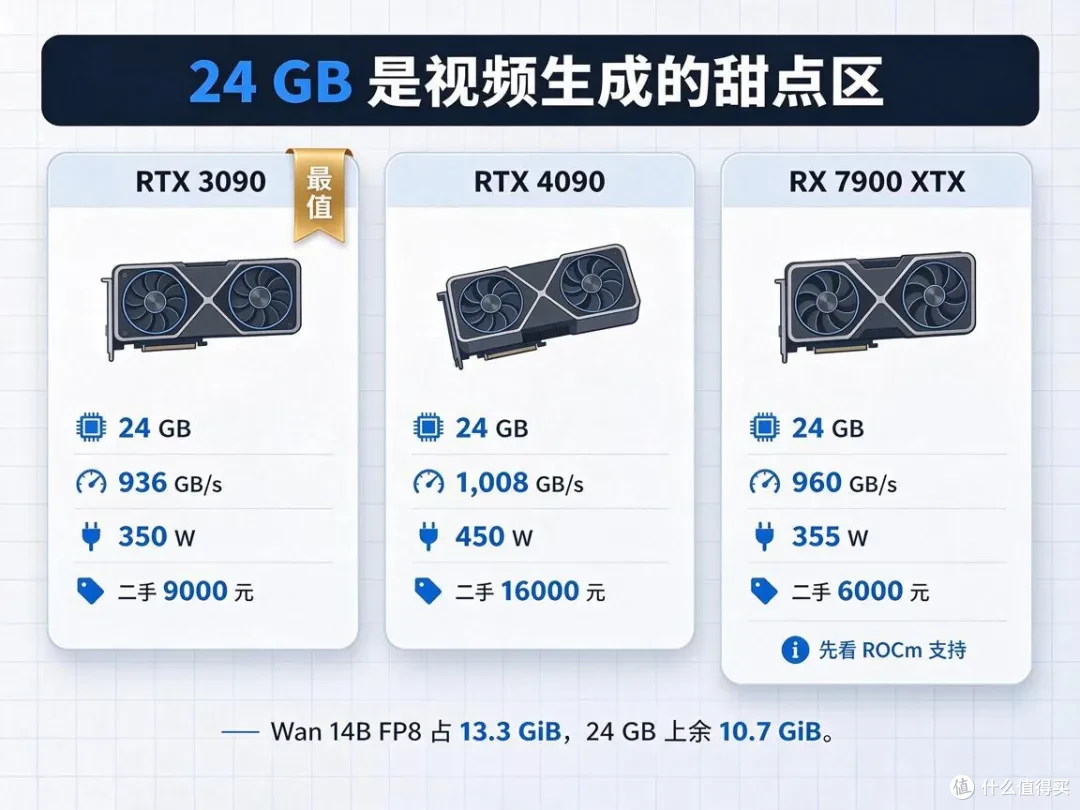
甜点档位:24G
 图片
这个档位舒服,余量更舒服。
Wan 2.2 14B 的 FP8 专家占 13.312 GiB,24G 上还留 10.688 GiB,够跑默认 81 帧的 720p,而且显卡里,每次只需加载一个专家模型即可。
Flux 2 dev 的 Q4_K_M 占 18.703 GiB,余 5.297 GiB,这是官方针对 4090 推出的 4-bit 方案。
Q5_K_M 就不行了,22.405 GiB 只剩 1.595 GiB,得上 5090 32G。
搞 AI 看的是显存跟带宽,3090 跟 4090 就差一点点,但是价格差下一倍了。
AI 视频卡:3090
适合:FP8、720p 的 Wan 2.2 14B,以及 4-bit 的 Flux 2 dev,而且所有 CUDA 自定义节点,都能正常用。
优点:
能装下 Wan 14B 的 FP8 专家,扣掉权重还剩 10.688 GiB
便宜
带宽 936 GB/s,接近 4090
缺点:
750W 电源
二手,怕矿
这卡太长
常见问题
显存多少好?
跑视频和 Flux 2 dev,24G。
跑图,16G。
想出图快和余量多,只能 5090 32G。
到底需要多大显存?
SDXL 和 Flux 2 Klein 4B 要 12G。
Klein 9B 和 FP8 的 Kontext 要 16G。
FP8 的 Wan 2.2 14B 和 Q4_K_M 的 Flux 2 dev 要 24G。
小卡上 ComfyUI 能卸载到系统内存,但是会很慢。
Q5_K_M 的 Flux 2 dev 在 24G 卡上只剩 1.595 GiB,有点紧巴,得 32G
哪张卡跑视频好?
24G 的卡。
Wan 2.2 14B 的 FP8 专家是 14,293,923,632 字节,也就是 13.312 GiB,而且只需要一个专家,所以还能余 10.688 GiB。
16G 就用 Q5 或 Q6 的 GGUF 量化。
8G/12 G 就用 5B 那个模型。
哪张卡省钱?
3060 12G
3000 块钱,能跑 SDXL、Flux 2 Klein 4B 和 Wan 2.2 5B。
A 卡能跑吗?
能。
ComfyUI 的文档里讲了 Linux 上的 ROCm PyTorch,也讲了 Windows 11 上的 ROCm 10.0,覆盖 RDNA2 到 RDNA4,包括 7900 XTX 和 9070 XT。
不过有些社区的自定义节点,默认你在 CUDA 上,用之前你得先确定好。
哪些模型要求 24G 显存?
FP8 的 Wan 2.2 14B
GGUF Q4_K_M 的 Flux 2 dev
24G 卡都很舒服。
Flux 2 dev 的 Q5_K_M 是 22.405 GiB,24G 只剩 1.595 GiB。
Flux 2 dev 的 FP8 mixed 文件是 33.021 GiB,5090 32G 也得卸载。
显卡太贵,买不起怎么办?
云租 GPU。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~
当前文章无评论,是时候发表评论了