

Wan 2.2 对显存的要求,说白了就两点,你选哪个模型,以及量化压得有多狠。
按 ComfyUI 的说法,5B 的 TI2V 模型,在 8G 显卡上就能跑。
14B 的文生视频和图生视频就得挑卡了,想舒舒服服跑 FP8 权重,还能留点余量,得上 24G 显存,要是硬塞进 16G、12G、8G 的卡里,就只能靠 GGUF 量化,再把一部分模型,卸载到内存里跑。
不同模型和量化对应的显存档位
模型文件大小,只是最低门槛,扩散模型跑起来,除了要装下权重本身,还得给视频潜空间,留出点运行显存,分辨率越高,帧数越多,这部分吃得越狠。
另外别忘了,显卡厂商标的是二进制容量,一张 16G 的卡,实际是 16GiB,换算成 Hugging Face 用的十进制,大概是 17.2 GB。
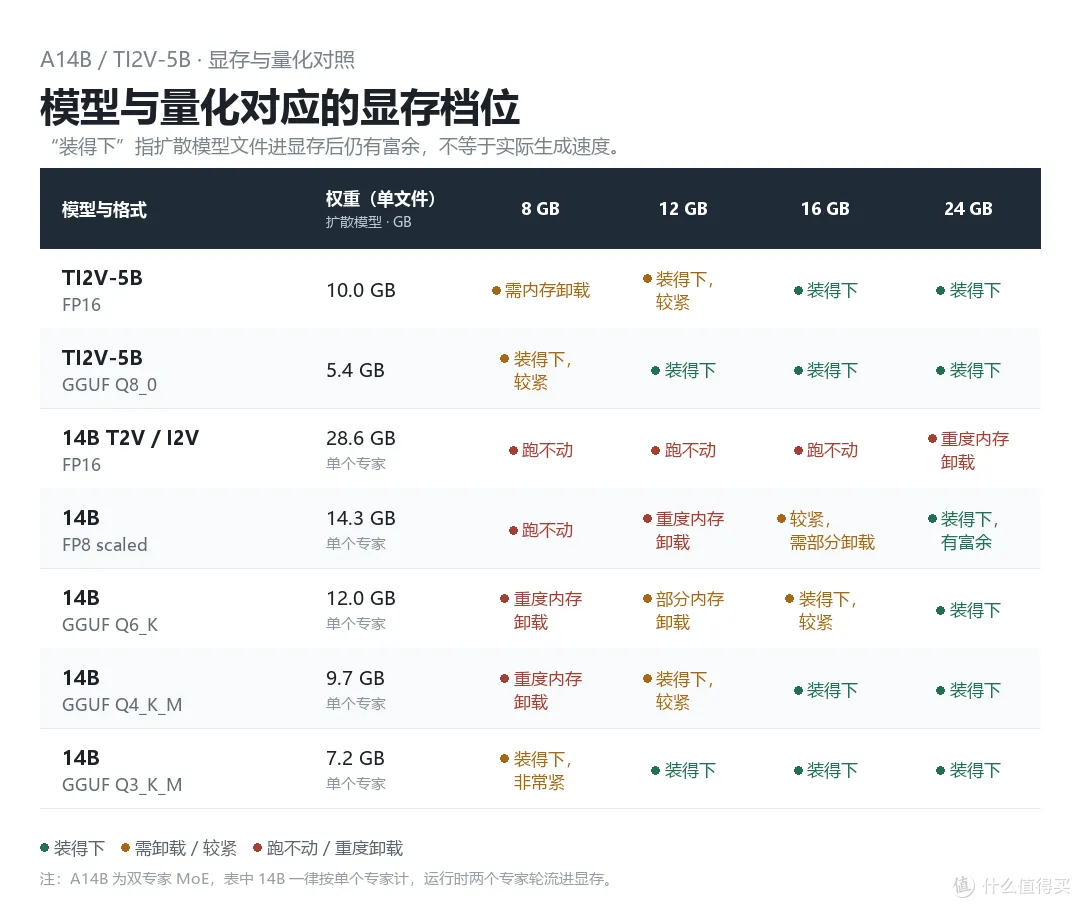
图里说的装得下,意思是扩散模型文件,塞进显存后,还能剩点富余。
文本编码器(FP8 版 6.7G)和 VAE 是在不同阶段加载的,ComfyUI 会把它们来回倒腾,进出显存,所以它俩主要占的是系统内存,对峰值显存影响没那么大。
目前主流是 480p,再配合 Topaz 星光锐利,放大分辨率。
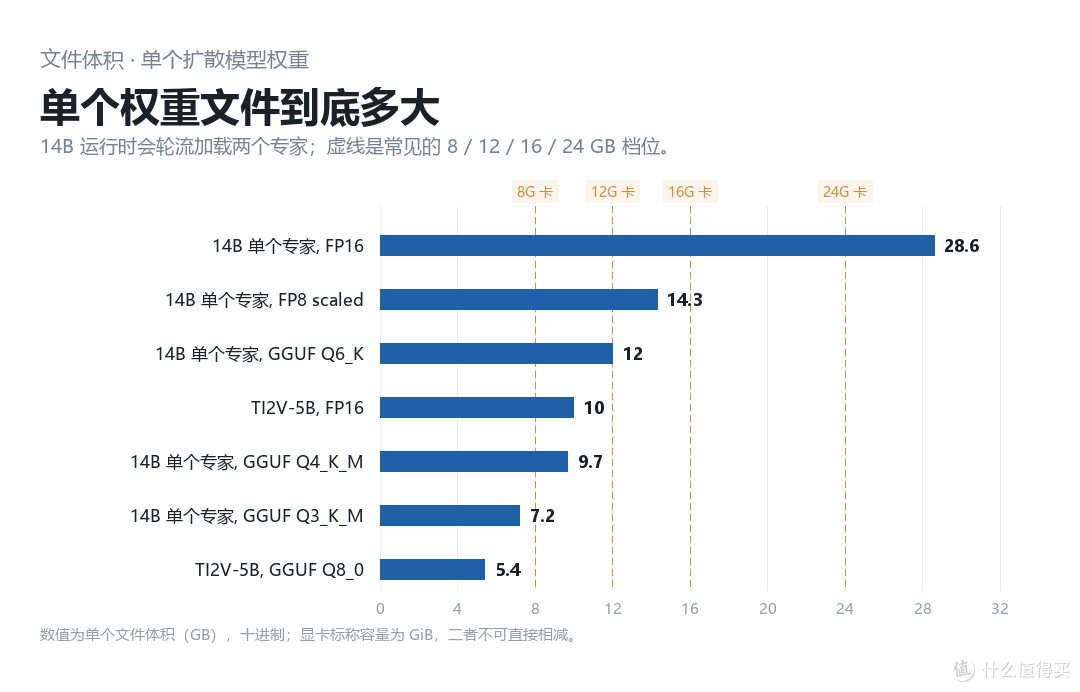
看数据对比就能发现,对 14B 模型来说,选对量化,比选模型更关键。
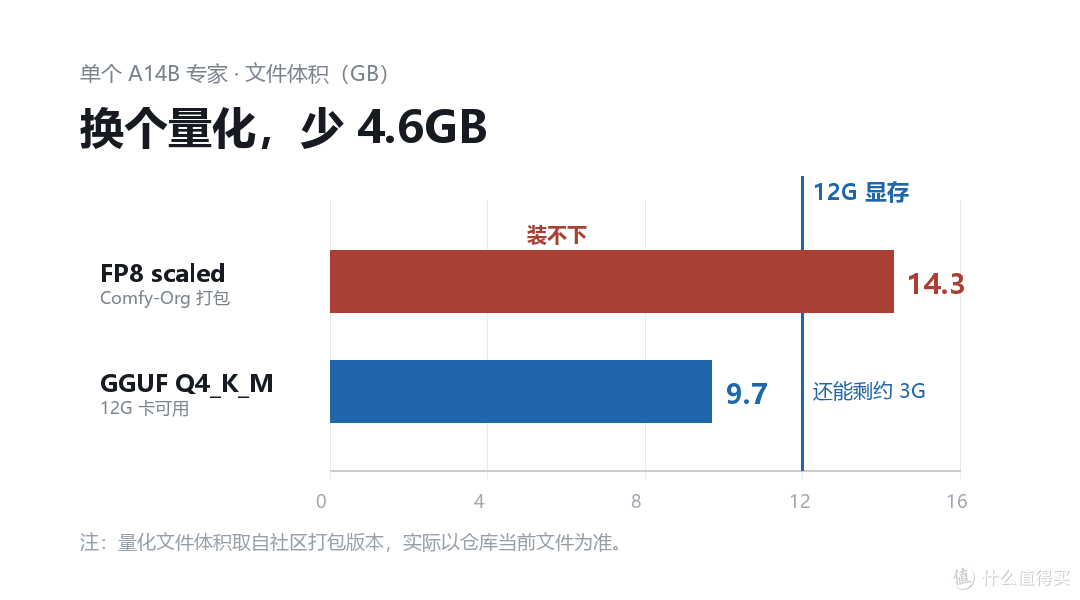
从 FP8 降到 Q4_K_M,单个专家模型,直接从 14.3G 缩到了 9.7G,在 12G 显卡上,这就是靠内存硬扛,和勉强能塞进显存的区别,文本编码器和 VAE 也占地方,配系统内存时,记得把它们算进去。
Wan 2.2 模型
主流的就三个:
TI2V-5B:单个 5B 稠密模型,文生视频和图生视频通吃,支持 720p、24fps,配了新的高压缩率 VAE,阿里说 4090 就能跑。
T2V-A14B:文生视频,支持 480p 和 720p。
I2V-A14B:图生视频,支持 480p 和 720p。
A14B 系列,用的是混合专家架构,每个模型里,都有两个大约 14B 参数的专家,高噪专家负责前期,把画面大框架铺出来,低噪专家负责后期,抠细节,加起来总参数是 27B,但每一步只激活其中一个 14B,按阿里的说法,算力和显存占用,跟单个 14B 模型,几乎没什么区别。
也就是说,硬盘和内存里,得存两份 14B 的文件,但显卡里只需要装一个,这也是为什么,我要按单个专家大小,来标的原因。
至于说怎么选,很简单。
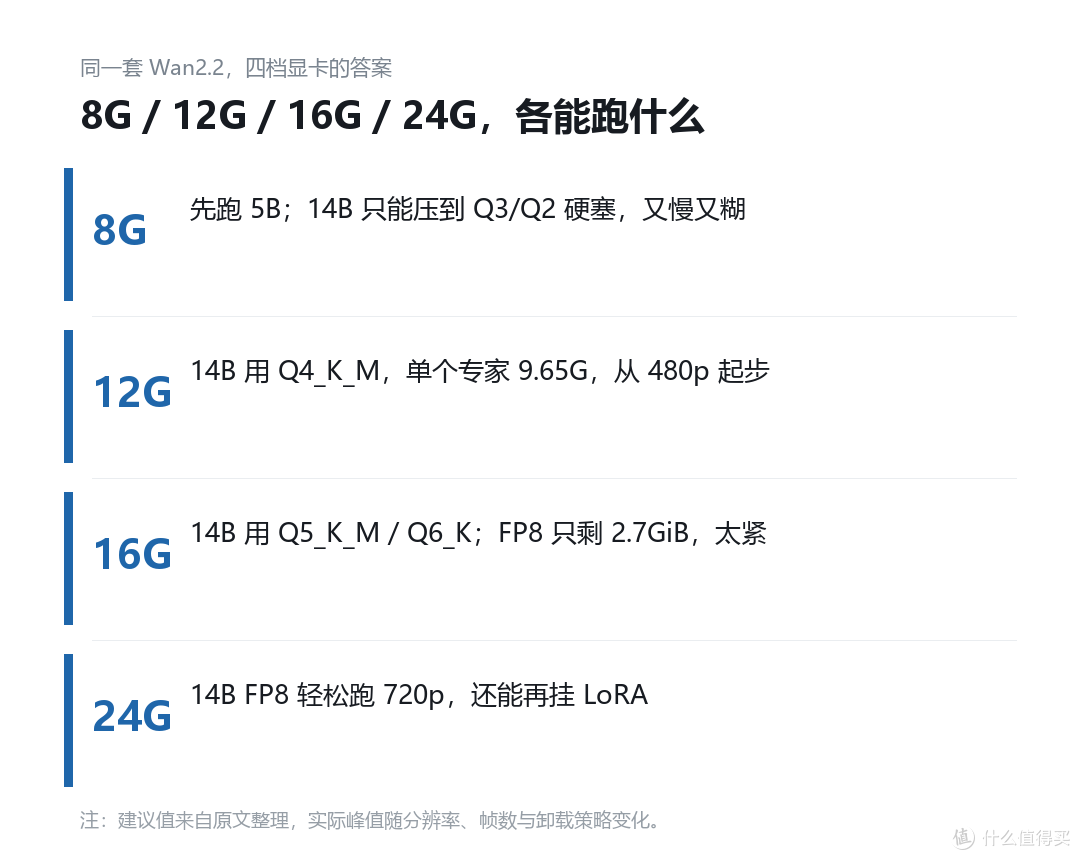
8G 或 12G 显存,选 5B。
在意画质,不在乎时间,手头有 16G 以上显存卡,直接上 14B。
阿里数据
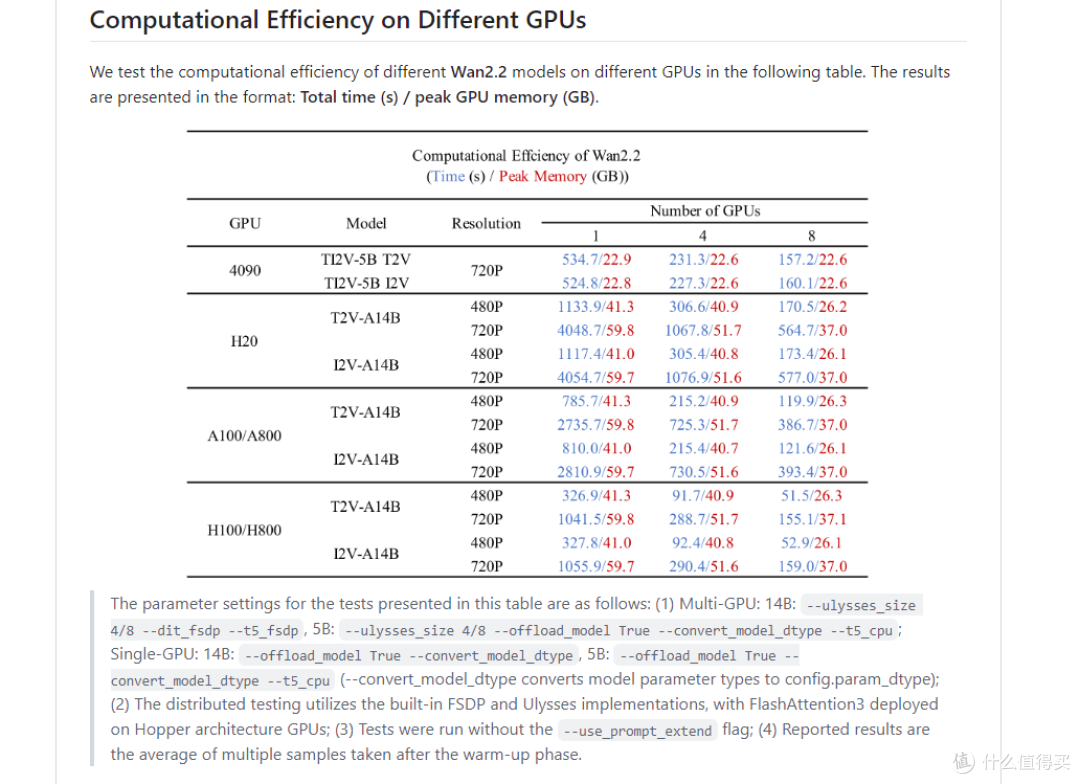
阿里给了一张单卡耗时,和峰值显存的测试表,用的是他们自己的参考脚本,不是 ComfyUI。
跑这些测试时开了 --offload_model True --convert_model_dtype(5B 模型还多加了 --t5_cpu),权重用的是 BF16。
图里写的单卡跑 14B 命令,至少要 80G 显存,跑 5B 要 24G 显存。
这里不是说非得 80G 显存才能跑,阿里图省事,用的是全精度权重,而 ComfyUI 支持加载 FP8 或 GGUF 量化权重,还能在内存和显存之间,按层流式传输,所以小显存卡,也能跑同一套模型。
不过阿里这张表里,有个数据很实用,同一个模型,从 480p 升到 720p,峰值显存从 41.3G 飙到了 59.8G,可见分辨率对显存的影响有多大。
8G 和 12G 显存
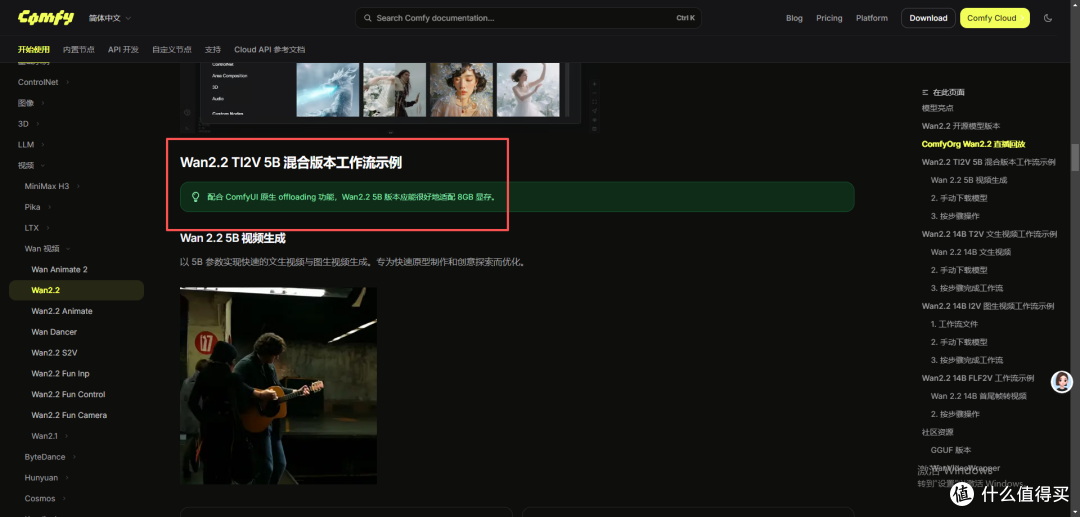
ComfyUI 的 Wan 2.2 教程写得很直白,配合 ComfyUI 原生的内存卸载,Wan2.2 5B 版本,应能很好的适配 8GB 显存。
官方工作流默认用的是 10G 的 FP16 文件,所以在 8G 卡上,会有一部分卸到内存里,要想完整的全塞进显存,可以用 QuantStack 出的 5B GGUF 版,Q8_0 是 5.4G,Q4_K_M 只要 3.4G,装个 ComfyUI-GGUF 节点就能加载。
至于在这两档卡上跑 14B,基本就是在折腾量化了。
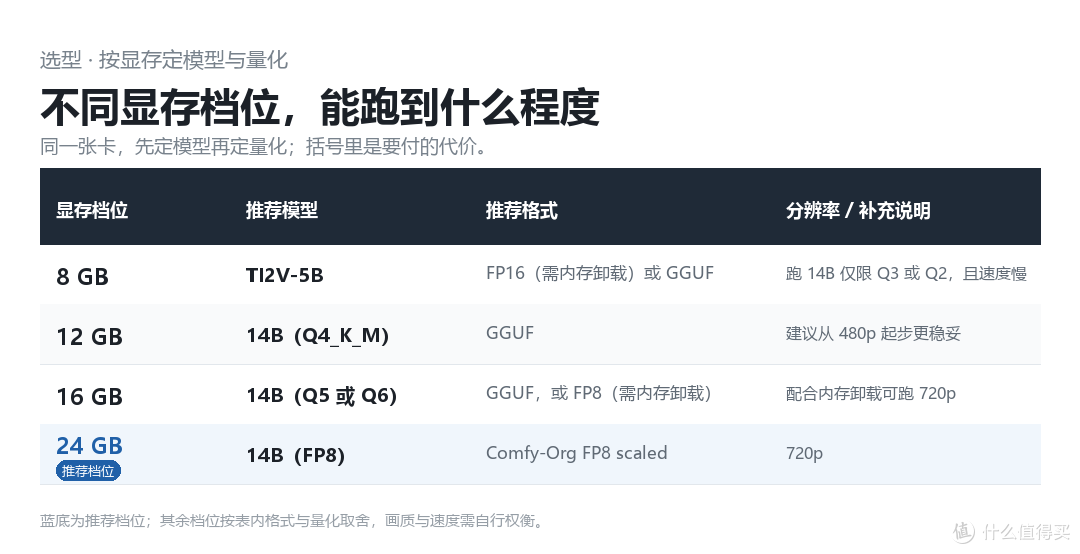
12G 显存:用 Q4_K_M,每个专家 9.65G,显卡还能剩大概 3G 给潜空间和其他开销。
建议先从 480p 短片开始,稳了再往上加。
8G 显存:Q3_K_M 是 7.17G 勉强能塞进去,Q2_K 是 5.3G,但量化掉到 4-bit 以下,画质会变的很差,而且 ComfyUI 大部分时间,都在来回倒腾权重。
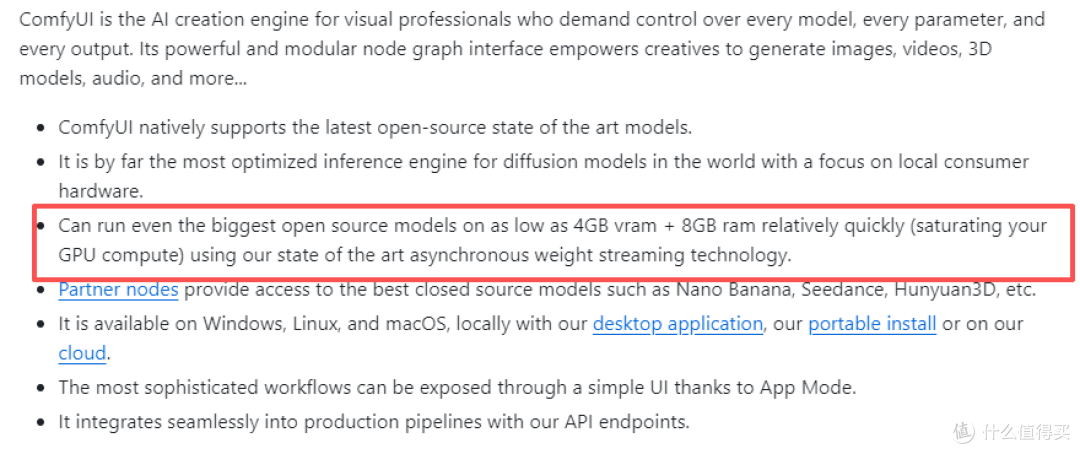
ComfyUI 的说明书里说,靠异步权重流式传输,哪怕是最大的开源模型,最低 4G 显存 + 8G 内存,也能跑得比较快。
卸载确实能跑通,但拿一张小卡,去硬拖 14B 模型,每一步都要花时间传数据,慢是免不了的,我建议是老老实实跑 5B。
16G 显存
Comfy-Org 打包的 FP8 scaled 专家文件,单个是 14.29G,换算成二进制大约是 13.3 GiB,塞进 16 GiB 的显卡里,还没算 CUDA 上下文、潜空间和系统占用的显存,就只剩 2.7 GiB 左右了,这点空间太紧巴,跑 720p,ComfyUI 肯定得把一部分网络层,挪到内存里,能跑是能跑,就是比全塞进显存的卡慢。
建议直接上 GGUF 的 Q5_K_M(10.79G)或者 Q6_K(12G),它俩比 14.29G 的 FP8 留给 720p 潜空间的余量多,Q6_K 的精度损失也小一点。
24G 显存
24G 显存装下一个 FP8 专家(13.3GiB)后,还能富余大概 10GiB,跑 720p 默认的 81 帧,非常轻松。
FP16 的专家文件,单个是 28.58G(26.6 GiB),24G 显存装不下,硬跑得走内存卸载,哪怕上 32G 的 5090,装完一个 FP16 专家,也就剩 5GiB 左右,跑 720p 照样不太行,说白了,想跑 FP16,得上工作站卡。
24G 显存还够你挂 LoRA,Comfy-Org 重新打包的 LightX2V 4 步加速 LoRA,每个专家对应一个 1.23G 的文件。
系统内存跟显存
显存塞不下的东西,全得放进内存里,要是内存也塞不下,ComfyUI 就只能一遍遍从硬盘里重新读,速度直接就掉沟里了。
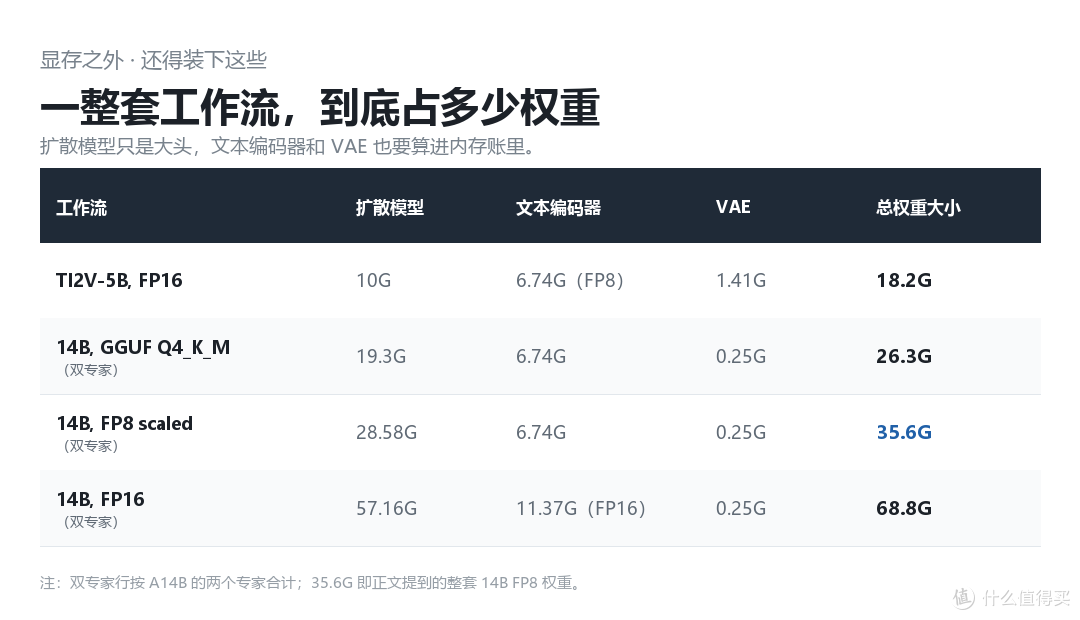
你的内存最好能装下全部模型权重,再加上操作系统和浏览器,算下来,跑 5B 模型或者 Q4 版 14B,建议 32G 内存起步,跑 FP8 版 14B,建议直接 64G。
ComfyUI 默认的缓存机制,是跟着内存走的,内存越大,从硬盘反复加载的次数就越少。
如果内存不够的话,启动时加上 --cache-none 参数,能让 ComfyUI 每次都重跑所有节点,拿时间换更低的内存和显存占用。
生成速度
采样步数:参考配置里,A14B 默认 40 步,TI2V-5B 是 50 步,挂上 LightX2V 的 4 步 LoRA 能直接砍到 4 步,但动态和细节会有一定损失,能不能接受,得拿你自己的提示词,试了才知道。
帧数:A14B 默认 81 帧、16 fps 差不多 5 秒,TI2V-5B 默认 121 帧、24 fps,帧数越少,潜空间占的显存和计算量就越小。
分辨率:按阿里自己的测试表,同一张 A100 上,跑 720p 的时间,差不多是 480p 的 3.5 倍。
内存卸载:只要模型有一部分塞不进显存,就得从系统内存里,往显卡里搞搬运,每跑一步采样,就得花一次传输时间。
所以说,现在买显卡,根本不是买性能,是买显存。
阿里说 TI2V-5B 不做特殊优化的情况下,4090 差不多 9 分钟,就能出一条 5 秒的 720p 视频。
当然了,前提你得有,或者能买得起。
常见问题
8G 显存能跑 Wan 2.2 吗?
5B 的 TI2V 模型可以,14B 模型在 8G 上,只能强行压成 Q3 或 Q2 的 GGUF 量化,再配合内存卸载,出来的片又慢又糊。
12G 显存够跑 Wan 2.2 14B 吗?
用 Q4_K_M 的 GGUF 版本够跑,单个专家 9.65G,还能留大概 3G 给运行显存,建议做 480p 配合 Topaz。
Wan 2.2 14B 跑 720p 要多少显存?
FP8 专家文件单个 14.29G,所以 24G 卡跑 720p 很轻松,16G 卡就得卸一部分到内存了,或者换 Q5、Q6 的 GGUF,阿里自己用 BF16 权重跑 720p,峰值显存飙到了 59.8G。
跑 Wan 2.2 需要多大内存?
得能装下你从显存,卸载出来的所有模型文件,一套 14B FP8 工作流,总共会牵扯到大约 35.6G 的权重,所以 64G 内存比较稳妥,跑 5B 或者 Q4 版 14B 的话,32G 内存就够用了。
Wan 2.2 14B 的两个专家,必须同时装进显存吗?
不用,高噪专家跑前半段,低噪专家跑后半段,同一时间显存里,只需要装一个,不过硬盘和内存里,得给它俩都留地方。
Wan 2.2 14B 单个专家文件多大?
FP16 约 28.6G,FP8 scaled 约 14.3G,GGUF Q6_K 约 12.0G,Q4_K_M 约 9.7G,Q3_K_M 约 7.2G。
14B 模型一共两个专家,跑的时候轮流加载。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~
当前文章无评论,是时候发表评论了