在AI大模型竞相追逐长上下文能力的当下,DeepSeek悄然完成了一次重大更新,将上下文长度从128K提升至1M。此次更新不仅意味着它能一次性处理《三体》体量的小说或上百页的PDF文档,更在实际应用中展现出强大的信息抓取与处理能力。本文将通过一系列实测,深入探究这一新模型在长文本理解、前端代码生成以及风格模仿等方面的具体表现。
 智能速览
DeepSeek新模型上下文长度提升至100万token,可处理超大规模内容。
在近百万字符的文本中,模型能精准定位并提取出指定信息。
模型具备出色的前端代码生成能力,可创建3D地球仪等复杂交互效果。
文学风格模仿能力出众,能驾驭古龙、鲁迅、红楼梦等多种文风。
此次为静默更新,官方尚未公布新模型的具体参数和命名。
 精华内容
为了验证DeepSeek新模型百万上下文的真实水准,同时探索其在其他维度的能力边界,进行了一次全面实测,涵盖了从信息抓取到创意生成的多个场景。
百万字符大海捞针
为测试长上下文能力,将一段包含特定信息(如账号全名、幸运数字、喜好等)的文本插入到一个长达2.53M字符(约89万token)的文档中。随后向模型提问,要求其根据全文内容回答这些特定问题。测试结果显示,模型不仅准确无误地回答了所有问题,其思考过程还清晰地展示了如何在大段文本中定位信息源头。这证明了其处理超长文本的稳定性和精确性,为构建个人知识库等应用提供了可靠支持。
前端代码实力展现
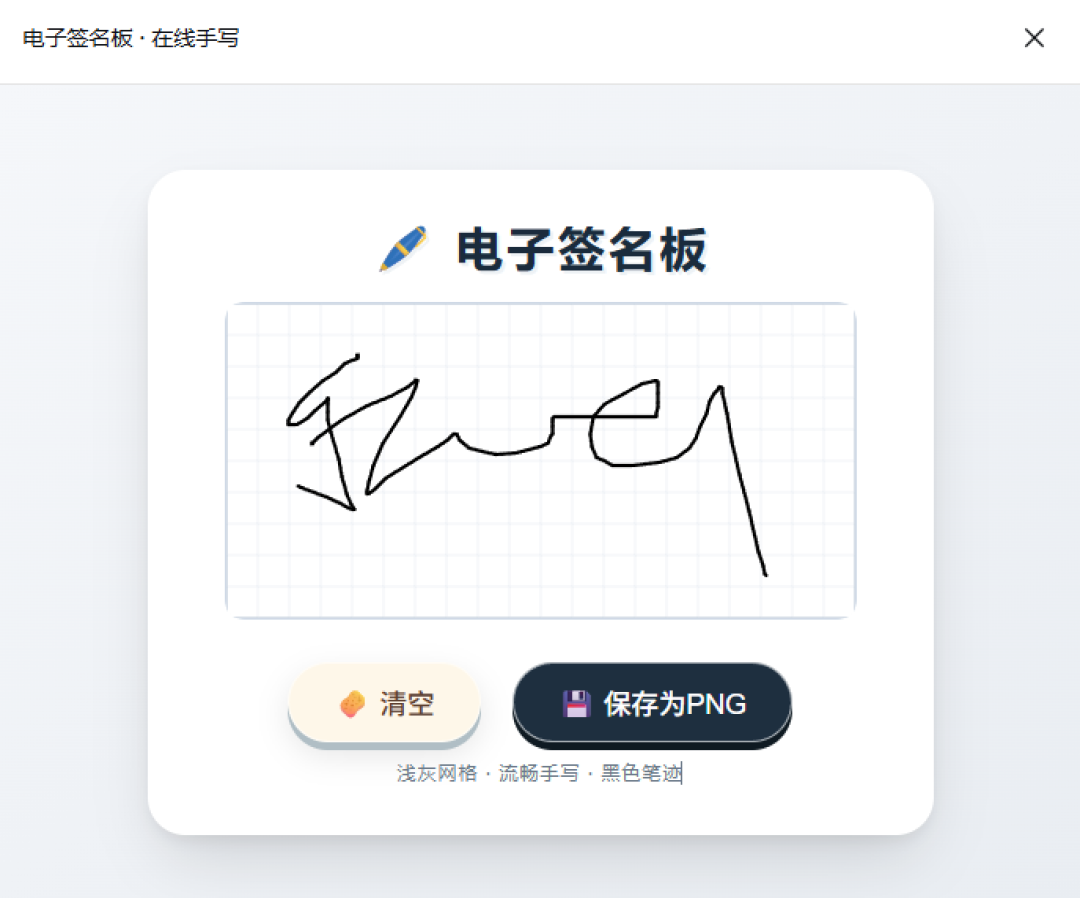
在代码生成能力测试中,模型被要求生成多个前端应用,包括一个使用Three.js的3D旋转地球仪、一个支持触屏的电子签名板、一个可拖拽排序的任务清单、一个带步骤进度条的注册表单以及一个响应式的产品展示页面。生成的代码不仅功能完整,逻辑清晰,而且视觉效果出色,尤其是3D地球仪的实现方案获得了高度评价。这表明模型在前端逻辑构建和界面设计审美上都有显著进步。
文学风格驾驭力
进一步测试了模型的语言风格模仿能力,要求它以古龙武侠、红楼梦和鲁迅三种截然不同的风格,各写一段约500字关于“程序员熬夜修bug”的文字。模型生成的文本在语言风格、叙事节奏、人物刻画和情绪渲染上,都高度贴合各文学流派的精髓。无论是古龙的冷峻对决,还是红楼梦的细腻描摹,亦或是鲁迅的深刻自省,都处理得恰到好处,展现了其对不同语境的深刻理解和强大的语言组织能力。