










 深耕数码、AI、游戏兴趣领域




19
23
RTX Spark笔记本浅析:128GB统一内存,1 PFLOPS,端侧AI的新篇章
2026-10-16 14:41:27
0点赞
0收藏
0评论
在微软Surface Laptop Ultra旧金山发布活动结束后的第二天,NVIDIA RTX Spark媒体编辑日在原场地展开。显然微软Surface Laptop Ultra只是RTX Spark笔记本的一道前菜,其背后将扩展出一个全新、独立、与众不同的Windows SoC新生态,NVIDIA x Microsoft的“NM”组合将会用行动告诉我们Windows搭配RTX Spark将会很有搞头。
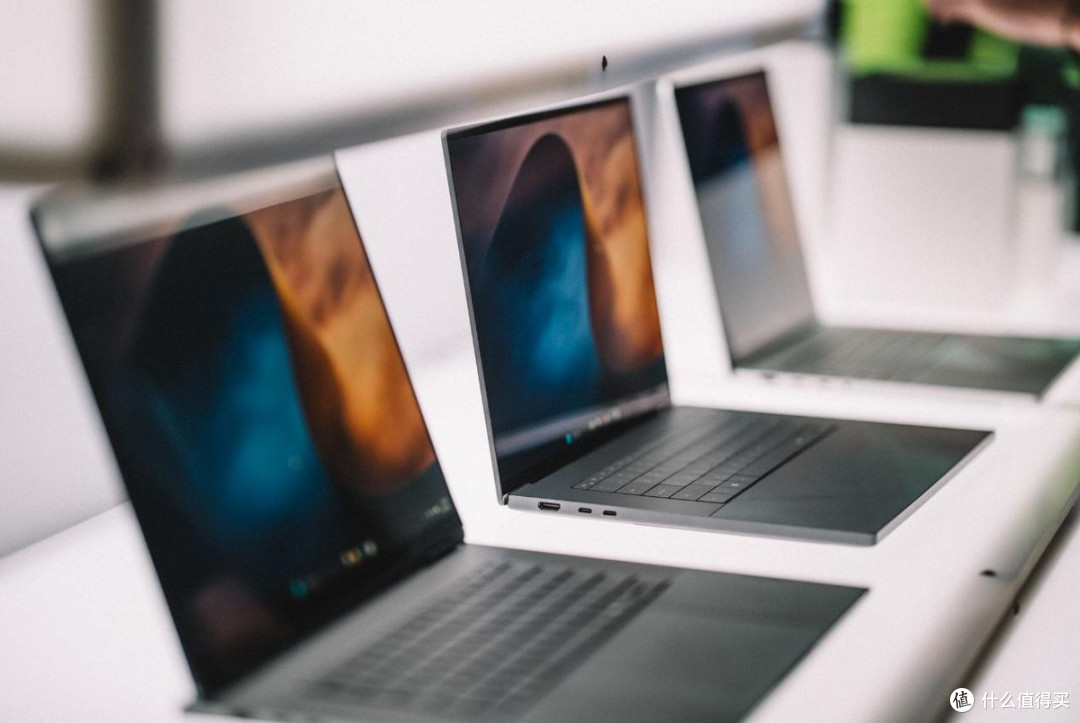
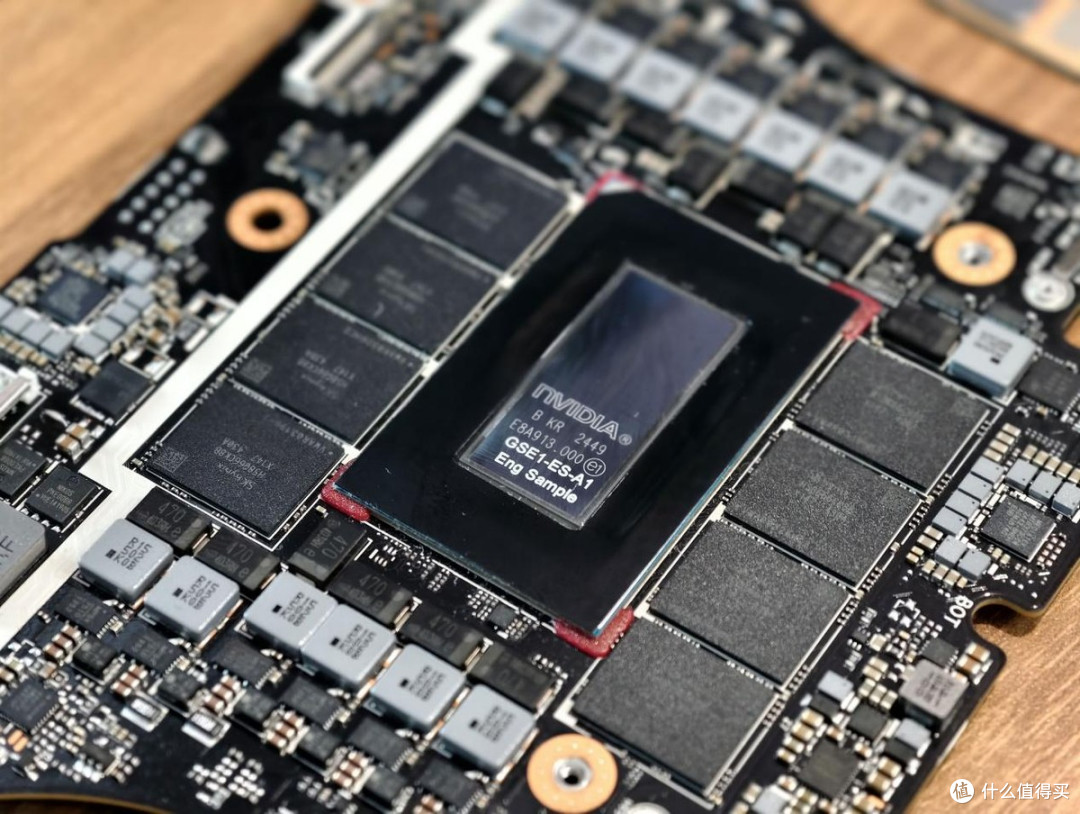
在这长达一整天的媒体沟通会中,RTX Spark N1X作为绝对的主角已经展现出了性能与生态的多面性,它的硬件规格很能打,有着RTX 50系列独显的性能,并且可以塞入最低1.35kg,未来可能会更轻的轻薄本中。同时它被Windows on Arm宠幸,过去一年多的海量优化、适配,以及NVIDIA强大的游戏、创作、生产力与娱乐的号召力,让RTX Spark发布的第一天就拥有海量的专业应用支持,以及上百款3A游戏大作加入,所有游戏和应用的体验都能在2.5K分辨率的屏幕上保持100FPS以上的帧率运行。
重点是,微软Surface之后,华硕、戴尔、惠普、联想、微星也已经推出了对应的RTX Spark笔记本产品,给这场全新的芯片之旅定下了宏大的开场篇章。
NVIDIA RTX Spark无疑是一个令人振奋的新产品,同时也是一个新时代的开端,它究竟可以做到什么地步?现在不妨让笔者整理一些编辑日现场信息,对RTX Spark有一个初步了解。与此同时,我们的RTX Spark笔记本深度评测内容也同时发布,感兴趣的同学也欢迎前往爱极物公众号翻阅。
为什么要做RTX Spark?
RTX Spark N1X超级芯片无疑是整个SoC的核心,用NVIDIA的表述,这是一个全新的Windows SoC品类。事实也是如此,在此之前,Windows on Arm几乎围绕高通骁龙X Elite系列搭建,受限于对PC计算、图形计算的理解,再加上PC领域的行业号召力欠缺,基于骁龙X Elite系列SoC的产品在过去很长一段时间中苦苦支撑。
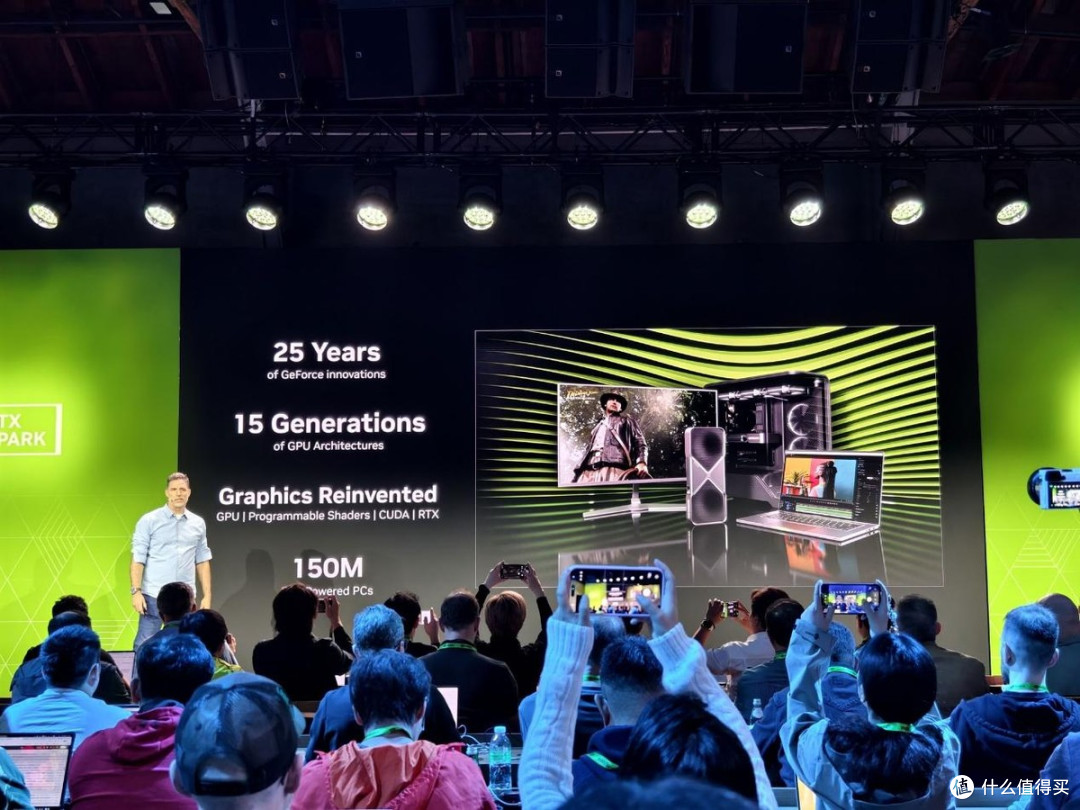
而NVIDIA显然是不一样的。在过去25年中,NVIDIA整整推出了15代用于PC的GPU,无论是GPU的概念,还是将大规模并行处理器从论文走向量产实践,推出可编程GPU和大名鼎鼎的CUDA,并用作后来的GPU神经网络训练加速。大约在8年前,首款支持实时光线追踪的GeForce RTX 20系列发售,如今全球已经拥有超过1.5亿台RTX PC。
硬件只是载体,栈才是壁垒。1.5亿台RTX PC的装机量的基础是一整套横跨游戏、创作、AI 的软件层,这也进而成为RTX Spark独一无二的优势。
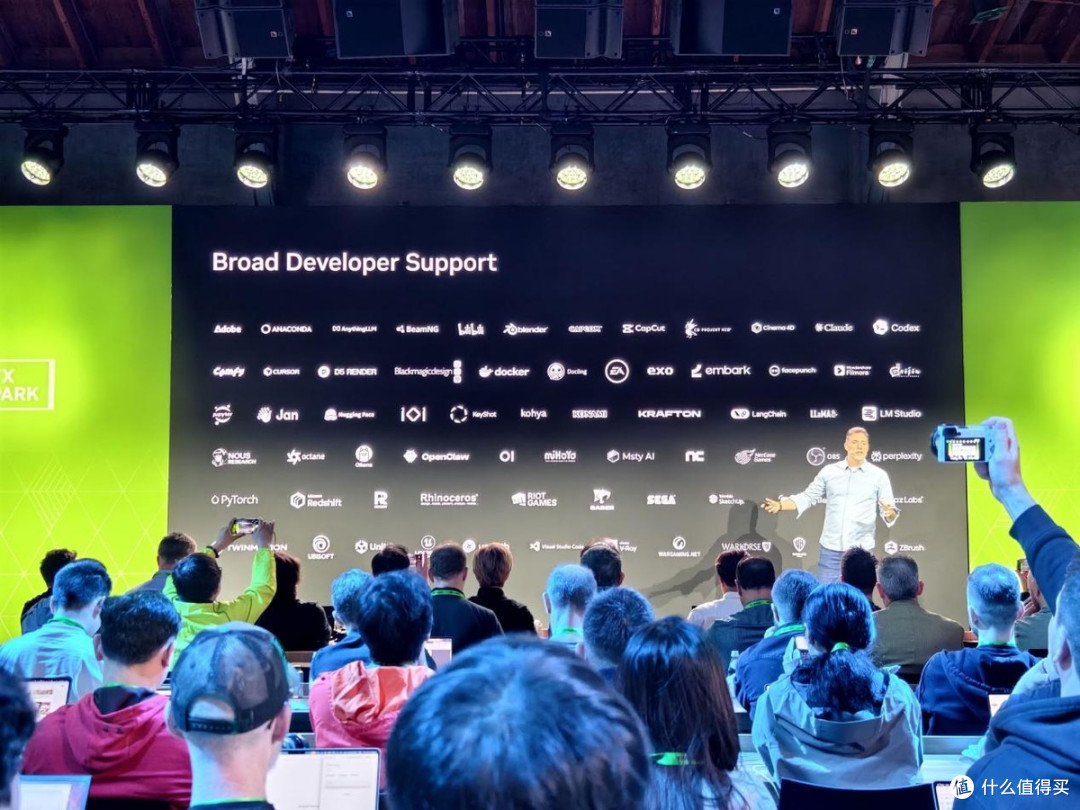
更确切的说,RTX Spark不仅是一颗芯片,而是整个栈的最小载体,背后连接着游戏侧的DLSS、Reflex、Game Ready驱动等游戏基础的支持。创作侧亦是如此,RTX Spark N1X Blackwell视频引擎支持4:2:2专业格式硬件加速,可以轻松实现编解码加速,并且在创作应用中也能使用DLSS,Blender 5.3的降噪就是其中很好的例子。同时NVIDIA Broadcast、RTX Video通过文件处理器、摄像头补帧、超分辨率、音棚音效(Studio Voice)音色等功能,配合Studio驱动,确保创作得以稳定运行。
NVIDIA是最有机会提供完整的本地AI全栈自研闭环方案。这得益于GPU天然擅长的AI算力,以及引入的NVFP4数据格式,即4-bit浮点格式,把模型体积压到原来的几分之一。例如同一个FLUX2.Dev模型中,BF16需要128GB内存、FP8需要64GB以上,NVFP4仅需要32GB内存即可运行,这给端侧AI提供了可能性。

另外第五代Tensor Core本身就原生支持加速NVFP4,这也对应了RTX Spark N1X的1 PFLOPS FP4算力只有在NVFP4模型上才能完全释放。软硬件协同设计让RTX Spark有了更多机会。
最后是Day-0模型合作构成的生态护城河。NVIDIA与模型厂商合作,新模型发布即针对RTX优化,这和游戏Game Ready驱动是一样的做派。目前RTX Spark N1X已经能够很好的支持Qwen3.8 27B、Qwen3.8 Flash Next、Nemotron Bolt,并且拥有针对Spark预调优配置的NVIDIA Local AI Recipes仓库,加上llama.cpp/Windows ML双推理路径,RTX Spark变得顺理成章。
有意思的是,整个行业的技术节点和需求也发生了悄然变化。OpenClaw、Hermes这类智能体项目的星数在极短时间内垂直拉升,超过了Linux、PyTorch这些时代最重要的软件项目。
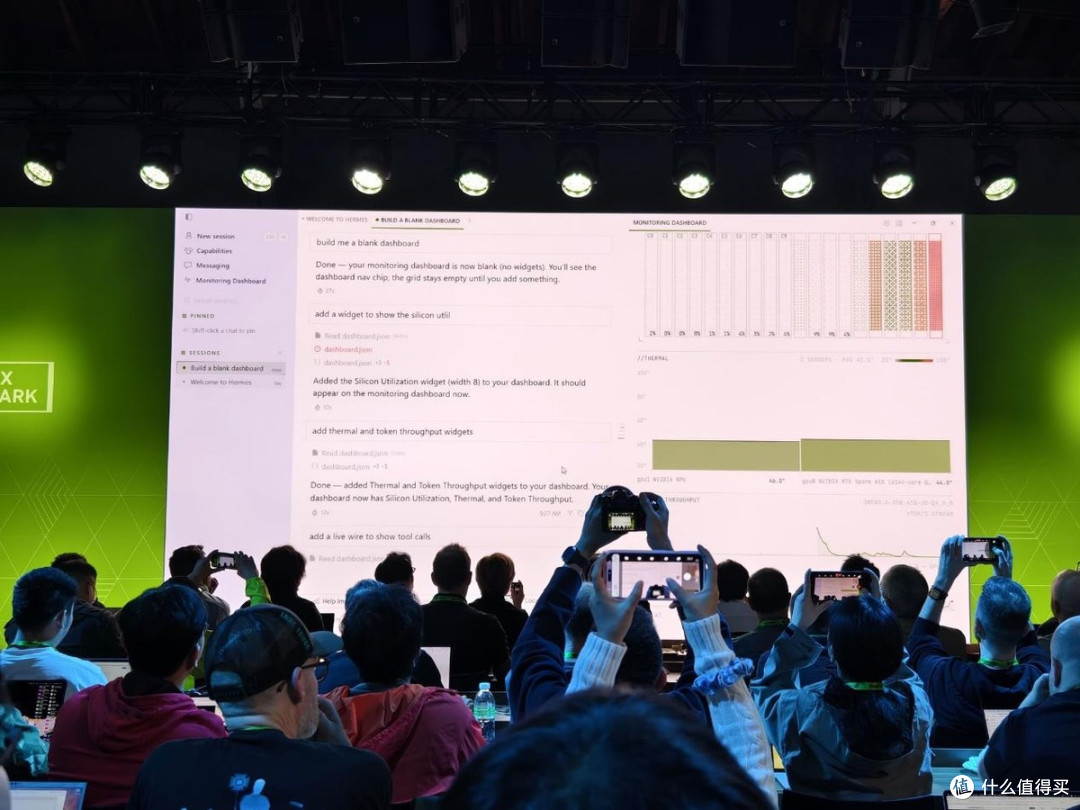
更有意思的是,本地模型并没有大幅落后云端模型,在一系列优化与蒸馏之后,今天的本地小模型,已经能达到几个月前前沿云端模型的智能水平。虽然落后几个月,但由于本地模型不消耗Token,并且免费、离线、无延迟,吸引力自然变得更大。特别是从现在的大趋势看,本地模型的能力每3个月就有质变,举个不太恰当的例子,几个月前我们还在赞扬的ChatGPT Images 2.0的在线生成效果,现在本地运行的Qwen‑Image‑2.1也已经能够做到相当的水准了。
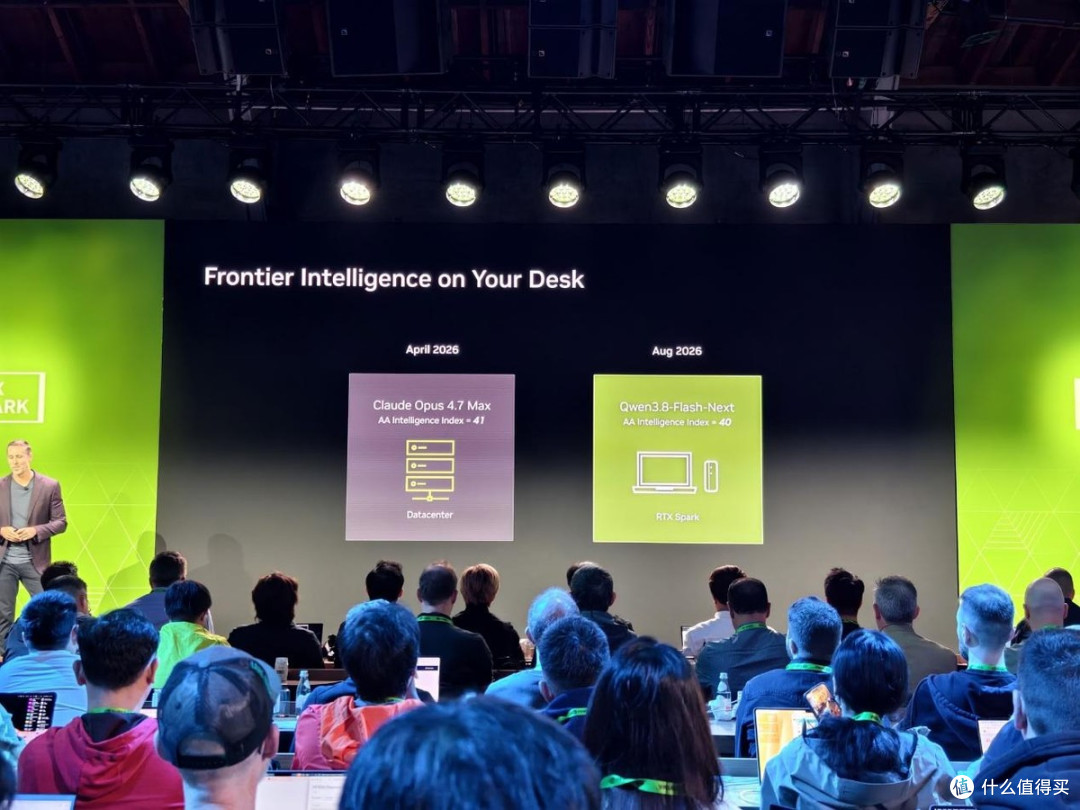
这时候我们就会发现一个问题,目前大模型的发展本质上是智能在贬值、算力在升值,今天的免费本地模型,就是半年前别人按Token付费的智能,需要一个明确的实体化产品承接这部分空窗期。
这里NVIDIA也引用了Hugging Face的模型下载数据,发现相比去年,今年本地模型下载量成5倍的增长,并且现在只是10月份,意味着实际本地模型下载量还能更高,端侧运行变得势在必行。无论从哪个角度出发,RTX Spark将成为填补端侧AI的一款重要产品。
RTX Spark架构浅析
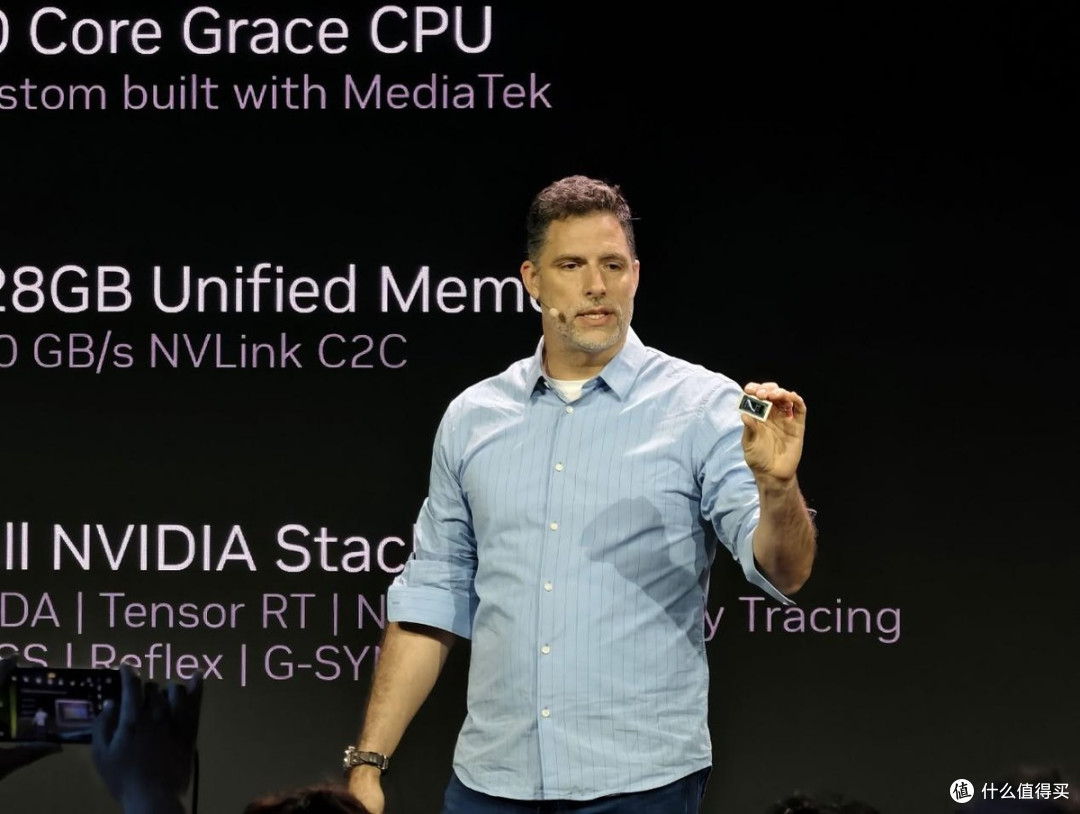
NVIDIA在Keynote中多次强调RTX Spark是一颗超级芯片,而不是普普通通的SoC,它把最新一代Blackwell RTX GPU、与联发科联合设计的Grace CPU、以及统一内存架构融合在一起,并完整继承RTX技术栈。
这相当于NVIDIA把数据中心Grace-Blackwell超级芯片的设计理念下放到消费级产品中。NVIDIA数据中心的打法本质上是围绕Grace CPU + Blackwell GPU + NVLink-C2C的组合展开,RTX Spark和DGX Spark都相当于这个思路的延伸版本。
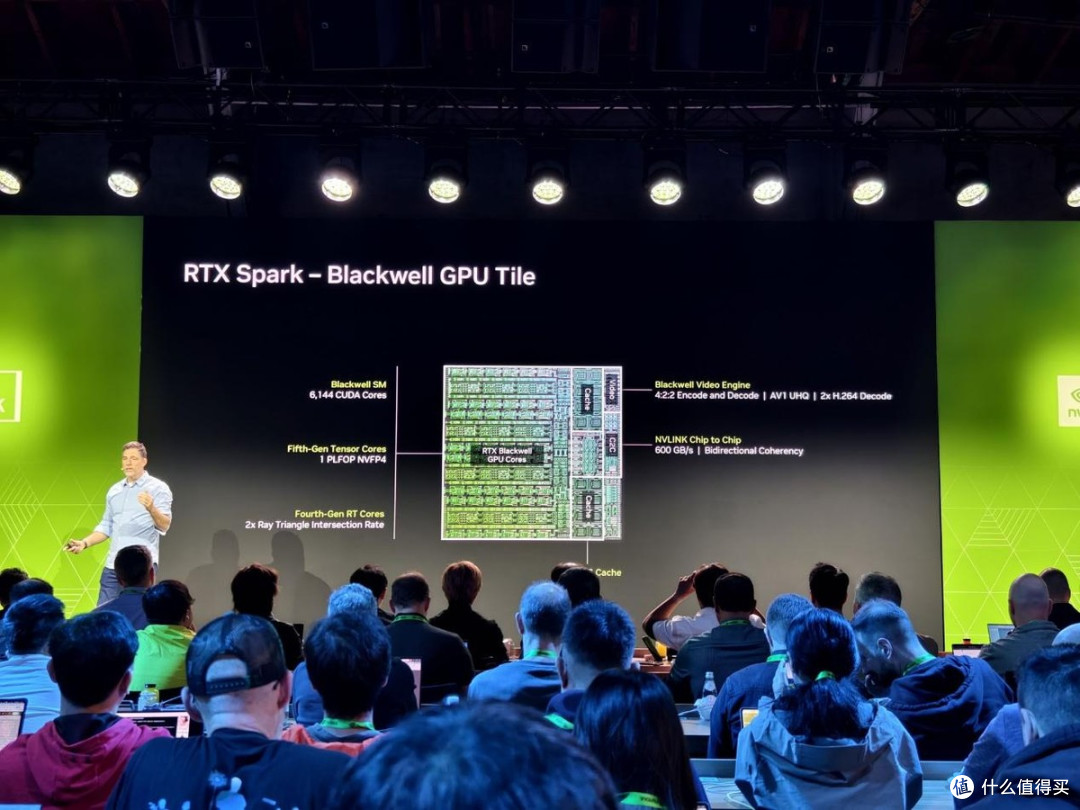
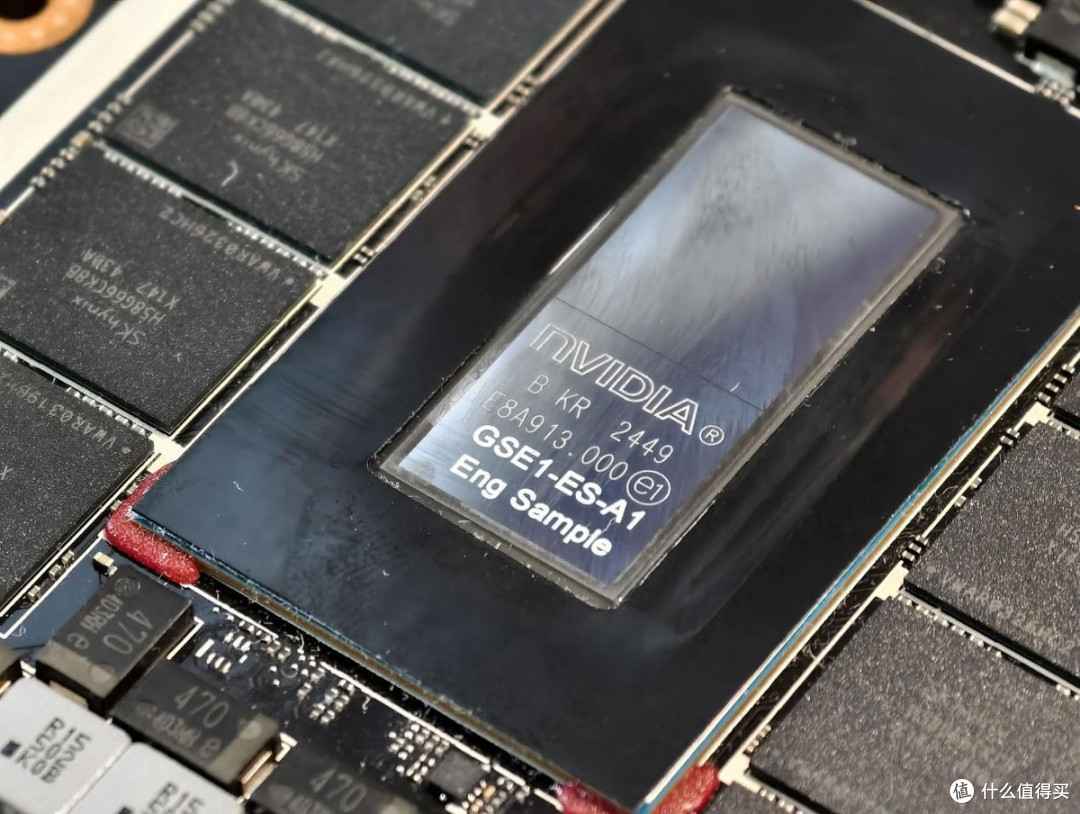
RTX Spark N1X由两颗die(芯粒)组成CPU和GPU,两颗die均为台积电3nm制程。
其中Blackwell GPU tile是完整的Blackwell图形与AI计算阵列,满血版拥有6,144个CUDA核心,对应48组SM(流式多处理器),另一个版本拥有5,120个CUDA核心,对应40组SM。其中48组SM的规模相当于桌面版GeForce RTX 5070的级别,但由于内存容量、带宽、功耗和运行策略都不相同,所以不能将RTX Spark N1X满血版与GeForce RTX 5070桌面版划等号。
这块Blackwell GPU tile拥有第五代Tensor Core,其AI算力在NVFP4精度前提下达到1 PFLOPS,当然前提是第五代Tensor Core以及AI应用本身都需要对FP4提供原生支持。同时GPU还拥有第四代RT Core光线追踪核心,光线-三角形求交速率比上一代翻倍。求交运算是光追最底层的计算,这个翻倍直接决定光追游戏的帧率上限。然后就是前面提到Blackwell视频编解码引擎,支持硬件编解码,包括面向专业剪辑的4:2:2格式加速,这是内容创作者的刚需,此前的消费级GPU只能软解相机4:2:2采样的素材。
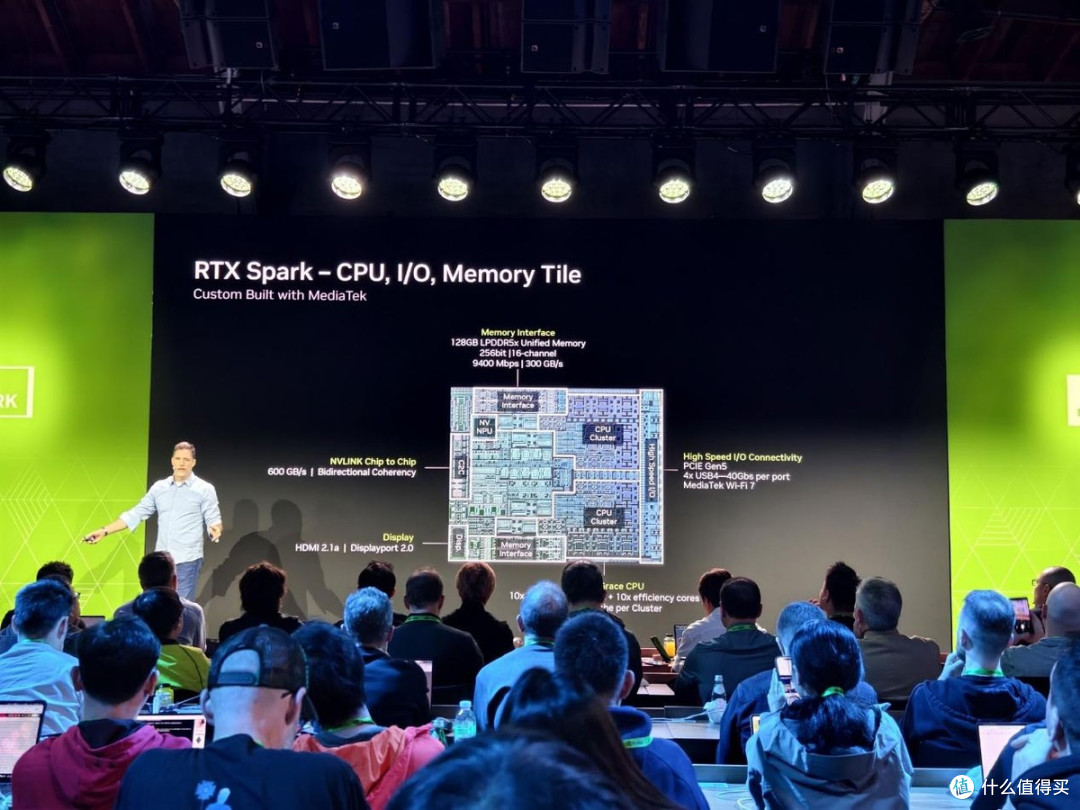
Blackwell GPU tile通过NVLink-C2C与Grace CPU连接。NVLink-C2C被认为是RTX Spark N1X的技术灵魂。NVLink-C2C拥有双向600GB/s带宽,作为参照,普通笔记本里CPU和独显之间 PCIe 5.0 x16只有约64GB/s带宽,NVLink-C2C高出近一个数量级。
同时NVLink-C2C具备双向一致性(bi-directional coherency)。CPU和GPU可以同时操作同一份数据,并且硬件自动保证两边看到的缓存副本是一致的。没有这个能力时,CPU改完数据要靠软件显式同步给GPU,依靠程序员手动管理缓存,又慢又容易出错。而有了硬件级一致性,编程模型大幅简化、通信开销大降。对AI负载的意义尤其大,因为在推理过程中,CPU侧的控制逻辑和GPU侧的张量计算要高频交换数据。

NVLink-C2C效能还比PCIe数据传输高出25倍,因为统一内存架构本身搬运数据是不耗电的,这25倍就是统一内存经济性的来源。
RTX Spark N1X拥有20核Grace CPU,分两个簇,每簇10核,即10个性能核和10个能效核,每簇配备16MB缓存。其中性能核由Arm Cortex-X925构成,能效核由Arm Cortex-A725构成,性能核最高4.0–4.1 GHz、能效核2.8 GHz。另外18核版本的RTX Spark N1X由9个性能核与9个能效核构成,性能核最高3.9GHz。
值得说明,Arm Cortex-X925和Arm Cortex-A725是Arm 2024年发布的公版核心设计组成,与天玑9400同代。有理由相信NVIDIA Grace CPU通过Arm公版设计、联发科设计经验,以及NVIDIA定制需求共同协作,从而在短时间内完成CPU开发,以节约开发周期。
RTX Spark N1X内存接口最高支持128GB LPDDR5X统一内存,256-bit位宽、16通道,速率最高9,400 MT/s,峰值带宽300GB/s。统一内存是AI叙事的关键,CPU和GPU共享同一片内存池,GPU有机会动用更多的显存,这是同规模的GeForce RTX 5070 16GB显存所羡慕不来的。
但这样设计的代价也很明显,300GB/s的带宽远低于桌面独显,例如GeForce RTX 5070显存带宽约672GB/s,旗舰型的GeForce RTX 5090更是拥有1792GB/s,统一内存换来的是容量而非带宽,这是因为AI推理对容量敏感、游戏对带宽敏感,这个取舍决定了RTX Spark注定是一款AI优先的产品。
另外IO与显示引擎也放在CPU tile上,支持HDMI 2.1a和DisplayPort 2.0,其中DisplayPort 2.0通过USB4实现。
最后让我们绘制一个完整的对比表格:


在保持强大性能的同时,RTX Spark N1X也兼顾优秀的能效表现,这也是其能够塞进笔记本的重要原因。其中与手机同源的LPDDR5X低功耗内存远比GDDR7显存省电不少,基于Arm的Grace CPU在能效上有着先天的优势,Arm架构搭配性能核、能效核分工,让RTX Spark N1X更为省电。另外NVLink-C2C省下的25倍传输能耗,也是常规的独显+CPU的笔记本无法比拟的。
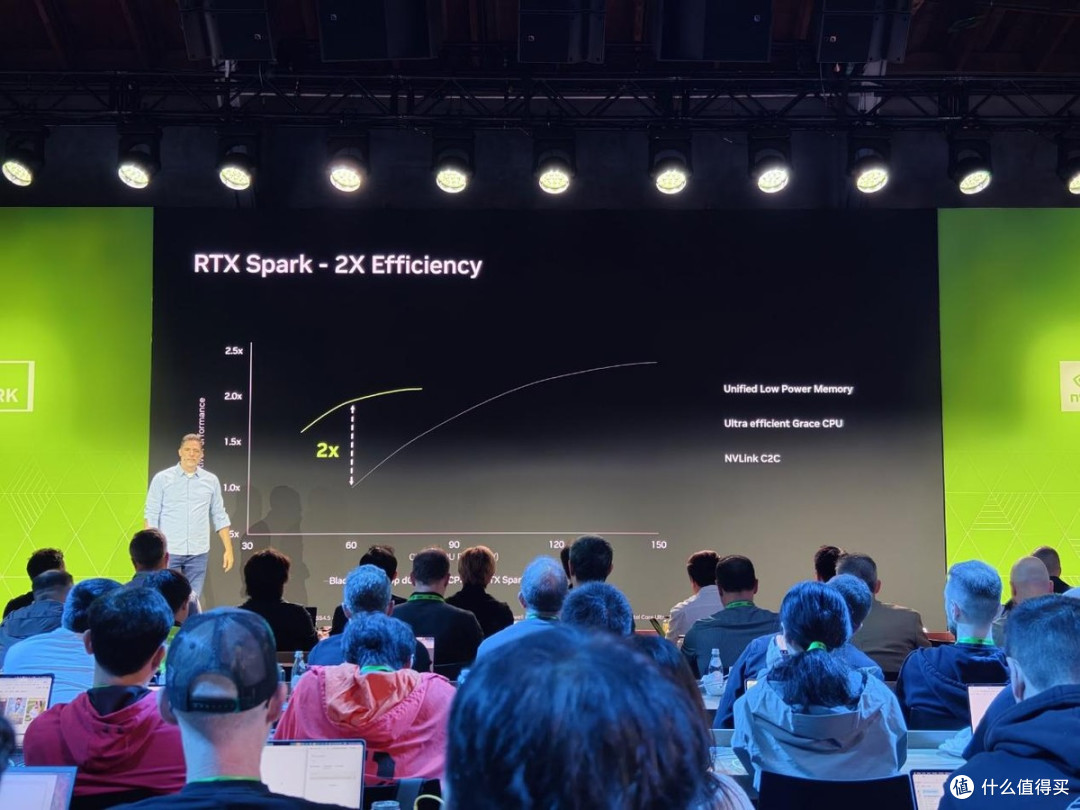

这样的设计在典型的100W电池供电范围之内,这让RTX Spark N1X拔了电也能跑接近满性能。在后续的联想 YOGA Pro 15 RTX Spark首发评测中,我们将进行详细说明。
5倍于历代Windows SoC
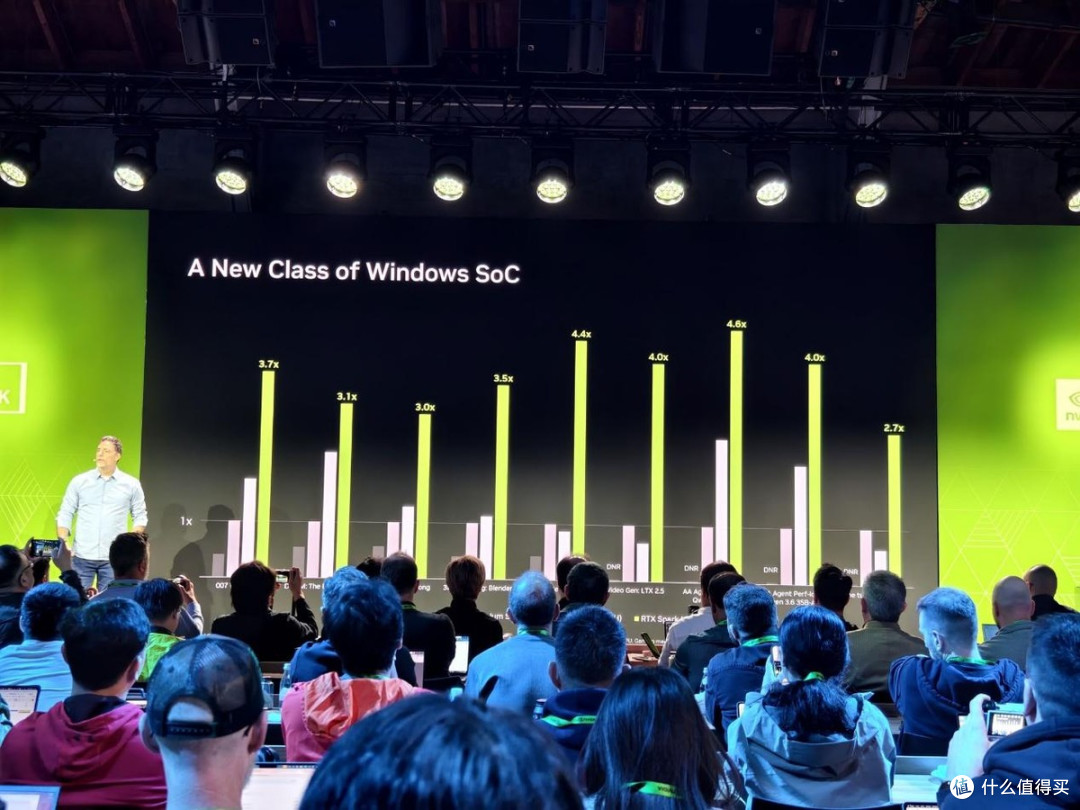
按照NVIDIA的说法,RTX Spark N1X将优于当前任何一款Windows SoC的3到5倍性能表现。这里的性能表现围绕的是跨负载的综合区间展开,即包含游戏、创作应用、智能体和本地模型推理,不是单一的跑分对比。也因为如此,RTX Spark开辟了一个全新的性能断层,让Surface Laptop Ultra、联想 YOGA Pro 15 RTX Spark这样轻薄且具备独显的性能成为可能。
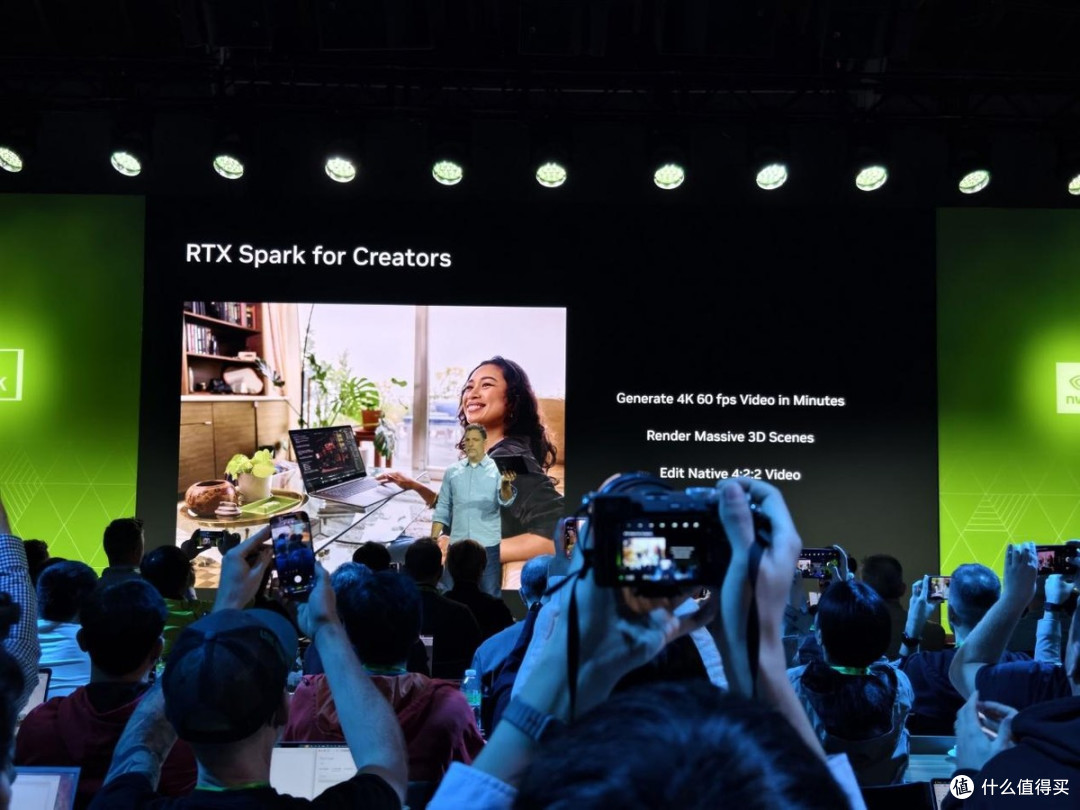
在负载演示中,NVIDIA展示了数分钟内通过AI视频生成模型生成4K 60fps视频,这里面包括ComfyUI + LTX 2.5 + RTX Video超分辨率/补帧的工作流,本质上是模型出低分辨率 + AI超分辨率到4K的形式,效率出众。
另外一个演示就是加速4:2:2专业视频,通过Blackwell编解码引擎,给当前的相机素材编辑场景提供了更多可能性。
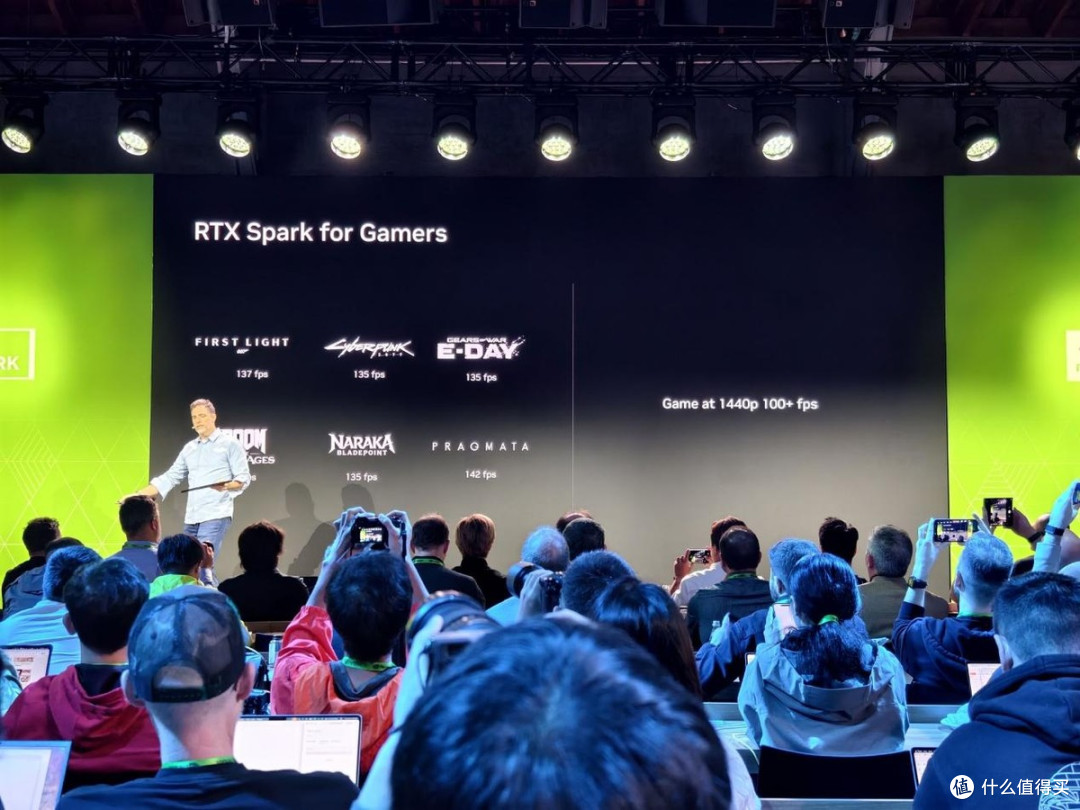
在游戏领域,RTX Spark N1X可以做到1440p分辨率下具备超过100FPS游戏帧率的表现。这是因为RTX Spark N1X本身带着完整的RTX技术栈,DLSS 5、Reflex等技术都是原生支持的。重点是,这套运行方式可以在轻至1.36kg、14mm的轻薄本中实现。我们知道目前有诸如机械革命耀世/翼龙15 Air之类的机型将GeForce RTX 5060 笔记本电脑 GPU的独显本做到了1.5kg,也有理由相信RTX Spark N1X在工程经验丰富之后,轻薄性进一步降低到1.3kg以下,直接威胁核显轻薄本的生存环境。
本机运行120B参数级以上的先进模型也同样出现在RTX Spark N1X的现场演示中,这本来是工作站和服务器的应用范围,但依靠128GB统一内存和NVFP4量化,RTX Spark N1X让轻薄型笔记本也做到了。
在现场,NVIDIA用大约三年前的GeForce RTX 4070 笔记本电脑 GPU笔记本作为对比,RTX Spark N1X的轻薄本可以做到三年前这款游戏本的3倍综合性能,3倍电池续航能力,12倍可运行模型规模,高达128GB的统一内存则是以前显存加内存都无法比拟的。重点是RTX Spark N1X抛开了游戏笔记本的厚重,更小、更轻、更薄。

RTX Spark N1X的定位根据内存与核心数量也略有不同,比如RTX Spark N1X 650就能够很好的满足轻薄、游戏、创作、智能体的轻薄本需求。RTX Spark N1X 675配128GB统一内存则可以运行大模型、大型复杂3D场景、动画与视频生成模型,同时也已经能够兼顾紧凑桌面主机的需求,放在家里、办公室中长期开机,长期运行智能体,成为家庭的算力中枢,成为任何场景下的7x24小时常驻算力。
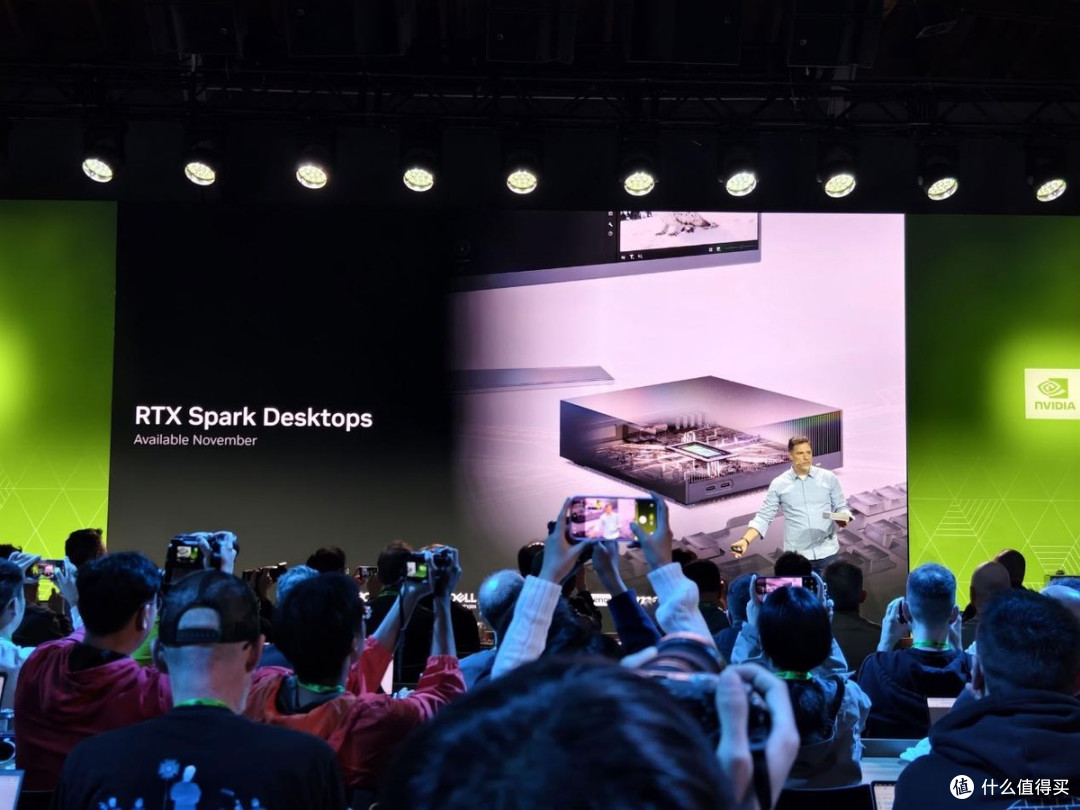
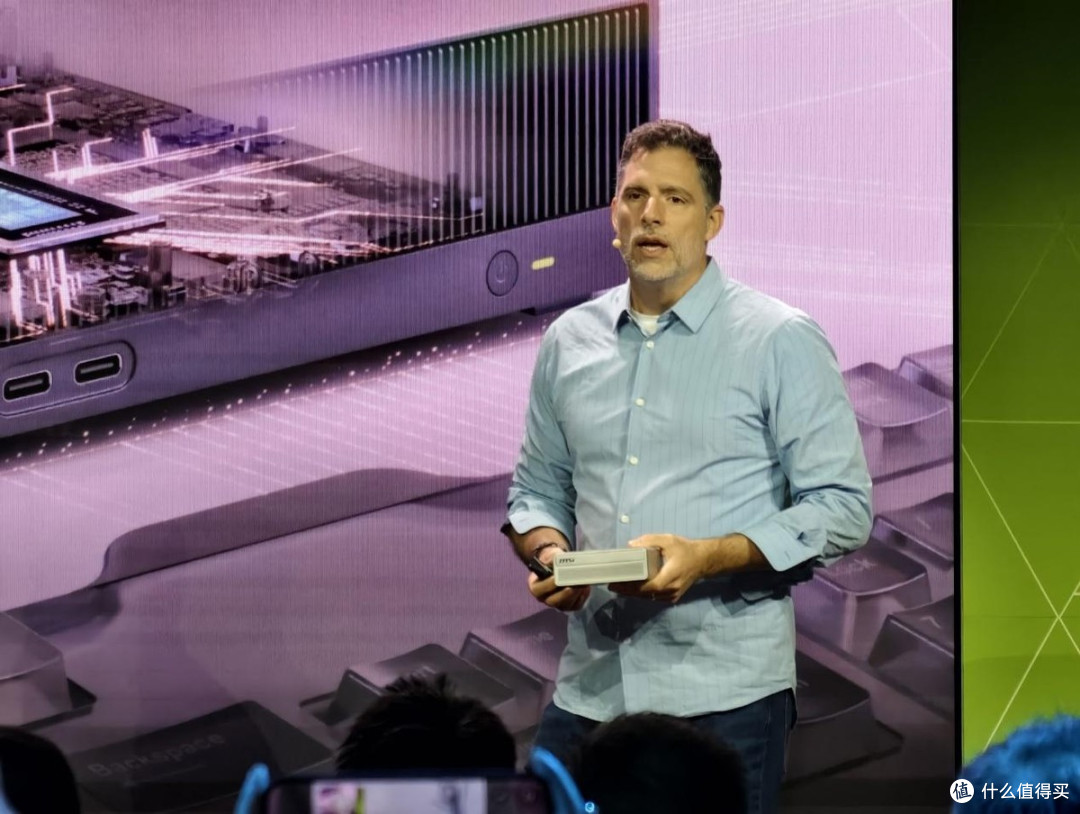
事实上NVIDIA也确实这么做了,NVIDIA NeMo Switchyard模型路由器和NVIDIA PAIR软件就是用来构建家庭、办公室本地网络AI推理集群所准备的,RTX Spark也更好的匹配这样的使用需求。
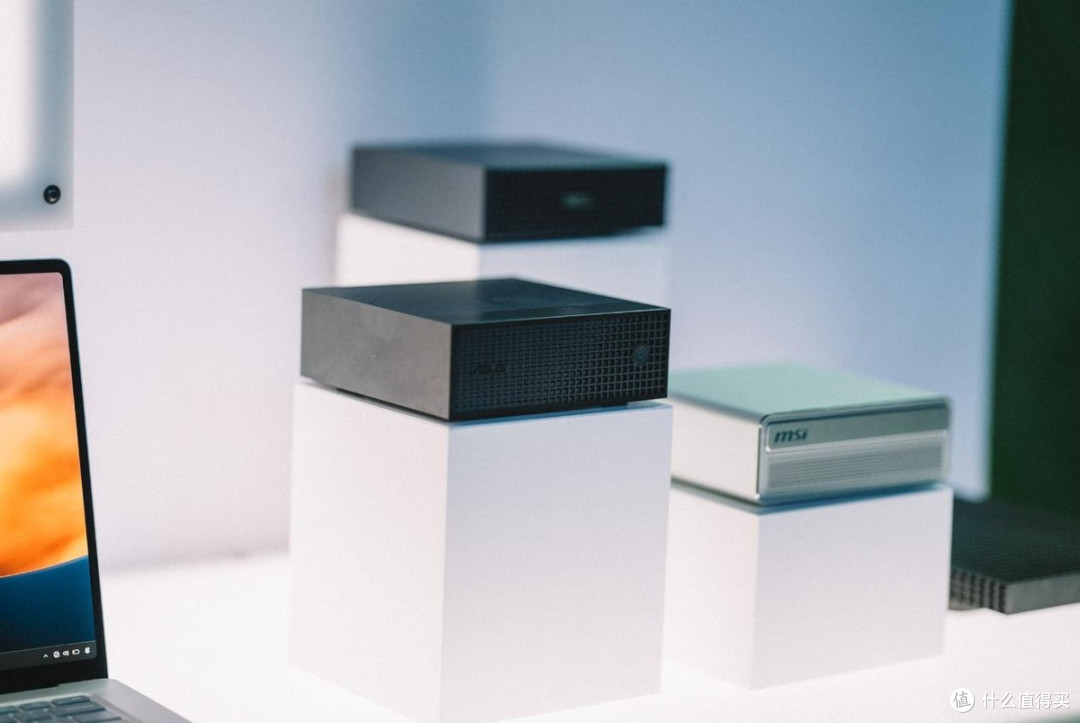
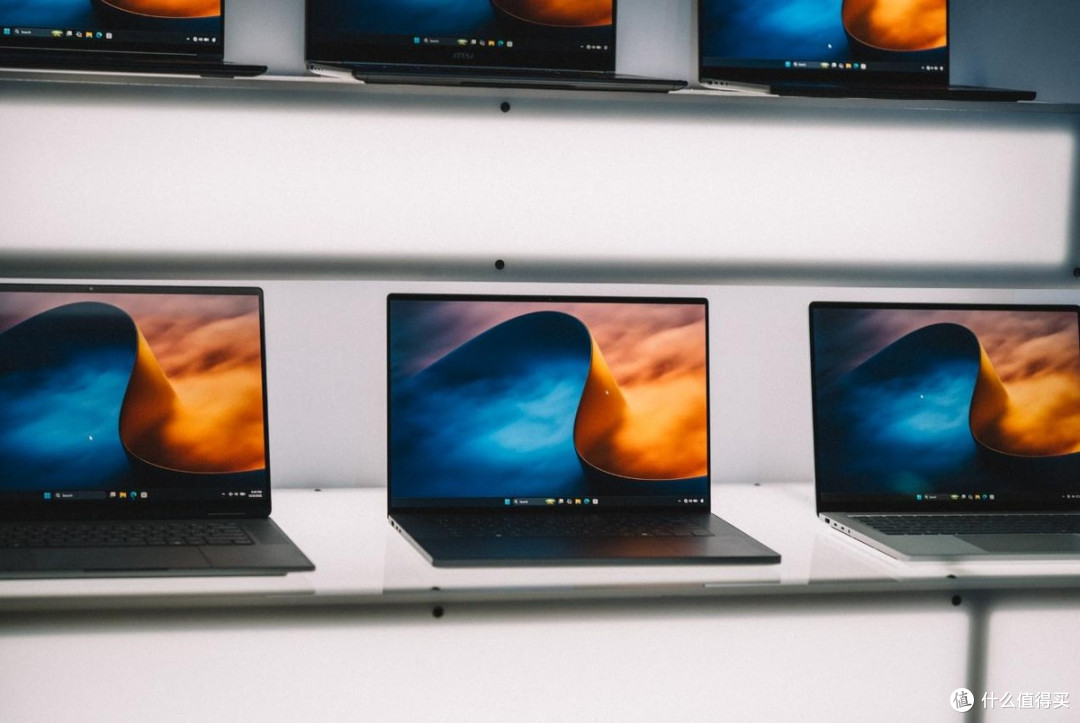
目前为止,除了刚刚提到的微软Surface、联想,华硕、戴尔、惠普、微星等一众厂商均已经推出了RTX Spark相关的OEM机型。并且作为第一款RTX Spark,众厂商下足了猛料,不仅质感好,并且漂亮、不易沾指纹、轻薄、全天候续航、插电拔电性能一致。从现场体验来看,现场的OEM笔记本都给笔者留下了非常好的印象,也对得起首发不低的价格。
智能体生态
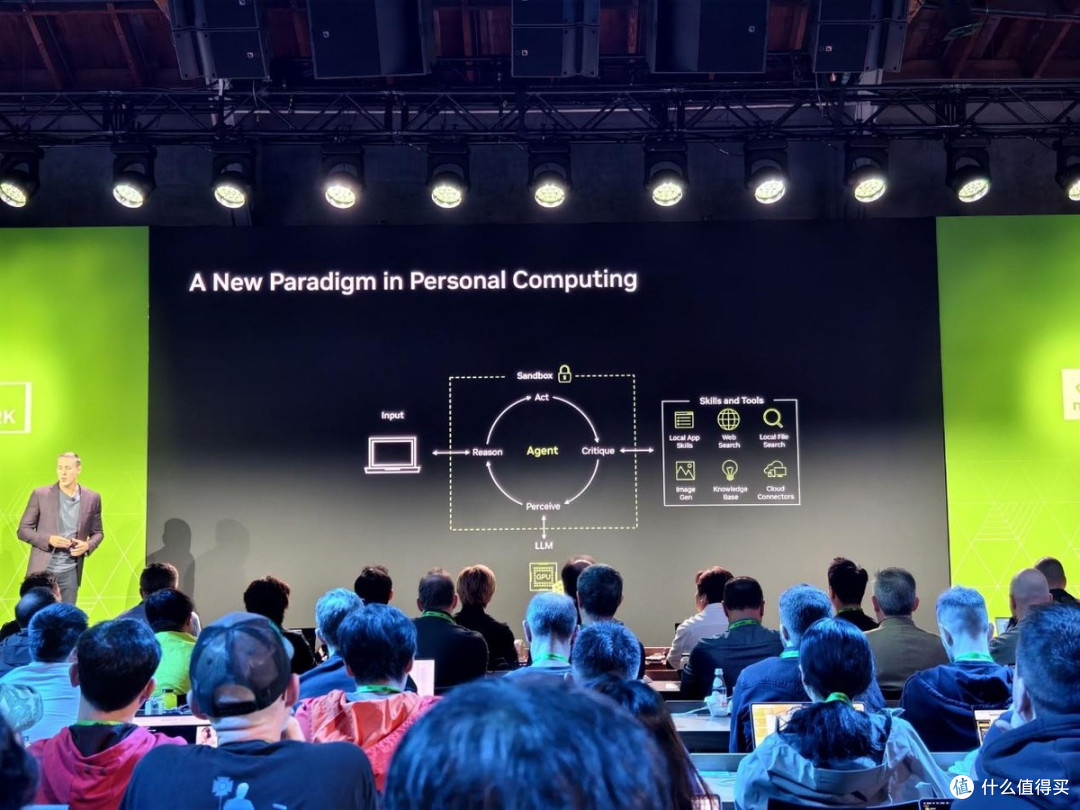
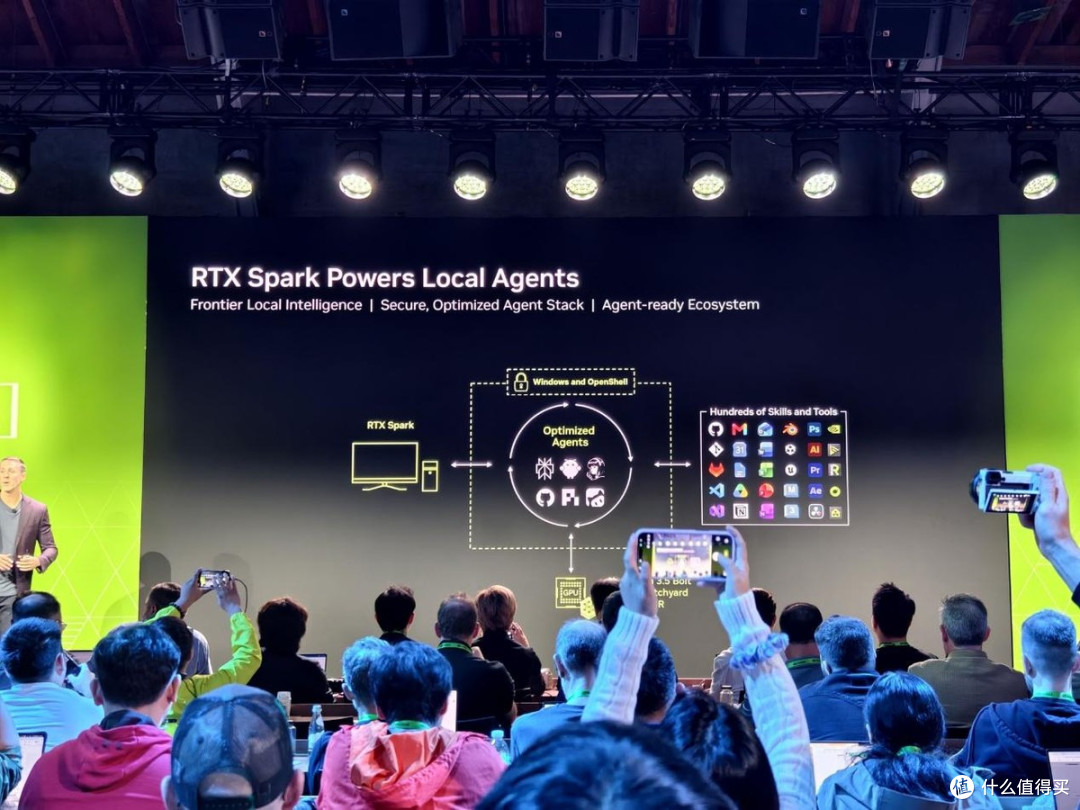
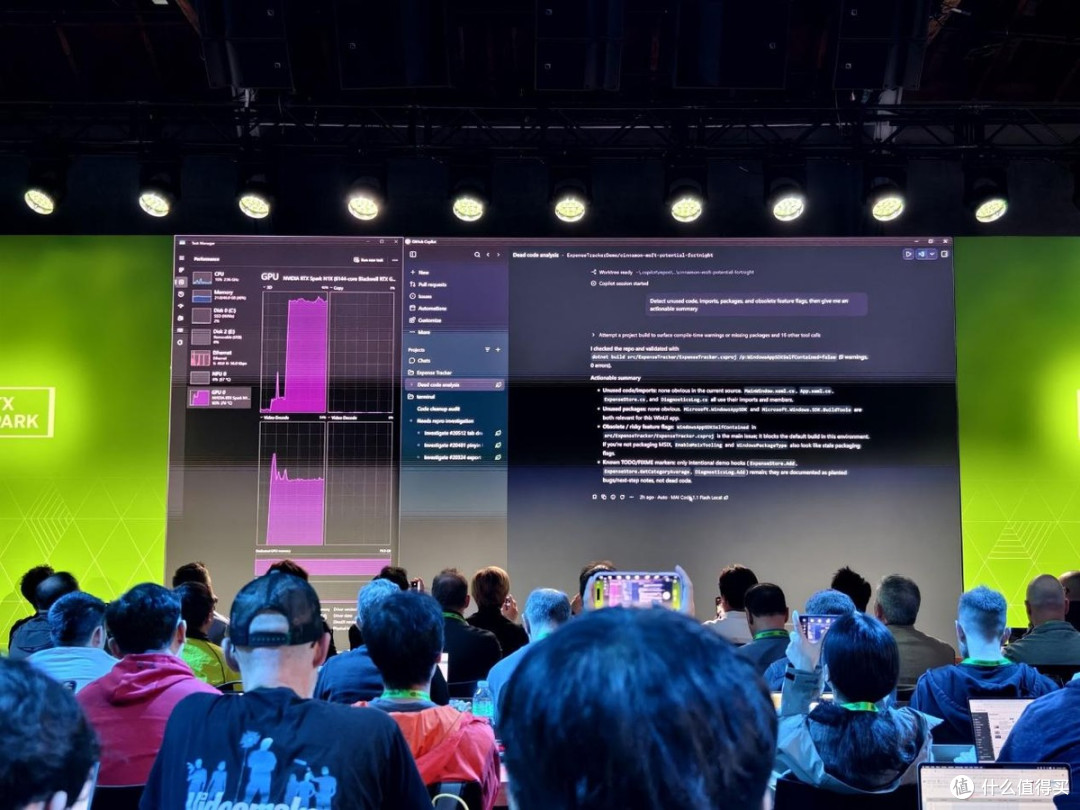
NVIDIA将智能体拆分成五个组成部分,即输入(Input),智能体框架(Agent Harness),大语言模型(LLM),工具(Tools),安全框架(Security Framework)。后面我们提到的微软MXC、NVIDIA OpenShell、Hermes、MCP生态都可以对应到层级中的某个层面。
其中,输入(Input)不只是自然语言的文字和语音,还包括用户的知识、策略(policy)、甚至应用的实时状态,智能体实际看到的世界比聊天框大得多。智能体框架(Agent Harness)承载推理-行动循环的应用,例如Perplexity、OpenClaw。大语言模型(LLM)是智能体调用来完成思考的部分,模型可以是本地的,也可以连接云端前沿模型。工具(Tools)是智能体调用来执行动作的能力,既可以是Blender这样的应用程序,也可以是系统级工具。最后是安全框架(Security Framework),作为至关重要的一部分,它将决定智能体能在用户PC上实际采取行动、能访问真实数据,所以必须在 OS 层确保智能体的行为限定在用户允许的范围内。
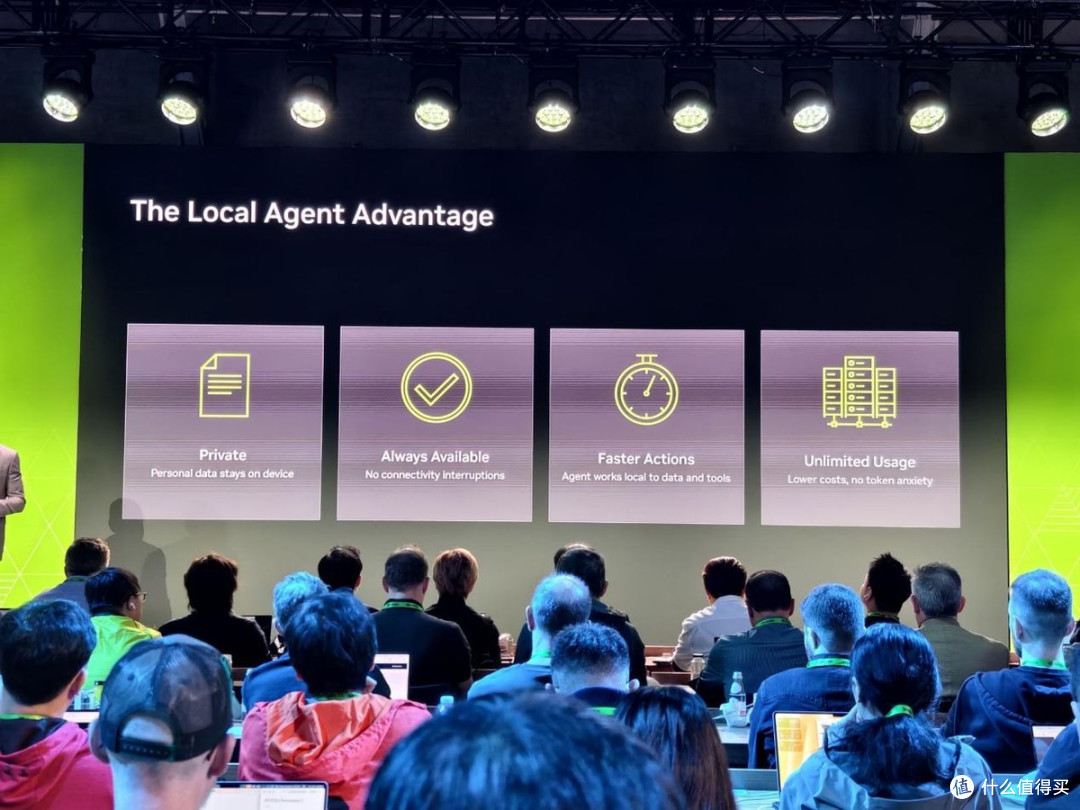
本地运行智能体有很多好处,它可以确保数据、个人文件、甚至屏幕上的内容,都不离开设备,并且在无网络的状态下也能运行。同时本地智能体没有Token限额焦虑,不用实时盯着用量,一次性硬件投入之后,使用几乎是免费的,对于普通用户、创作者、开发者而言,从常规的日历、邮件管理、到工作流搭建、再到修代码Bug,本地智能体最有机会将PC从工具变成队友。

同时本地智能体的发展速度很快,它往往比云端智能体晚4到6个月,比如某个云端智能体型号在发布4个月后,基于本地运行的Qwen3.8 Flash Next就达到了同样的水平,而今天典型云端订阅用户实际用的就是默认模型,这意味着如果这一类用户付费订阅日常用的那个模型,实际上和本地能跑的模型是一个级别的。
RTX Spark笔记本可以看成是一台个人Token工厂,一台RTX Spark本地跑Qwen3.8 Flash Next,月产出约6,100万token,电费成本是可以忽略不计的。但走同等量的云端订阅,成本可能高达数千美元。因此NVIDIA认为RTX Spark不只是创作和游戏设备,它是一台token 发电机,几个月就能自己赚回本钱。
当然本地也不是万能的,一旦超过一定阈值,云端模型就会介入。这时候系统里有一个评判模型(judge),智能体收到用户prompt后,本地模型先作答,judge评估回答质量,够好就直接返回用户,不够好再升级。同时用户可以为需要前沿推理的少数查询设置升级策略,且路由时可以按隐私策略脱敏。
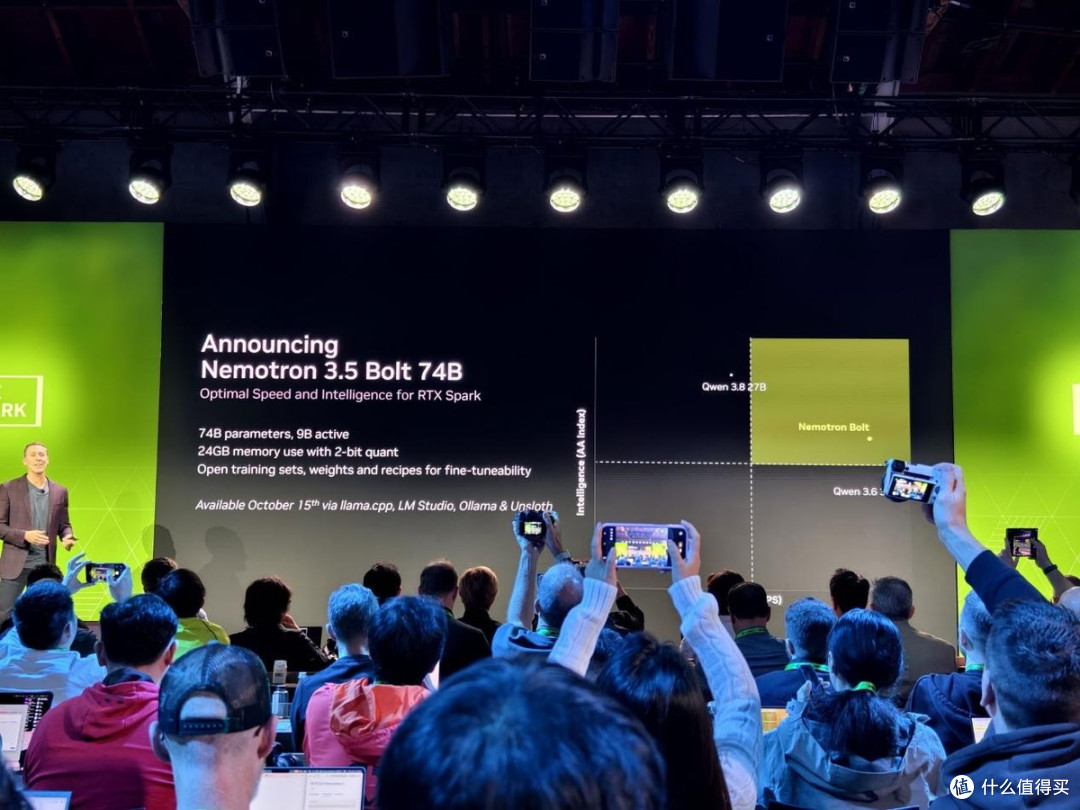
在现场,NVIDIA还发布了全新的Nemotron Bolt模型,采用MoE架构,总参数740亿,任意时刻仅激活90亿参数,通过稀疏激活换推理速度。这是因为常规量化下它会占用大量内存,2-bit量化后压缩到可在RTX Spark上舒适运行。这套模型专为RTX Spark调优,并已经实现Day-0匹配。
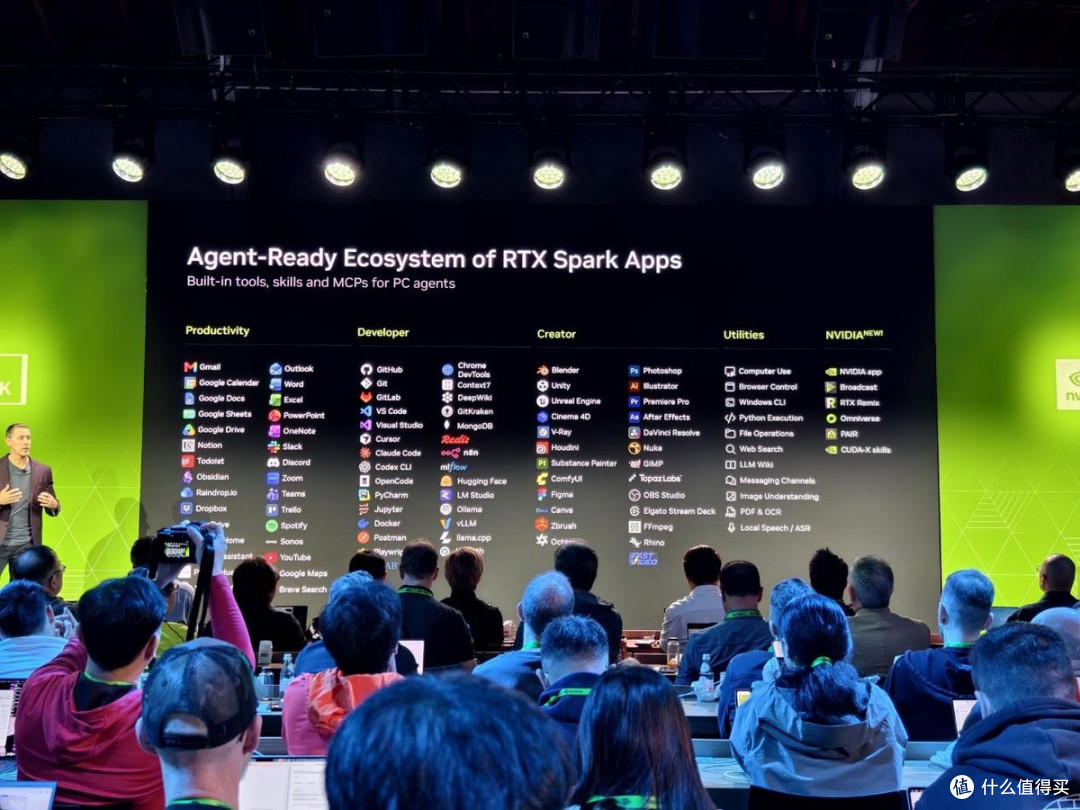
为了让智能体有更多开箱即用的工具,NVIDIA为头部应用准备了MCP服务器和命令行接口。例如针对开发者的GitHub系工具,创作者的Blender、Unreal Engine、ComfyUI,系统级别的浏览器操作、文件搜索。同时NVIDIA自家全家桶都开放了MCP,包括Broadcast、RTX相关库。NVIDIA App和Broadcast均内置本地MCP服务器,也方便我们后续使用腾讯WorkBuddy时候可以直接调用。
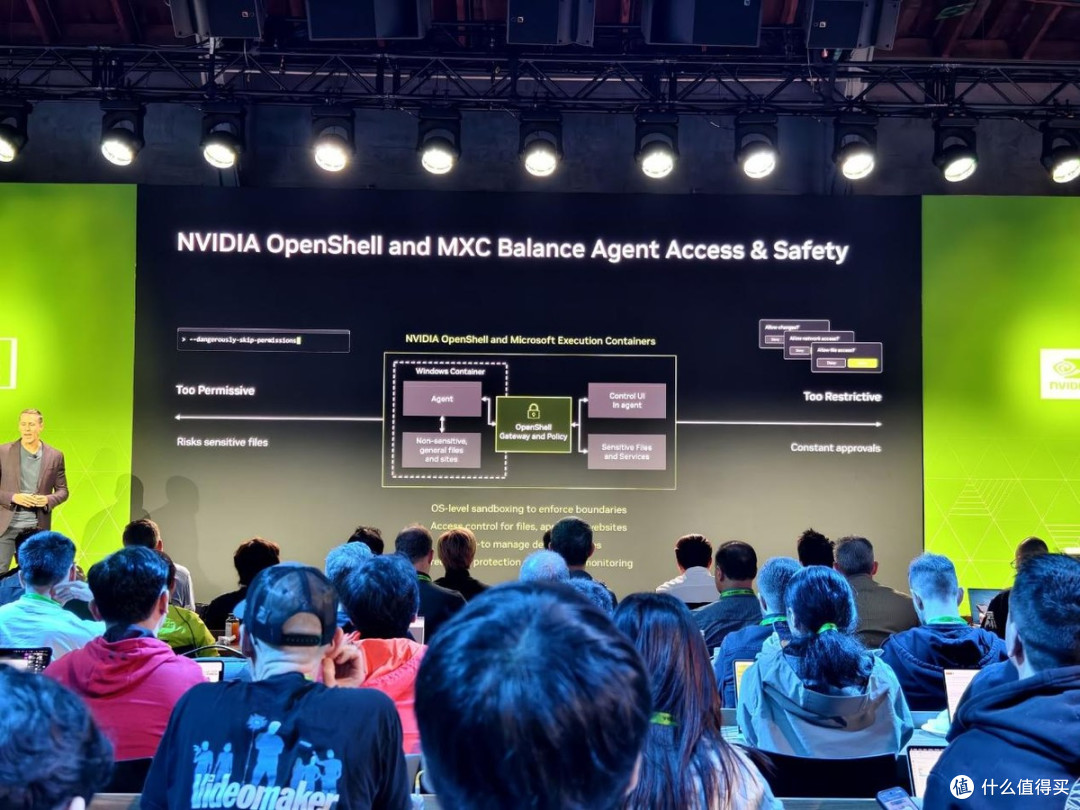
安全部分NVIDIA先匹配了时下两种流行但都不合适的模式。一种是小龙虾的YOLO模式即全部自动放行,这样方便但等于裸奔,智能体会拿着用户权限横冲直撞。另一种是事事询问,每个动作都弹窗要权限,体验拉胯。
这里NVIDIA与微软给出了一套双层方案,在底层基于微软MXC(Microsoft Execution Containers)进行,通过强制划界,安全不依赖智能体自觉,容器自动拦截对敏感文件和系统文件的访问,用户明确定义哪些文件、哪些应用对它开放。上层则基于NVIDIA OpenShell,这是基于MXC的治理层,提供更细颗粒度的控制,包括网络访问管控、凭据保护、安全监控。这样可以做到智能体有足够的权限干活,不必几秒钟来烦用户一次,同时敏感数据始终在安全范围内。
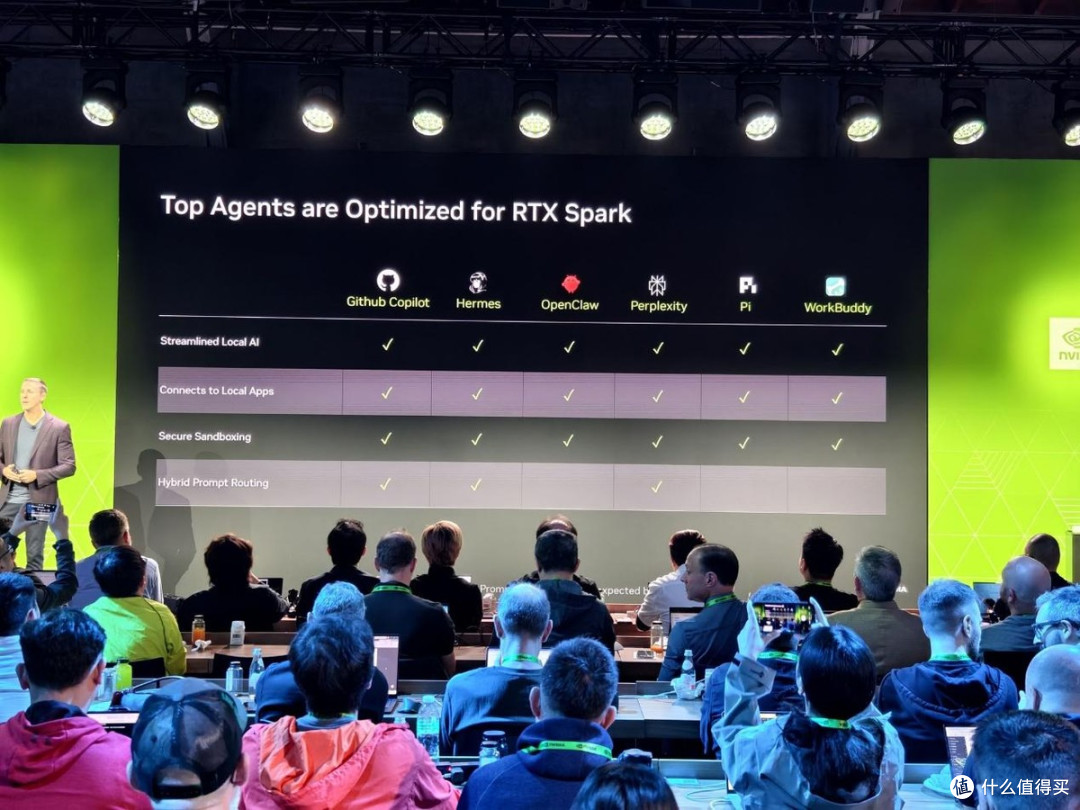
在RTX Spark笔记本上,优化过后的Windows on Arm首次开机有引导式对话,帮用户跑通第一个智能体,例如Hermes。同时Playbooks可以按用户角色预置的技能与工具清单,托管在build.nvidia.com,也预设在Windows菜单中,在上手的一小时内就能帮用户通过智能体完成几件有意思的事。
目前首批完成本地优化的智能体名单包括GitHub Copilot、OpenClaw、Hermes、Perplexity,以及面向中国用户的WorkBuddy,它们均开箱即优化的本地模型配置、本地Windows 应用连接、简化的工具安装 UI、MXC 沙箱,并通过NVIDIA OpenShell治理、混合路由本地和云端模型分配。
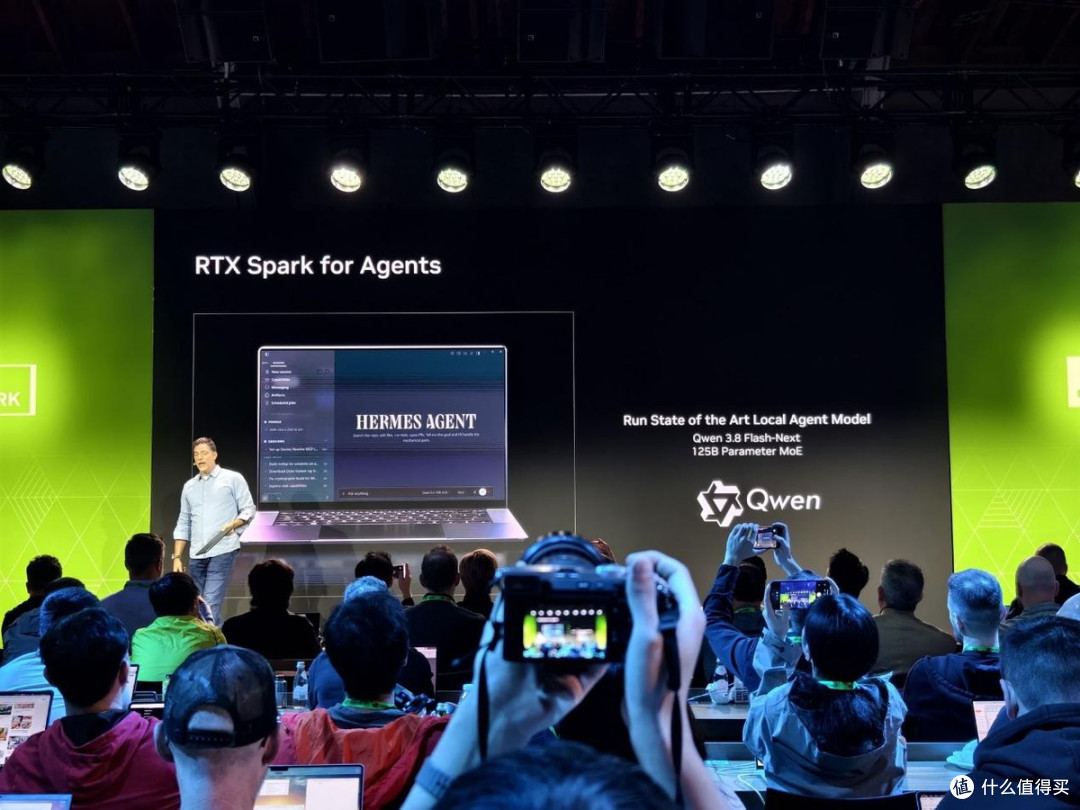
进阶:家庭智能体
在媒体分享会上,NVIDIA技术副总裁Jason Paul把智能体的存在层级分成三层,分别是个人智能体、家庭智能体和团队智能体。
个人智能体即拥有用户的个人知识、品味与偏好,能访问用户的私人数据;家庭智能体独立于个人智能体单独存在,它承载整个家庭共享的知识,认识家里的成员,能控制每一台智能设备。由于家庭数据不属于任何单个成员,权限和知识边界天然不同;团队智能体则是团队协作中的共享机制,适用于公司和小微企业。
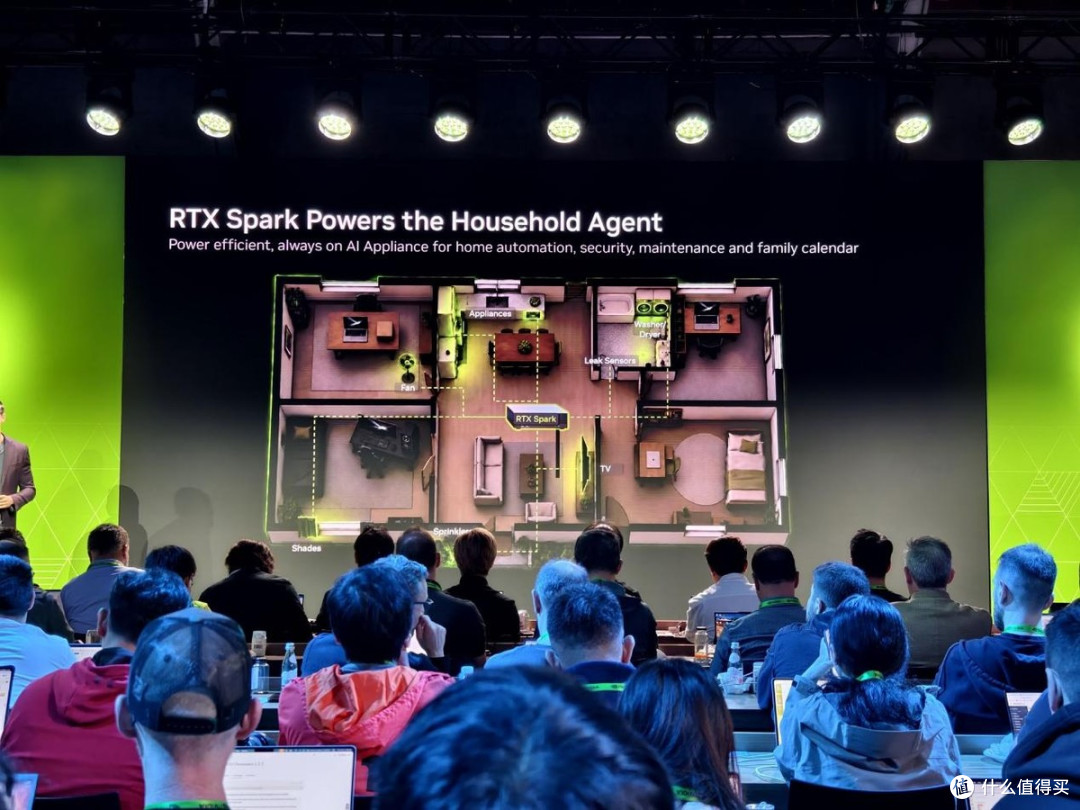
这里NVIDIA主要关注家庭智能体的发展,并围绕此推出了NVIDIA PAIR。
在NVIDIA定义中,家庭智能体有四个应用场景,包括智能家居控制的自然语言化,安防本地化,家庭日历,以及门铃与包裹事件应对。
其中最重要的是智能家居控制的自然语言化。在当下配置智能家居要手写一大堆规则、在一堆难用的App里来回设置,家庭智能体可以通过推理取代手写规则,利用自然语言入口管住所有设备。

安防本地化是家庭智能体的另一个应用场景,监控摄像头的数据可以留在本地、不上云,家庭敏感的隐私数据不会被曝光。家庭日历则可以共享日程的管理与提醒。最后是门铃与包裹事件,当门口有人、包裹时自动识别,并通知用户,或者代替用户给访客留言。
这四个应用场景需要一套家庭算力网络提供支持,RTX Spark可以作为中枢使用,它既可以成为用户的个人智能体的常驻运行地,又是一个闲置算力池的调度者。同时闲置设备可受邀加入,家里其他成员的PC,例如游戏本,在有余力的时候可以加入到算力池子中。整个过程可以执行任务级分发,来自团队任一成员的智能体任务流不断进来,同时任务被拆分成子任务,派发给家中的各台设备并行执行。
创作与生产力
在2010年CUDA首次被应用在Adobe Premiere Pro CS5的播放引擎中,让创作者第一次不用等渲染就能看到自己的内容。到了2020年前后,通过DLSS 2.0仅需要渲染四分之一的像素就能预览专业软件中的画面, Broadcast更是把AI降噪和背景效果带给日常麦克风和摄像头。到了2024年后,大生成模型落地设备端,NVIDIA与Black Forest Labs合作把FLUX.1从23GB压到10GB(NVFP4),本地生成变得更为可行,这就让RTX Spark的128GB统一内存和1 PFLOPS FP4 AI算力有了更多潜力。
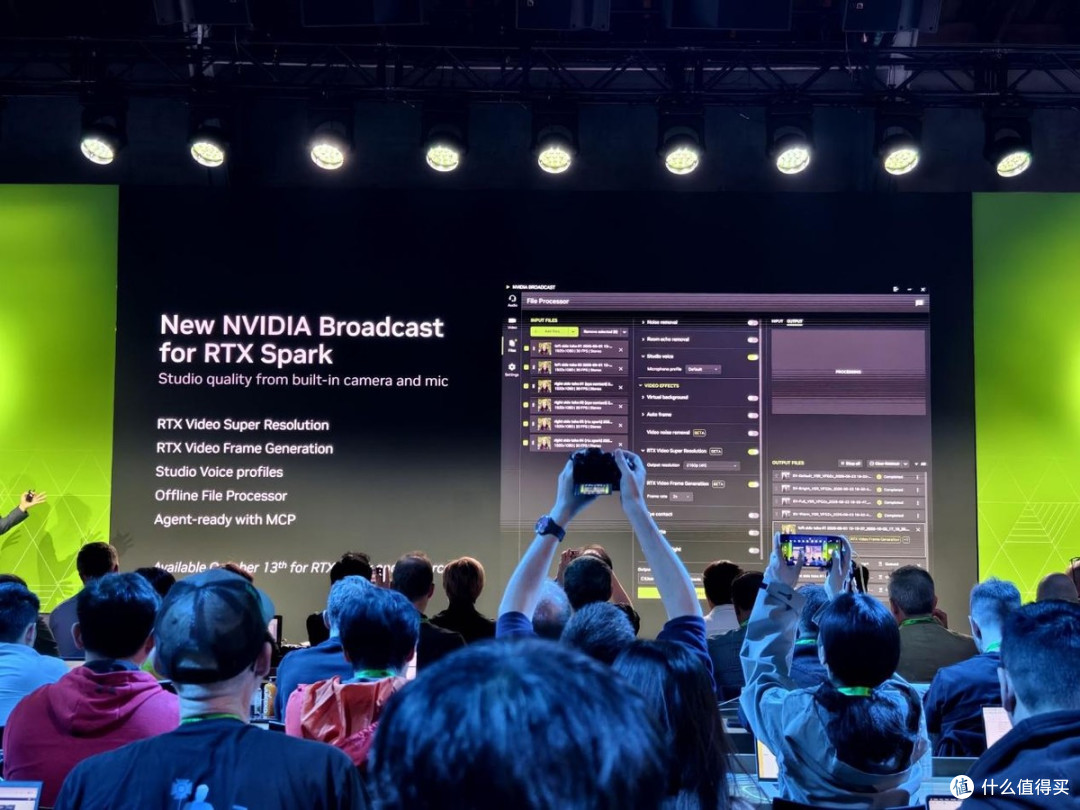
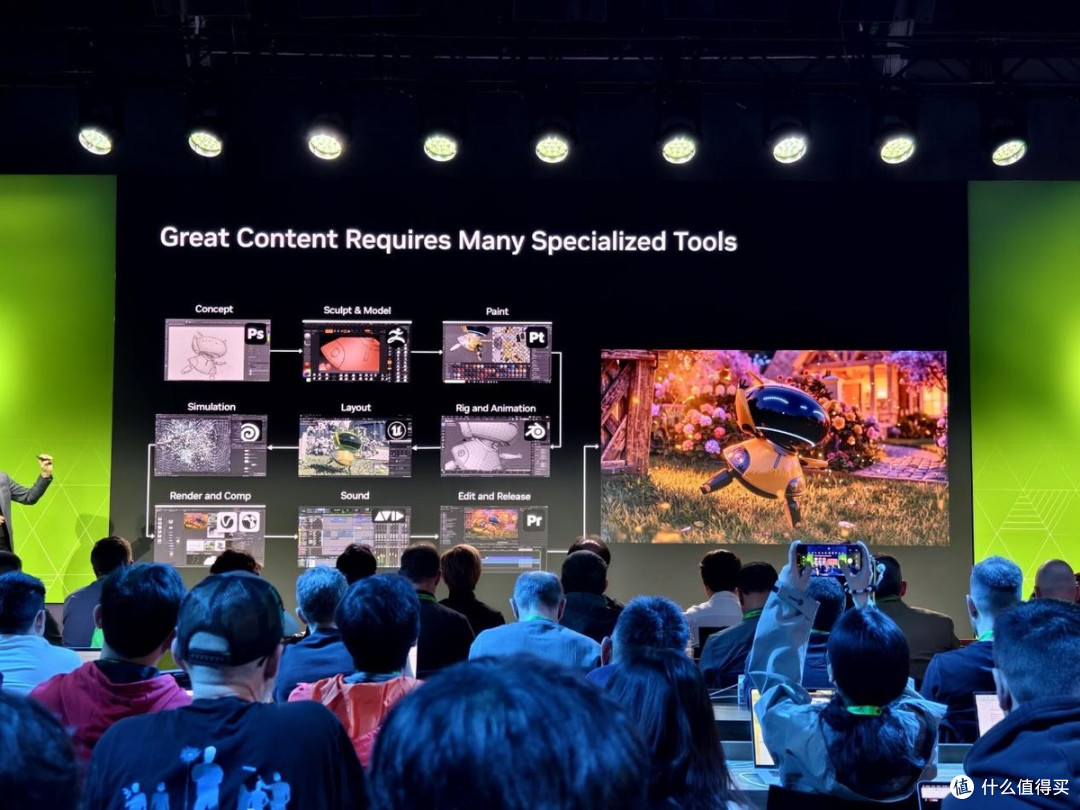
创作者有品味、有野心、有想表达的东西,但常常被执行能力卡住,指望一个人精通当今复杂管线的每一个工具是不现实的。RTX Spark通过创作应用、生成式AI、创意技术三个方面涵盖创作与生产力。
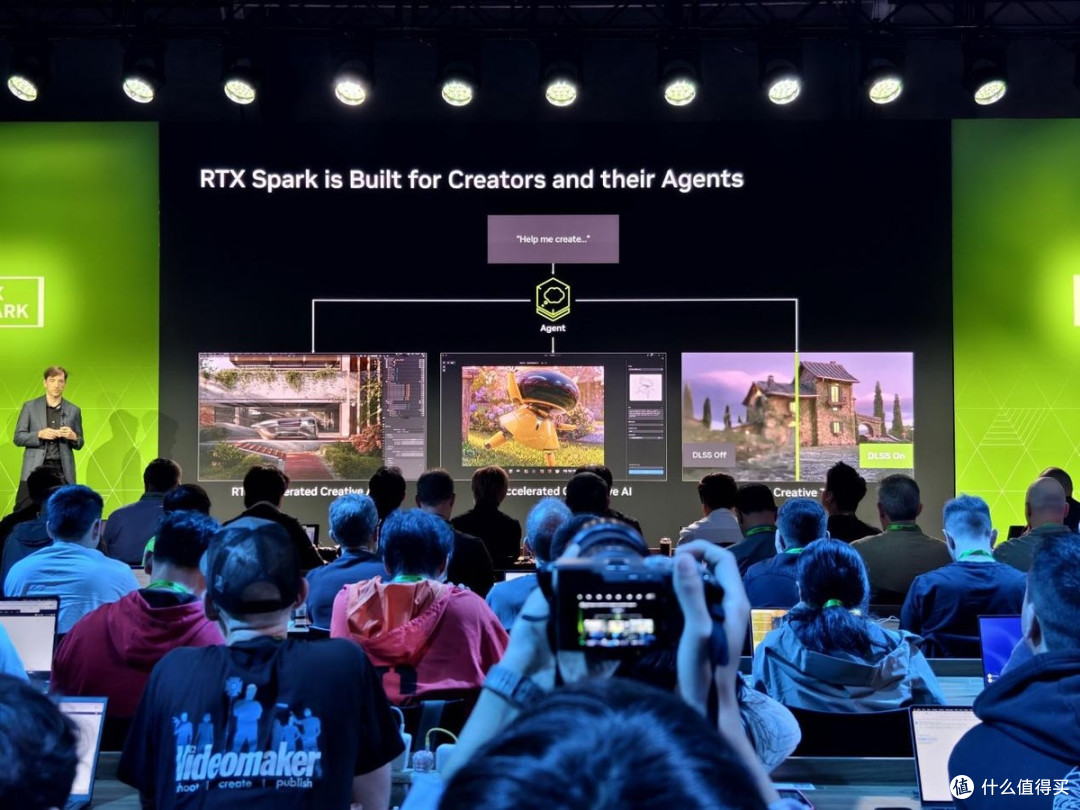
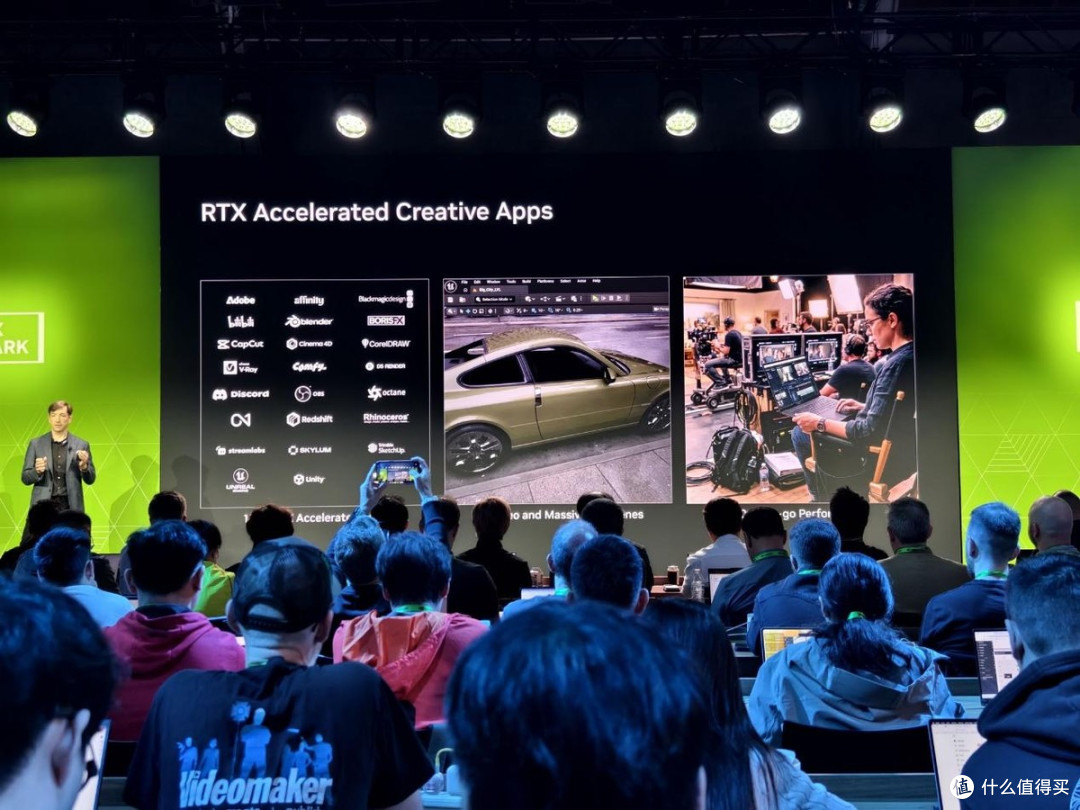
目前为止,已经有超过130款RTX加速创作应用提供支持,包括Premiere、Photoshop、Blender、虚幻引擎、达芬奇等,且当天许多应用宣布或已发布MCP服务器,开放智能体控制。在现场展示中,RTX Spark N1X可以很好的运行虚幻引擎编辑器内一个70亿量级多边形的曼哈顿地图大场景,通过DLSS 4.5实现120FPS的帧率,要知道,这可是一款轻薄型笔记本。
同时NVIDIA也强调,由于整机功耗在100W以下,在拔电状态下,体验也是没有衰减的。当然这也得益于软硬件对NVFP4的支持,因为FP4模型更小、质量相当、性能还能提升1.5倍,128GB统一内存可同时常驻多个模型随取随用,且本地生成不按次数收费。
ComfyUI也已经宣布支持RTX Spark和所有GeForce RTX平台,原生内置视频超分辨率与帧生成,支持1080p 30fps的摄像头实时提升画质与帧率,提供音棚音效 三种音色、离线文件处理器,以及基于MCP服务和Skill的智能体支持。
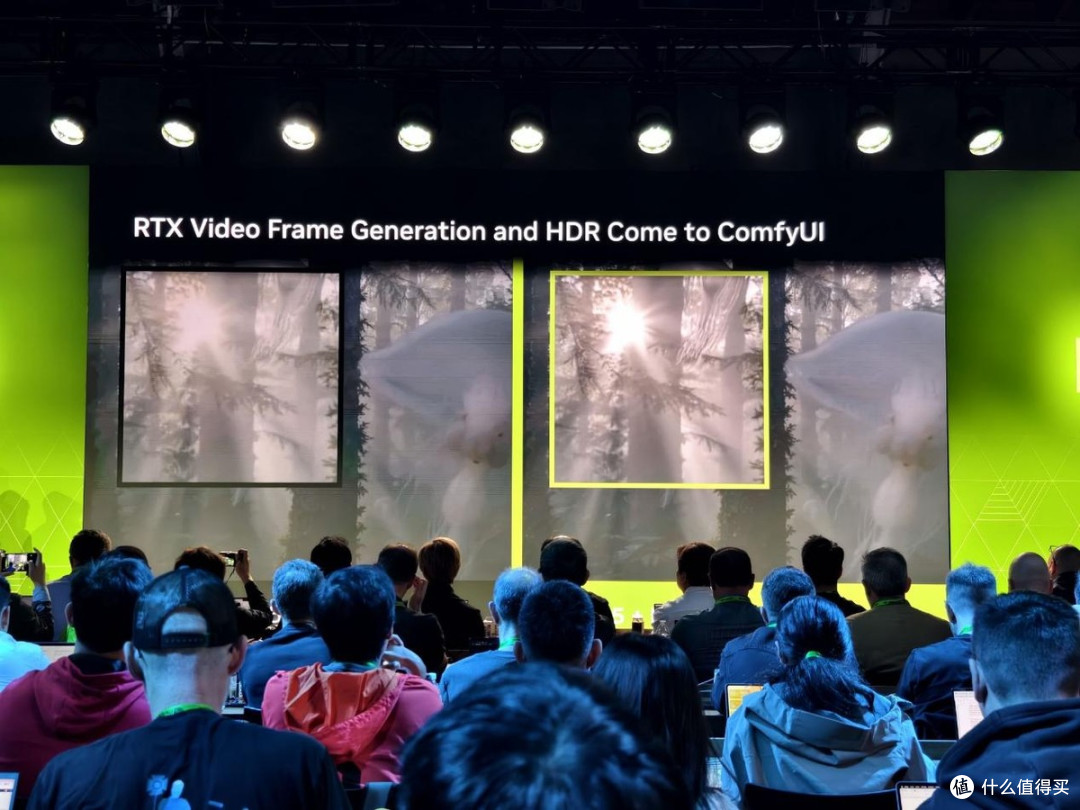
DLSS 4.5光线重建则已经引入Blender 5.3中,Cycles视口可以实现交互式路径追踪级预览。NVIDIA强调,知道想做什么和知道怎么让每个工具做是两回事,智能体的价值是在用户的专业知识断档处接上技术协助,只需要说一句“渲染出来、做真实些”,剩下的让智能体自己去社区找ComfyUI管线并跑起来。
创作者被要求多模态的压力也是前所未有的。几乎每个项目都要混合图像、视频、音频、动效和3D,AI正贯穿构思、创作、生产全流程,创作者掌舵眼光、品味和判断,智能体则充当助手的角色。目前Adobe Photoshop、Premiere、Substance 3D已经针对RTX Spark优化,AI编辑特效最高2倍提速。

开发者部分亦是如此。NVIDIA表示开发者不再逐行手写代码,而是指挥写代码的智能体,单一开发者由此能掌控更复杂的平台。目前全球大约有1,500万开发者,但未来如果不用编程,只通过自然语言与AI 智能体完成软件开发,这将是一个巨大的市场。
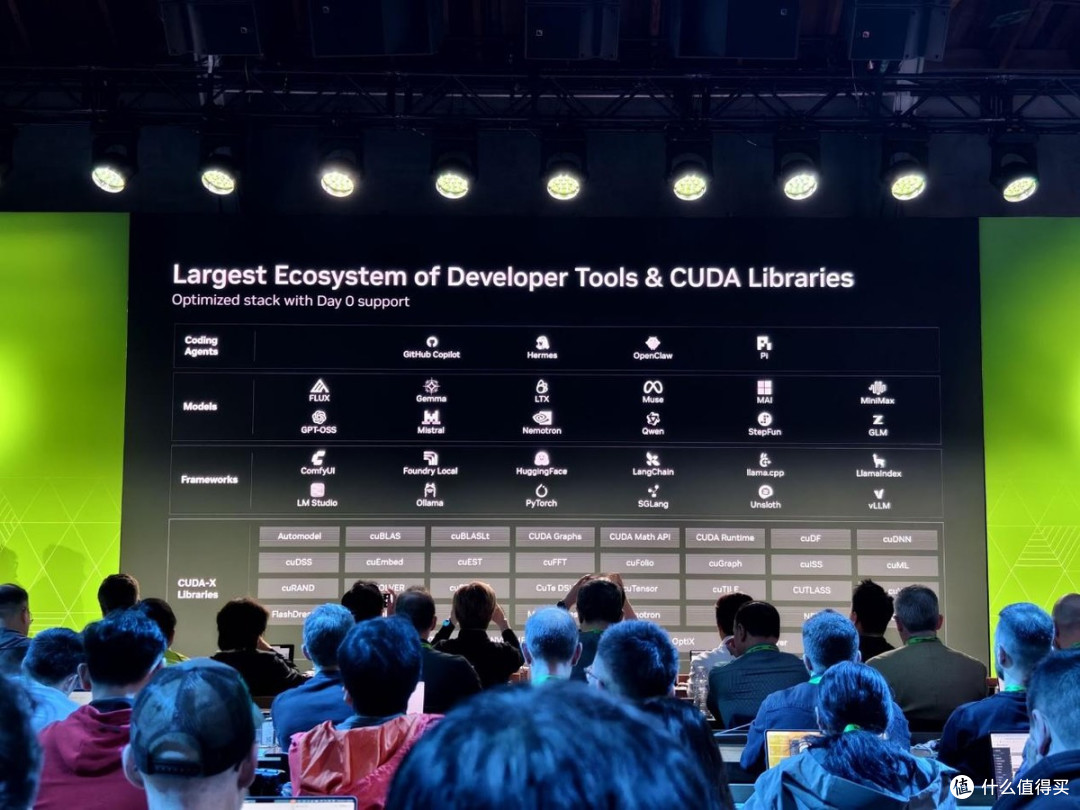
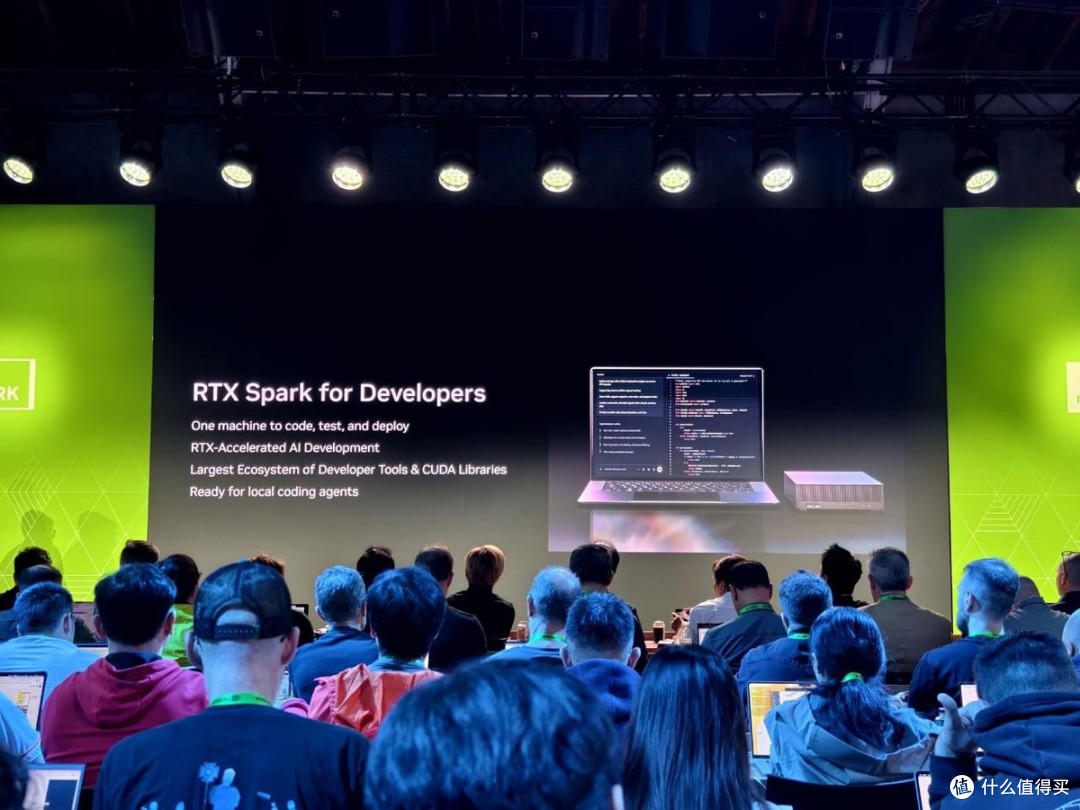
RTX Spark在其中承担起完整的开发流程,编码、测试、部署可以在同一台机器上闭环。Windows开发者配置,外加WSL打通Linux框架与云端发布。并且在RTX Spark上验证,等于直接面向超过1.5亿RTX装机量的目标平台,没有迁移门槛。
NVIDIA还与微软合作把PyTorch生态搬上Arm,超过2000个Arm原生开发包已经完成适配。NVIDIA Agent Skills还为所有CUDA库制作技能包,让智能体自己会调用CUDA生态,并内置进OpenClaw和Hermes,即使用户完全不懂CUDA,智能体也能协助完成。这意味着库的价值不再取决于人会学,而取决于智能体是否会用。
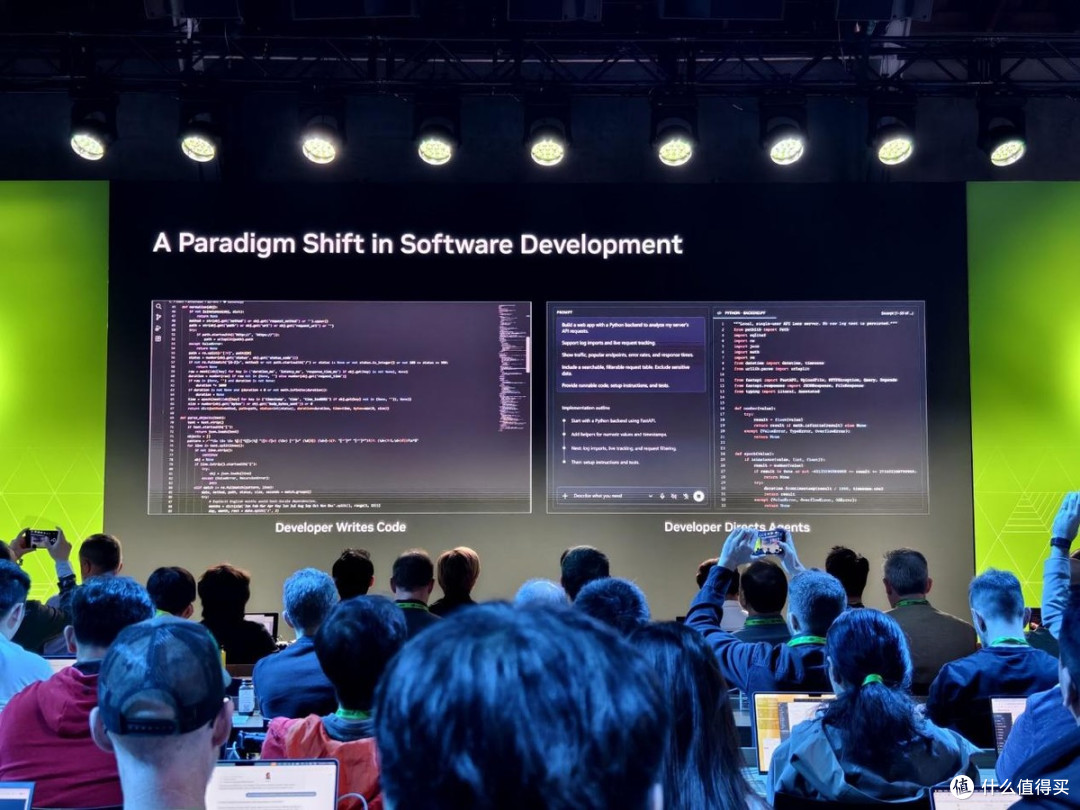
NVIDIA认为未来将是目标导向编程(goal-oriented programming),开发者不下具体指令,只声明目标,智能体自己跑完整个流程。只是这个过程的隐患在于你不知道智能体要跑多少轮,云端按token计费时这就是赌博,本地免费运行成了更理想的解决方案。同时决策模型(Decision Models)可以快速做出下一步动作,从而避免长推理链才能得出的结论,从而加速开发进程。
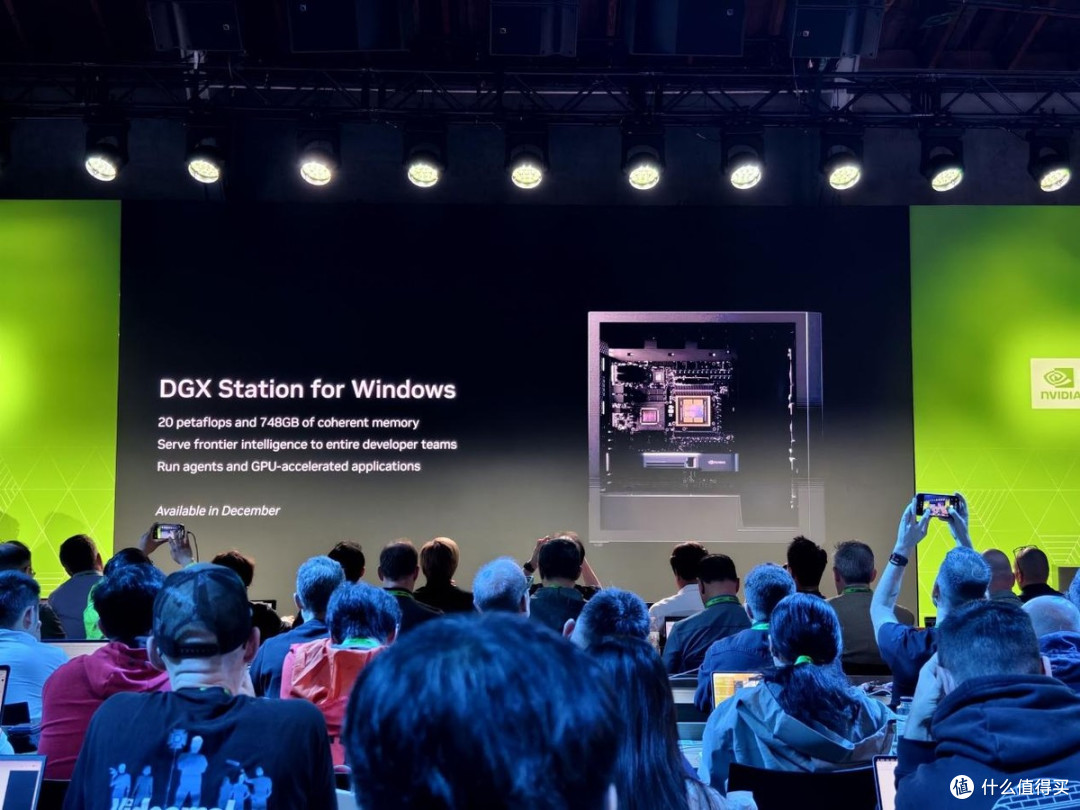
今年早些时候发布的DGX Spark已经能够很好的运行GLM-4.6 Flash级别的模型,今年底推出的DGX Station也将推出对Windows支持,这让全球的Windows用户和开发者可以借此构建GB300级的前端智能应用。
RTX Spark游戏
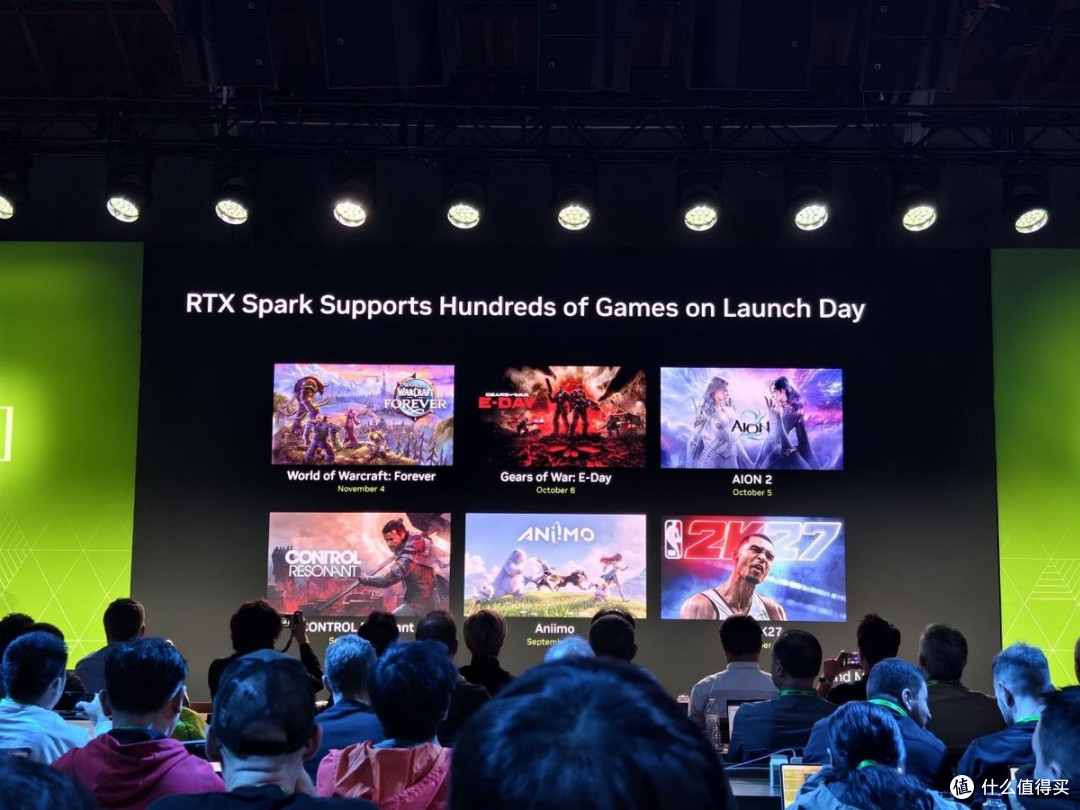
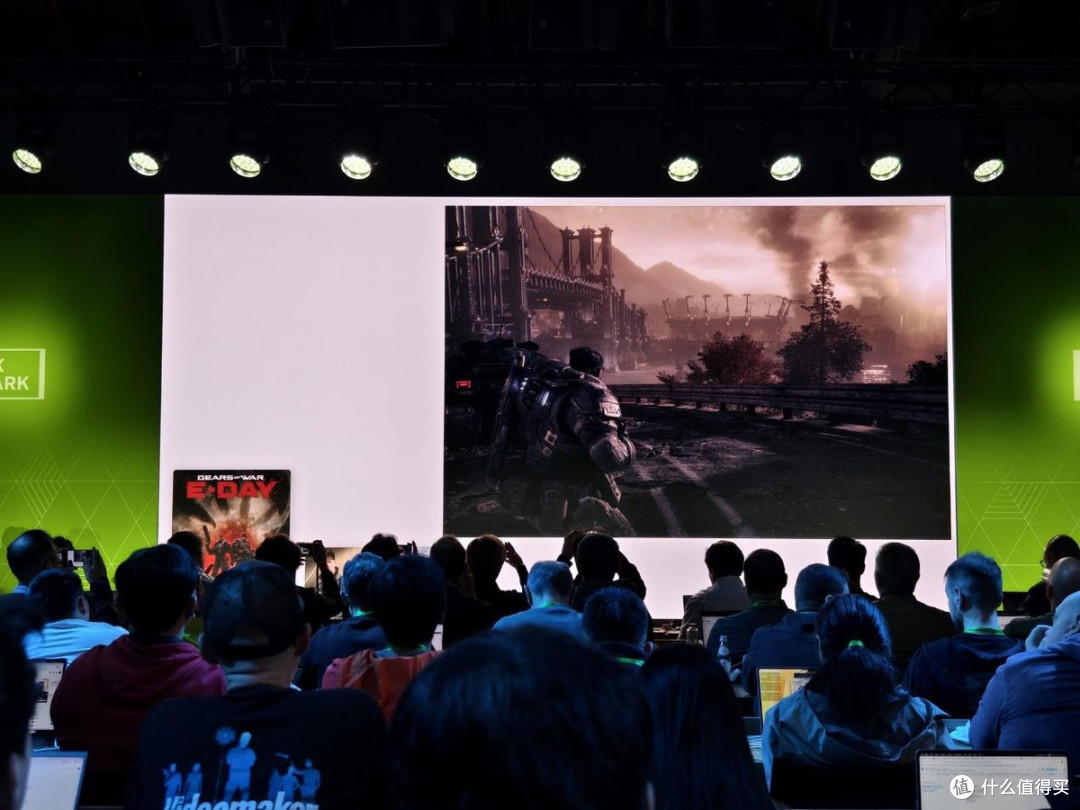
这是普通消费者最关心的部分,Windows on Arm已经开始打通Arm和x86的隔阂,接下来则越来越快。RTX Spark则可以承接2018年以来的RTX硬件血统,通过RT Core和Tensor Core搭配,以及游戏工作室的适配,让RTX Spark笔记本发布首日就可以支持数百款游戏,包括《战争机器:E-Day》《纪元117》《NBA 2K27》《控制:共振》。
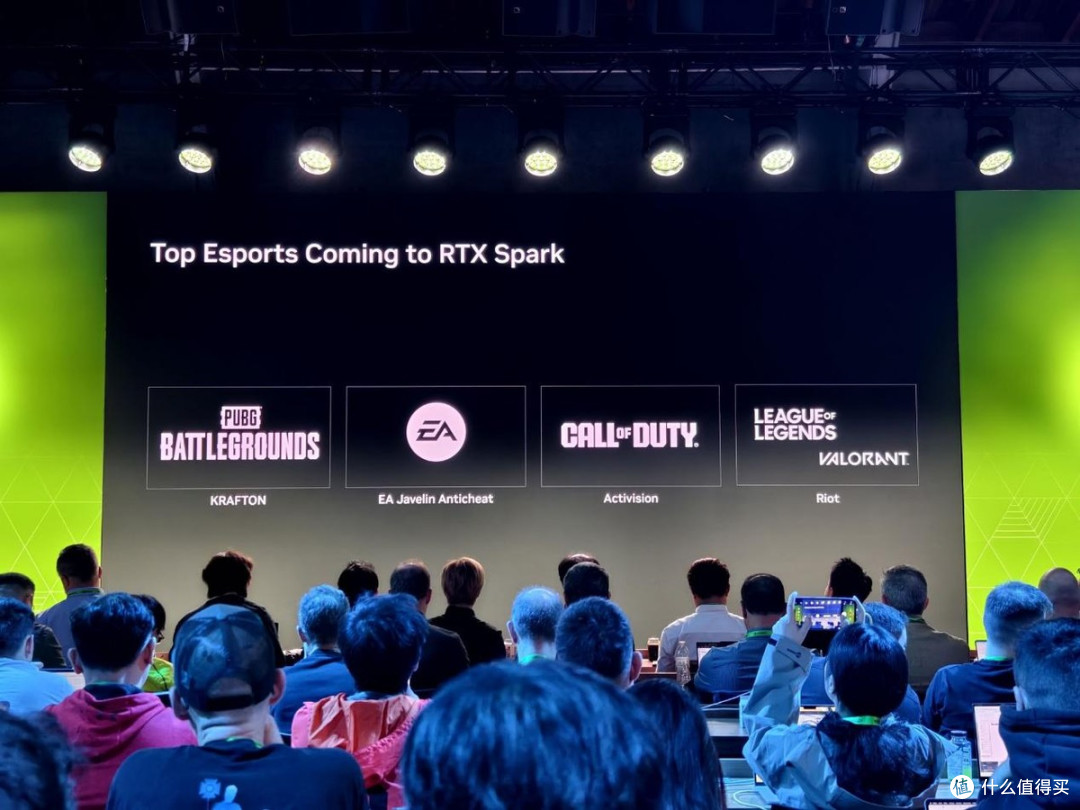
而让更多玩家关心的内核级反作弊需要底层工程整合、硬件验证与严格安全测试。NVIDIA 与微软及头部反作弊厂商完成了关键一步,目前已经能够支持《堡垒之夜》《ARC Raiders》《漫威争锋》,在今年秋天《PUBG》《英雄联盟》与《无畏契约》也将会落地。
微软在其中也发挥了相当重要的作用,例如攻克内核级别反作弊,让Arm设备也获得信任。持续着色器投递(Constant Shader Delivery),与Xbox团队合作,将下载游戏、启动,着色器自动编译并投递到设备,这项推广将会应用到RTX Spark及所有RTX GPU中。
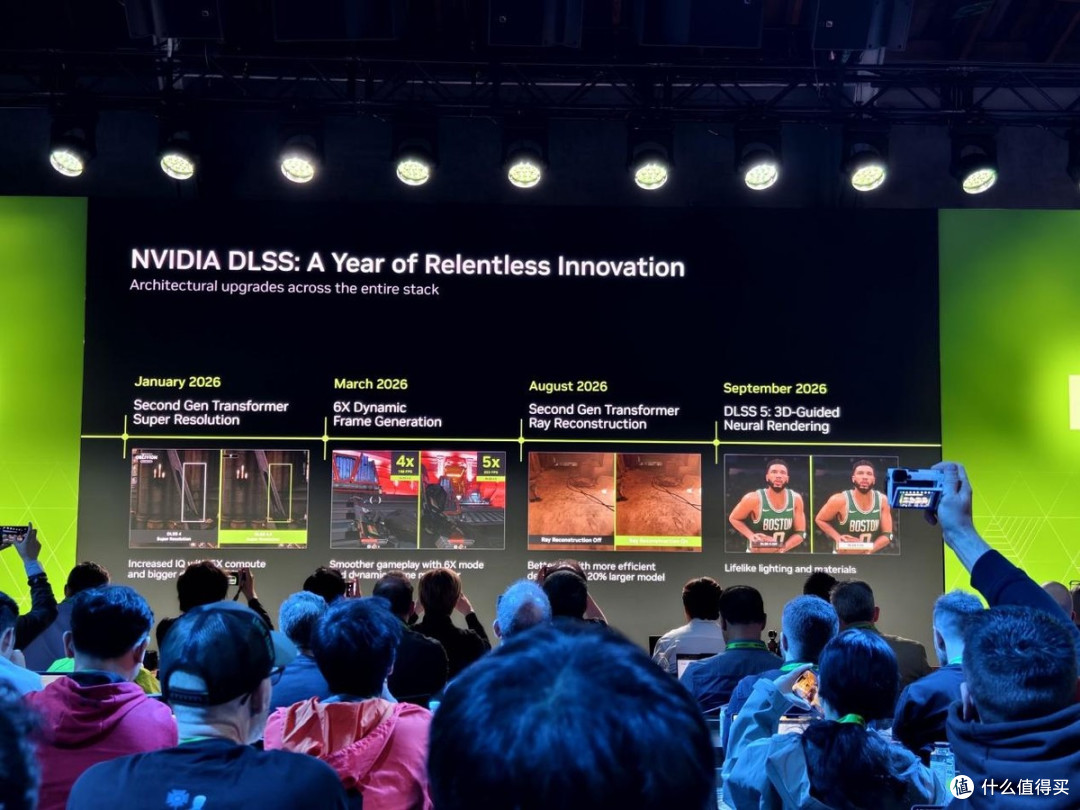
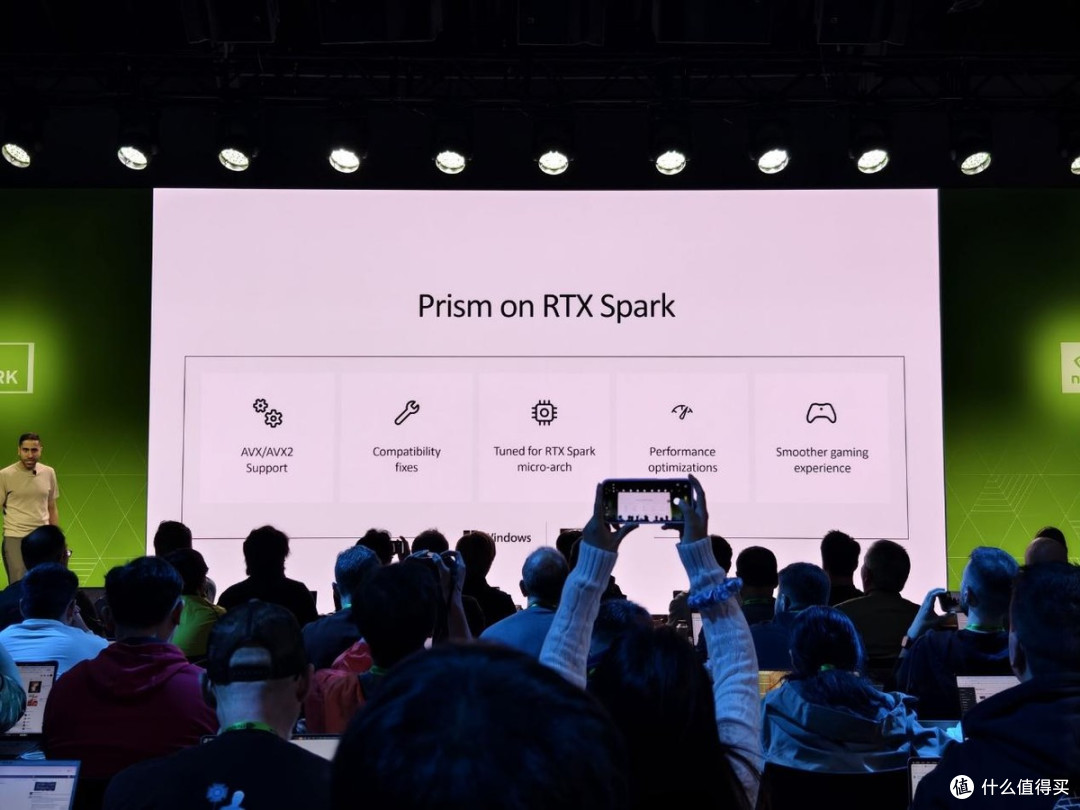
关于Arm所需要的Prism翻译层,目前Windows上有数十年游戏遗产要兼容。去年已为CPU密集型应用补齐AVX/AVX2指令集模拟,并且每月推送兼容性和模拟器更新。微软表示,翻译将针对RTX Spark N1X微架构深度优化,特别是1% low帧率优化和平均帧率优化,为游戏体验一致性提供保障。首发的阵容包括《战争机器:事变日》《007初露锋芒》《天国:拯救 2》。
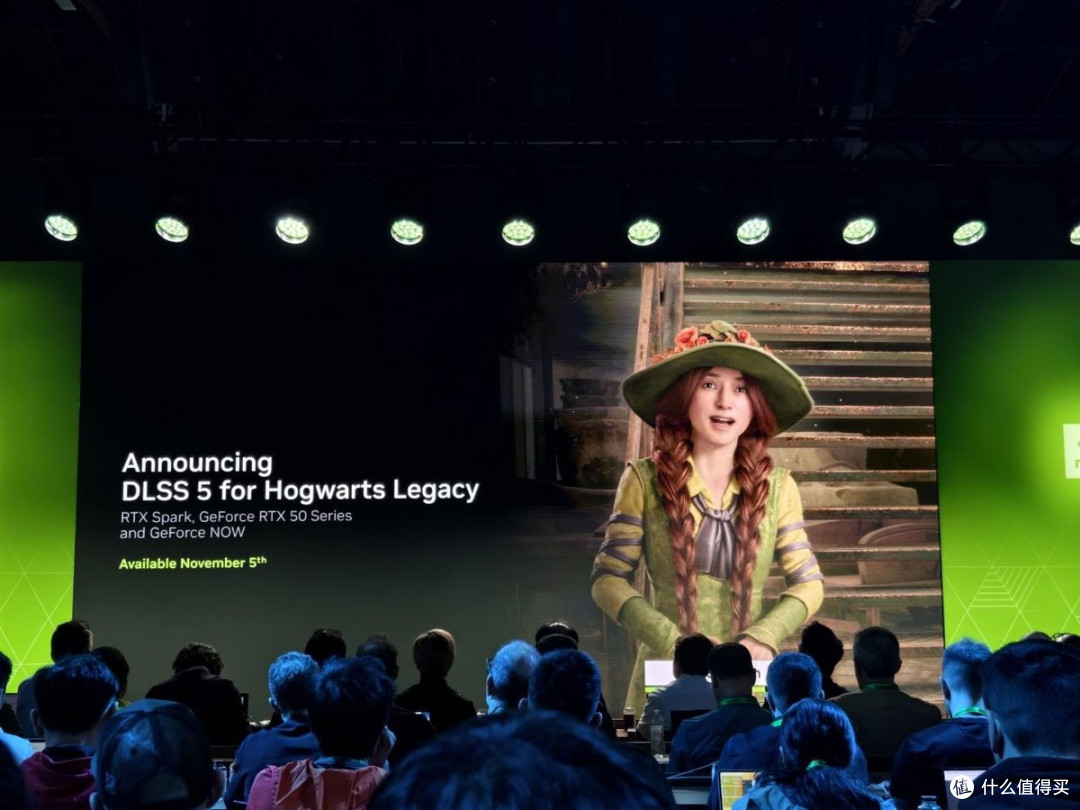
RTX Spark在支持DLSS 4.5的同时,也完成对DLSS 5的匹配,Transformer模型速度提升2倍,帧生成性能模式提速33%。另外《霍格沃茨之遗》《原神》都将在近期完成对DLSS 5的支持。
游戏智能体也是RTX Spark的另一个应用方向。AI队友PUBG Ally在今年夏天已经公测,通过自然语音交互就能帮助新玩家完成吃鸡。第二代Nemotron模型则应用在宠物和基地经营类游戏中,而第三代小语言模型Nemotron 3.5 Nano专为更聪明、更快的AI角色打造,对话式智能体任务准确率提升1.5倍,支持可调的对话推理模式,开发者在精度与性能间自己权衡。模型基于Google Gemma构建,训练配方开放,开发者可用自有数据针对游戏内容微调,10月23日经Ollama、Unsloth、llama.cpp等渠道发布。
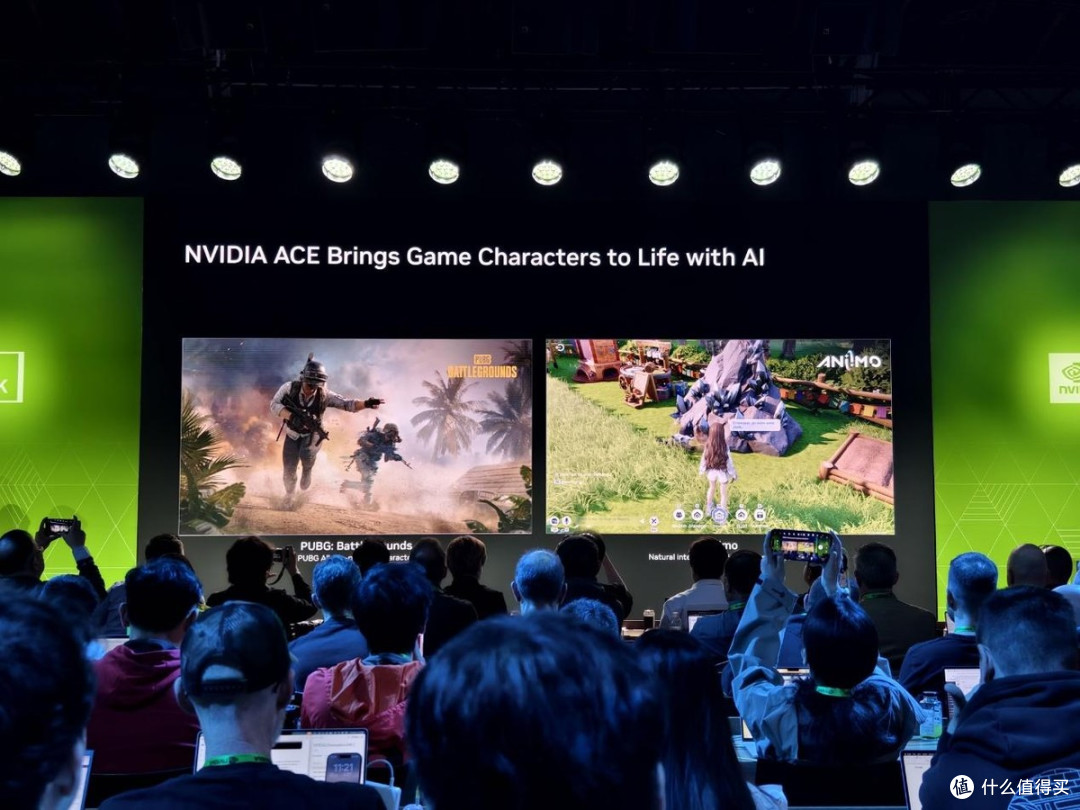
另外MOD社区也诞生了两条MOD生态,通过实时AI把原本游戏中的NPC火起来,另一个则是通过AI编码智能体让老游戏获得RTX兼容,这也是过去一年中RTX兼容项目翻倍的原因。
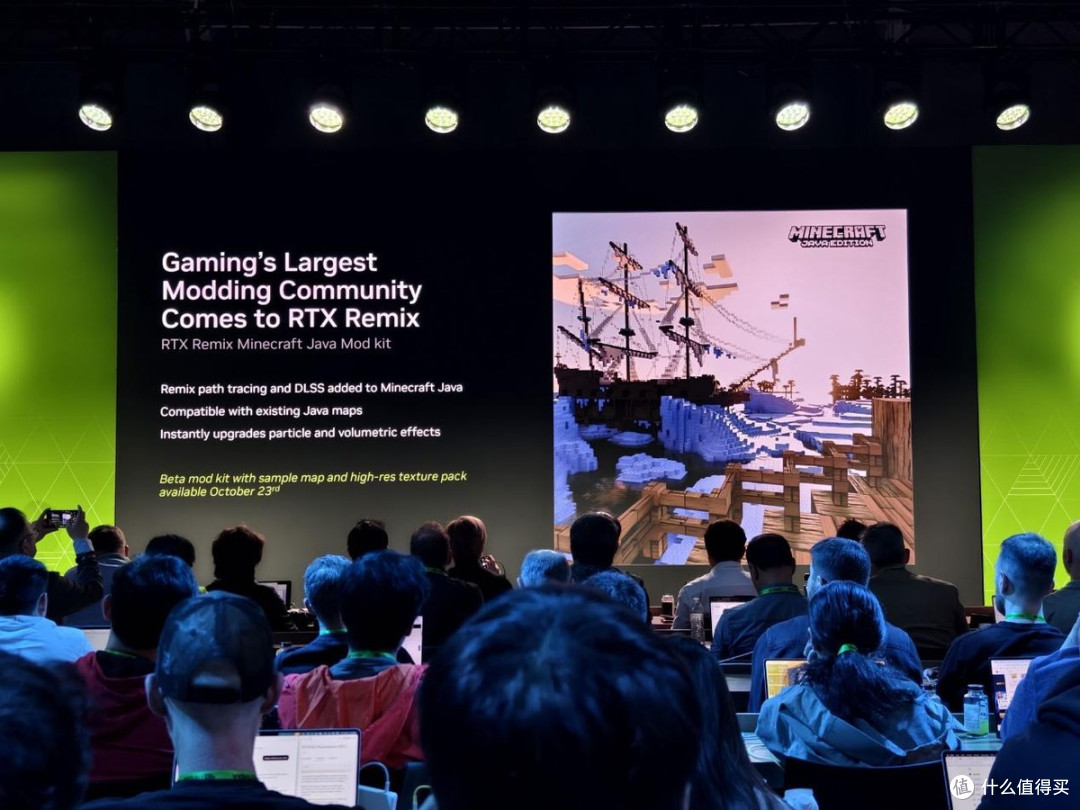
在活动现场还展示了《我的世界》Java版Mod Kit和《我的世界》DLSS 5,Java版Mod Kit AI智能体可加速mod开发,兼容存量Java mod,并让mod获得路径追踪与DLSS升级。《我的世界》DLSS 5实验版本已经在9月份开始测试,在10月23日将会全量推出。
Windows AI 智能体架构与混合智能
RTX Spark笔记本的推动少不了Windows支持,事实上微软也希望通过这一步提升Windows on Arm对行业的影响力。
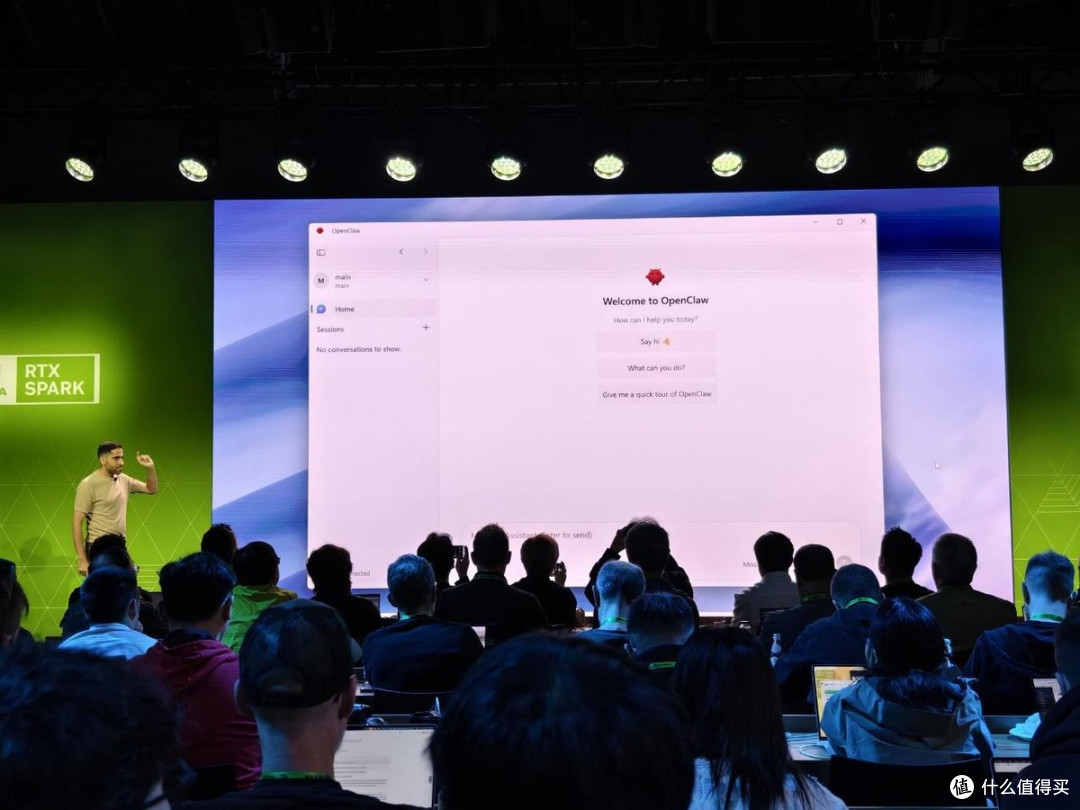
首先改变的是极简单的智能体开箱体验。通过Windows首次登录时候的弹窗入门引导,智能体安装到启动只需要2次点击即可完成。微软表示智能体纳入Windows管理,装好的智能体像系统组件一样被Windows托管——安全更新、功能更新自动下发,用户不用自己惦记着升级。如前面所言,Hermes、Perplexity、OpenClaw已经在默认的支持列表中。国内WorkBuddy也很快成为选择之一。

智能体的入驻,也改变了Windows的安全结构。微软MXC的做法是对智能体做出隔离,把每个智能体放进独立容器,用户精细定义它能碰什么。第二个就是给智能体另一个用户的身份,会话级隔离让智能体拿到自己的身份和凭证,而不是借用用户的,从而进行更好的控制。第三个则是IT部门对智能体的规模化策略管理,为接下来的企业部署铺路。
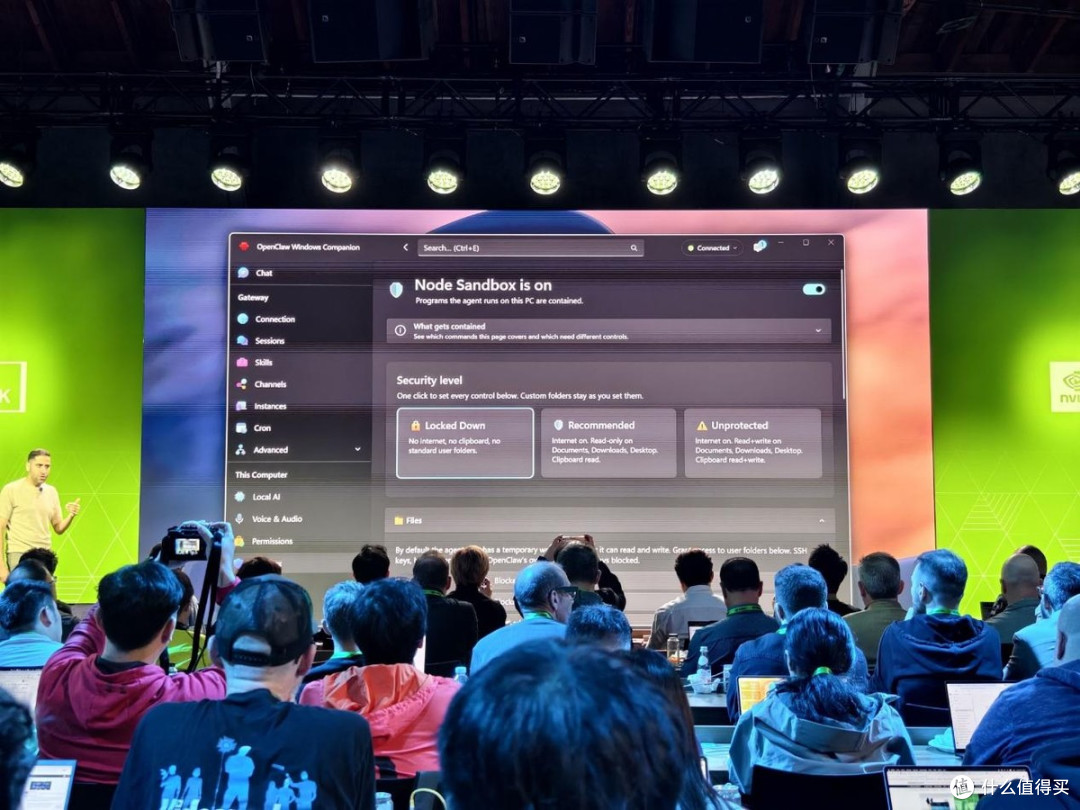
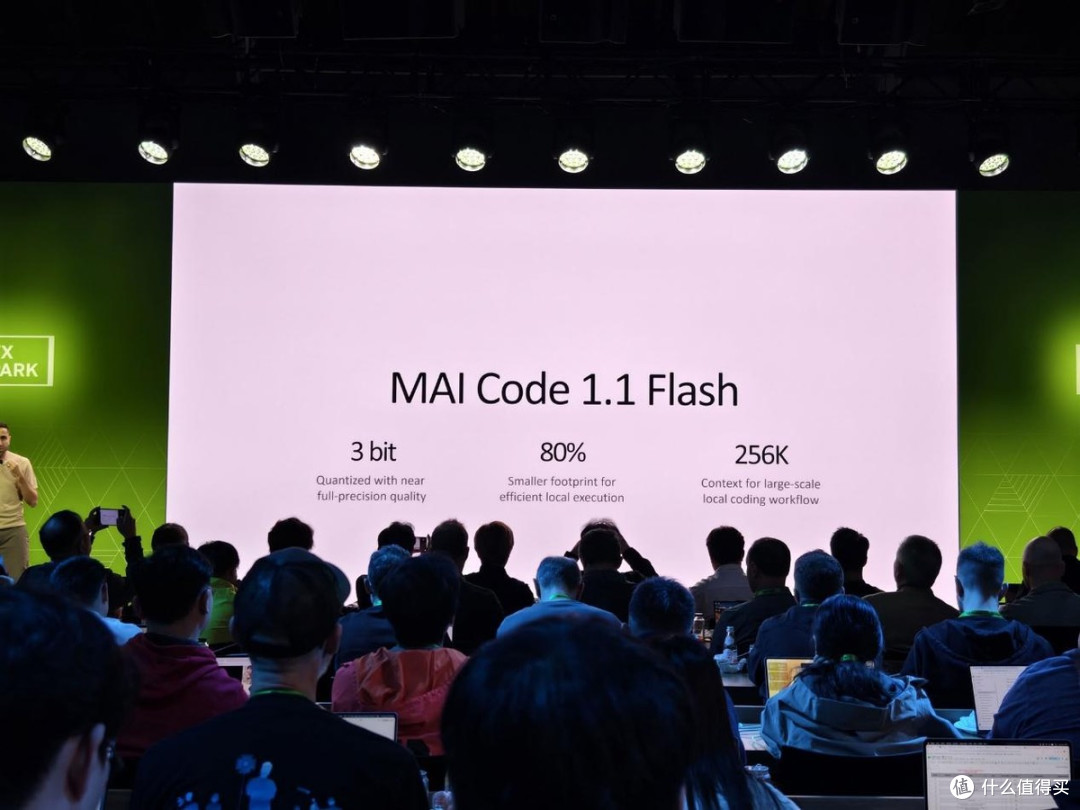
同时Windows采用混合智能(Hybrid Intelligence)与Copilot自动编排策略,系统根据任务复杂度与设备上可用模型动态决定推理发生在本地还是云端。微软还推出了MAI-Code-1.1-Flash本地版,这是微软自研的137B参数编程模型推出3-bit量化模型,体积比云端版小约80%,保留超长上下文,专为编码与复杂任务本地运行准备。
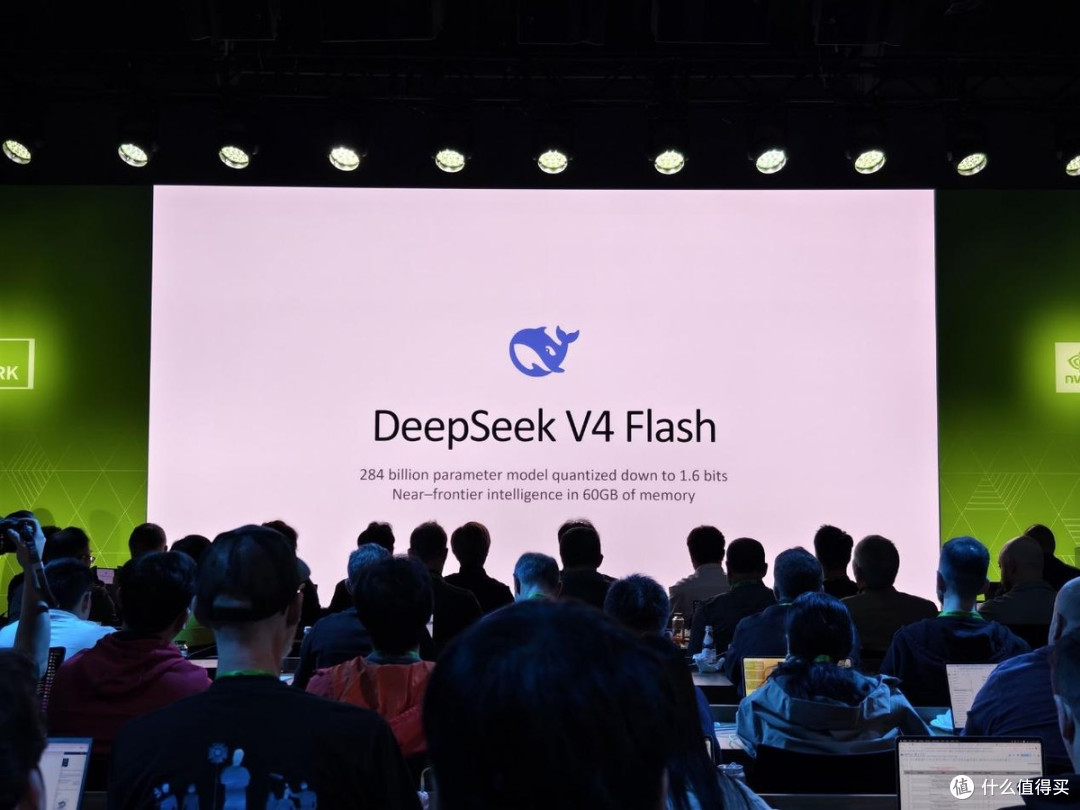
另外微软也尝试把DeepSeek V4 Flash 2,840亿参数的前沿模型量化到约1.6 bit,跑在RTX Spark上,让RTX Spark笔记本也存在一定的能力表现。
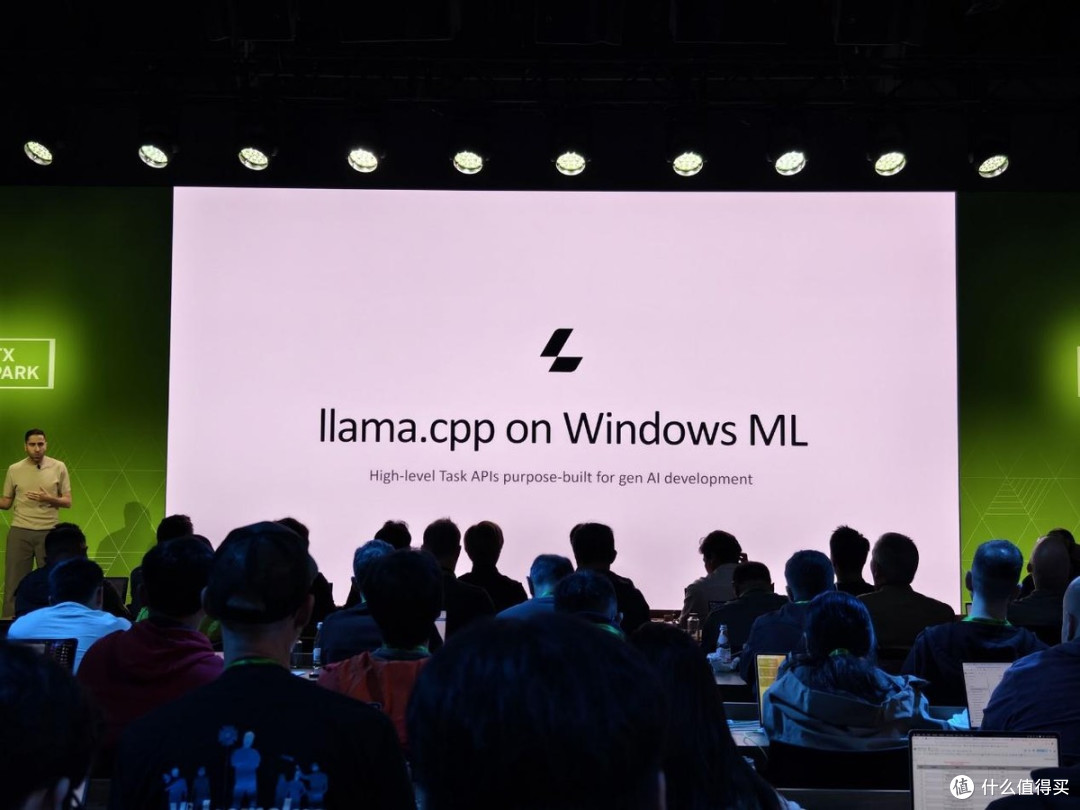
在平台层面,llama.cpp已经获得Windows ML支持,用户喜欢的开源模型可以通过llama.cpp在Windows ML上运行。
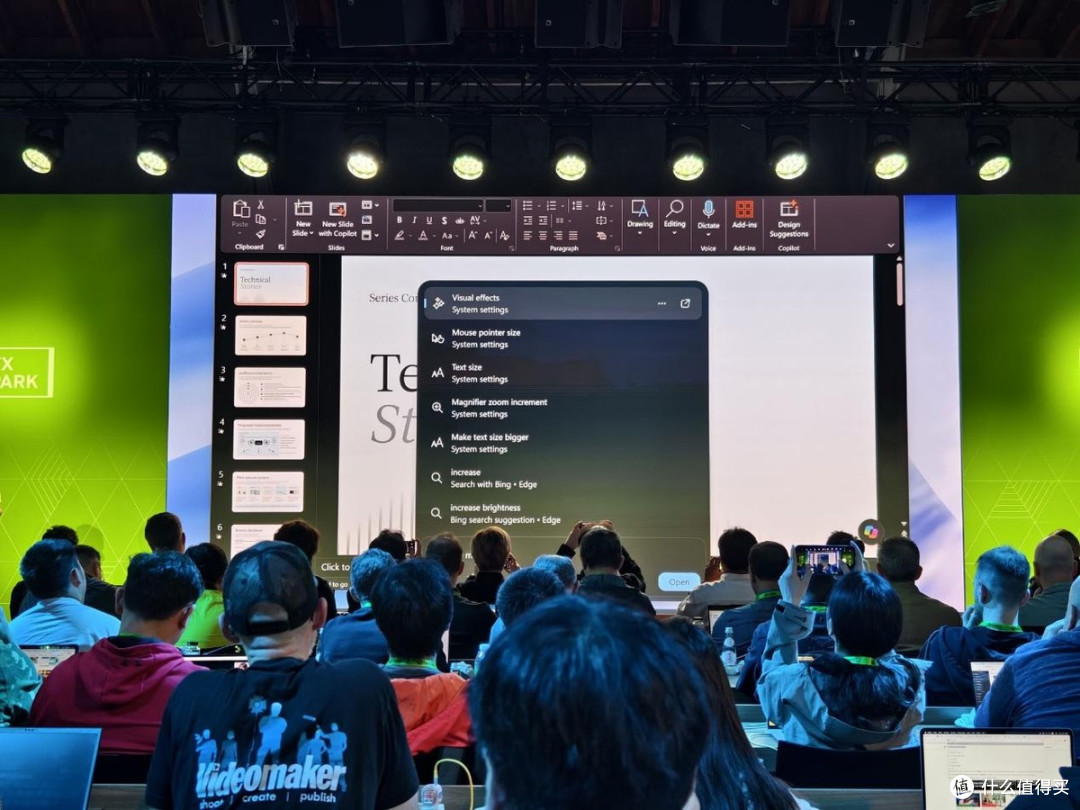
Windows搜索功能也获得了更新,首次引入动作搜索(action search),用自然语言直接执行操作,比如移动任务栏、切换深色主题,或者以Xbox模式启动游戏。搜索栏和任务栏将成为用户发起任何操作的入口。
为了让RTX Spark的128GB统一内存塞入更大的模型,微软做了许多工作,同时刻意保留一部分空间给系统和应用,确保持续流畅不卡死,内存常驻策略针对不同加速器分别优化。在过去一年中,Windows on Arm的电源、性能、续航、模拟器的全面优化打磨,所有的改进都会在RTX Spark笔记本出货时付诸实践,包括WPS调度、MPTF电源热框架、GPU可访问内存上限提升、DX12神经网络渲染等条目。
写在最后
回到最初的问题:RTX Spark笔记本到底是一台什么样的PC?
硬件上,RTX Spark是NVIDIA把数据中心级Blackwell架构塞进45–80W功耗笔记本的一次工程秀。但真正让这台机器成立的,是软硬件的组合拳。Windows on Arm为智能体重写了隔离与身份机制,Blender、Adobe、DaVinci等创意工具链已经完成了原生迁移。而NVIDIA独门秘籍DLSS 4.5和DLSS 5、Reflex、路径追踪硬件天然就对游戏提供了很好的适配。
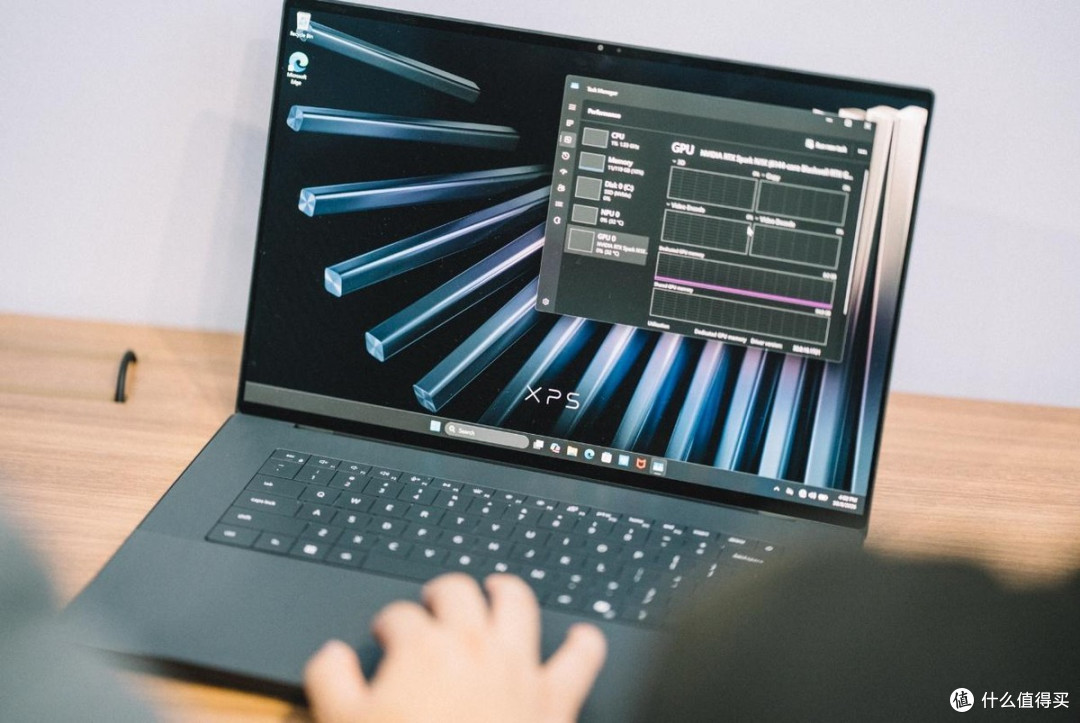
不仅如此,128GB统一内存做到了大多数桌面显卡也办不到的AI应用扩展,而Switchyard与PAIR则把视野伸向了更远的地方,让家里的每一台设备都成为个人AI的算力来源。
当然,超过1.5万元的起售价意味着它注定不是大众产品,但这样的尝试非常值得,这也是近十年来PC新品少有的能给笔者带来莫名的兴奋感。完全有理由期待RTX Spark笔记本以及其终端设备对移动娱乐、游戏、创作和AI生态带来的变化,正如Spark“星星之火”的寓意那般,点燃下一场PC行业的变革。