十月二十六日,一条小红书笔记把话说得很满:预测下一个 token 的范式,将在未来三年内被自回归扩散模型全面取代。小红书
发帖人自述是浙江大学人工智能专业在读博士,笔记拿到 1937 个赞。两天后,它被搬到知乎,成了这周 AI 圈讨论最集中的话题之一。
把发布会数据、第三方测试和从业者的判断放在一起看,结论没那么戏剧性:扩散模型确实追到了能和同尺寸自回归模型正面比的位置,但「三年内全面替代」还缺证据。
十月二十八日,DiffuSpace 发布 Clover-35B-A3B-Preview:350 亿总参数、30 亿激活的 MoE,支持思考模式,Apache 协议开源。扩散智能DiffuSpace
单张 GB300、BF16、batch size 1,官方测得 680 tokens/s。
SWE-bench Verified 73.6,Terminal-Bench 2.1 51.7,τ³ Overall 65.3,三项都高于同尺寸的 Qwen3.6-35B-A3B。扩散智能DiffuSpace
更早一周多,Inception Labs 的 Mercury 3 把扩散路线推到更大规模:总参数比第一代扩大 40 多倍,输出速度仍有每秒 1068 token,官方称最高比 GPT-6 Luna 快约 8 倍。36氪
这些数字推翻了「扩散模型只能做小模型、只能图快」的旧印象,但没有推翻全部。
它们几乎都来自厂商自测。Clover 的跑分都是官方自报,第三方复现还没跟上。
Mercury 3 的独立评测也少。Bito 的小样本编程测试里,它在规划环节落后 18 分。
知乎答主 theNeverland 认为,扩散模型的旧短板没消失:训练成本更高,同等算力下学习效率不如自回归;解码还有额外计算,小 batch 快,大 batch 很难比。知乎
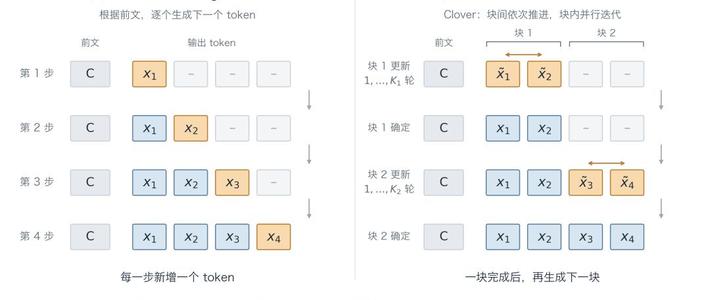
知乎答主恋猫指出,块扩散为了 KV Cache 复用和长文本,又把块间的串行依赖加了回来,多轮去噪的成本仍要付。
刘聪NLP 的拆解显示,Clover 用 Qwen3.6-35B-A3B 的权重初始化,再做扩散训练,不是从零预训练一个扩散大模型。知乎
这解释了它为何能直接站在 350 亿参数的自回归底座上,也说明现阶段的「替代」更像「自回归底座 + 扩散改造」。
真正会先变的,是任务分工和推理栈。Agent 每一步都要等模型返回,延迟会沿调用链累加,速度直接折算成任务完成率。
Clover 在 49 项网页 Agent 任务、每项 3 次尝试里,中位执行时间 1.52 秒,Gemini3.6 Flash 是 8.86 秒。知乎
但云端高并发是另一回事。批处理本来就把 GPU 算力吃得较满,扩散能捡的闲置算力变少。
梦回1874 的文章提到,Google 在 DiffusionGemma 文档里提示,它更适合单用户、低并发的本地场景,高 QPS 下并行解码的收益会递减。
所以短期更可能出现的是「强模型做规划、扩散模型做执行」的组合,而不是整条链路换掉。
回到那条小红书笔记。它说对的部分是:模型能力逐渐饱和后,速度(也就是成本)会比指标高低更重要。小红书
它说得太满的部分是「三年内全面」:长链推理、训练效率、高并发服务,这三关都还没有扩散模型稳定赢下的证据。
更准确的判断是:扩散模型会先拿下代码补全、工具调用、结构化输出和端侧,而不是把大语言模型整体换掉。
对使用者,这不是站队题,而是多了一个按任务挑模型的选项。对做 Infra 的人,麻烦才刚开始:块并行调度、状态缓存、推理引擎适配,都要重新做。