






 深耕数码兴趣领域



7
5
比 Opus 便宜一半,凭什么说"逼近旗舰":聊聊 Claude Sonnet 5.5
2026-09-30 10:17:33
0点赞
0收藏
0评论
 图片
凌晨,Anthropic 又把 Claude 家族的中杯更新了——Claude Sonnet 5.5 正式上线。距离上一款旗舰 Opus 5.5 发布才过去六天,官网、API 同步开放,AWS、谷歌云、微软 Azure 全平台都能用。
这代 Sonnet 的官方口径,可以浓缩成一句话:中杯卖大杯的本事,价格还是中杯的价。
一句话划重点:输入每百万 token 2 美元、输出 10 美元,价格跟 Sonnet 5 一模一样,只有 Opus 5.5 的一半;官方自测智能体编程成绩暴涨近 7 倍,速度提升 30% 以上。
先看价格。定价照旧,但官方给出的几项测试成绩,已经贴到旗舰脸上了。
编程成绩,是这次最夸张的地方
 图片
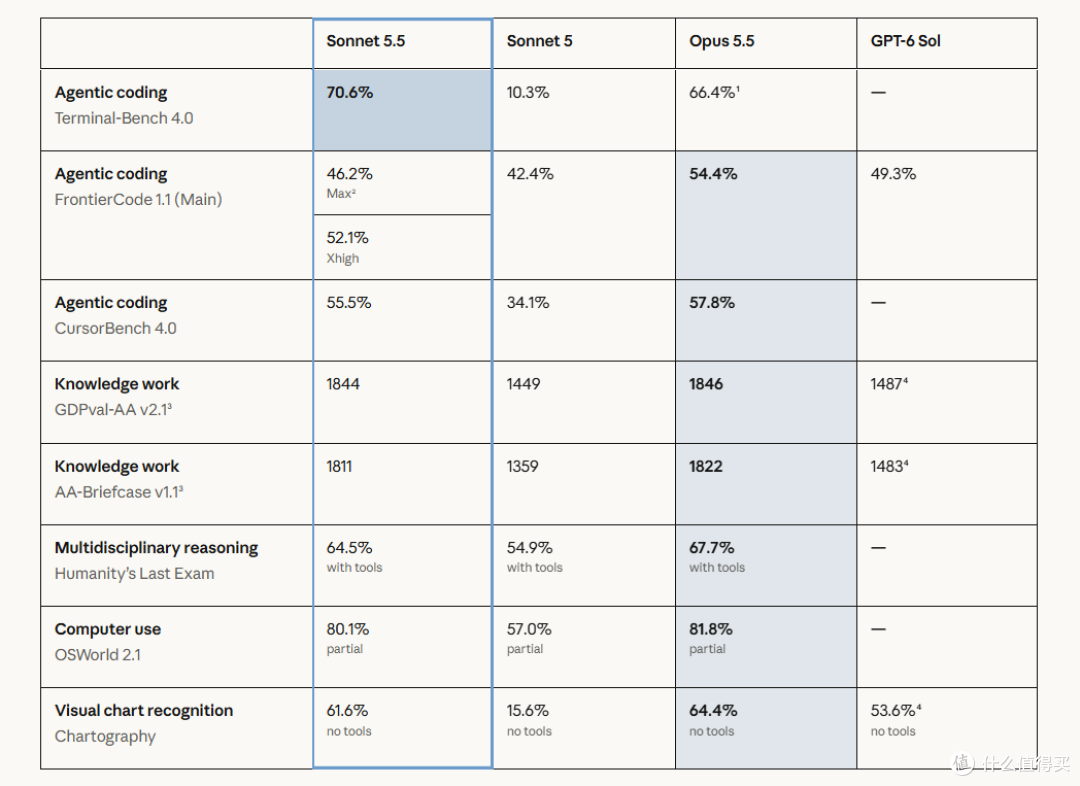
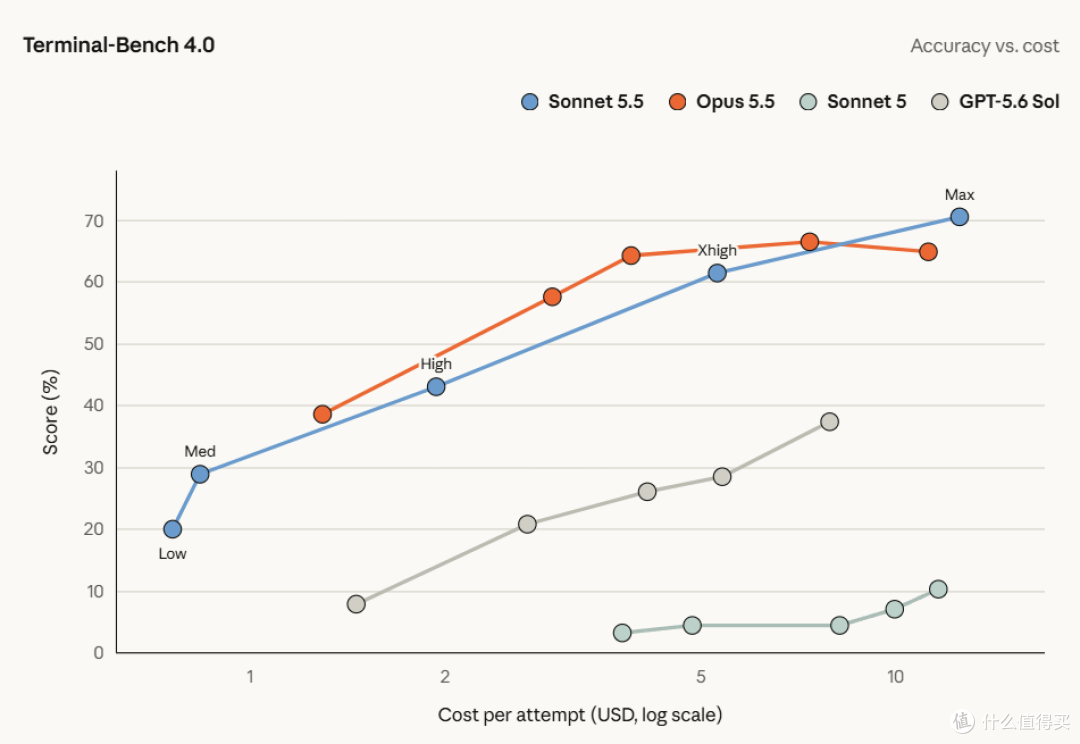
智能体编程测试 Terminal-Bench 4.0 上,Sonnet 5.5 拿下 70.6%,上一代 Sonnet 5 只有 10.3%——翻了快七倍,有报道称这个分数还反超了 Opus 5.5 的 66.4%。
 图片
取材真实 Cursor 会话的 CursorBench 4.0 上,它最好成绩 55.5%,和 Opus 5.5 的 57.8% 就差两个点。覆盖 44 种职业真实任务的 GDPval-AA v2.1 上,1844 分对 1846 分,几乎持平。
速度是另一个卖点,官方称输出比 Sonnet 5 快 30% 以上。再加上它越来越会省 token,官方测试里完成同类任务的单任务成本最多能降 30%。
 图片
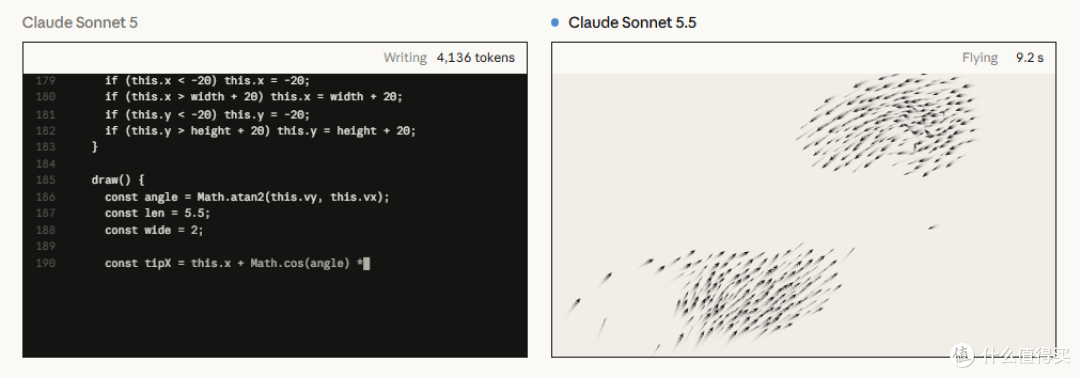
Anthropic 还放了个挺有画面感的案例:复原魔方,10 秒,0.11 美元。它也是第一个光靠看屏幕截图就能通关《宝可梦 红》的 Sonnet 模型。
注意:以上数字均为 Anthropic 官方口径。
但第三方算出来的账单,没那么好看
先泼盆冷水。第三方评测机构 Artificial Analysis 的榜单上,Sonnet 5.5 的 AI 分析指数 56,确实只排在自家 Opus 5.5(58)后面、Claude 家族包揽前三;但按它的算法,Sonnet 5.5 的单任务实际成本是 7.60 美元,比 Sonnet 5 高出约 50%,几乎贴到 Opus 5.5 的 7.63 美元。
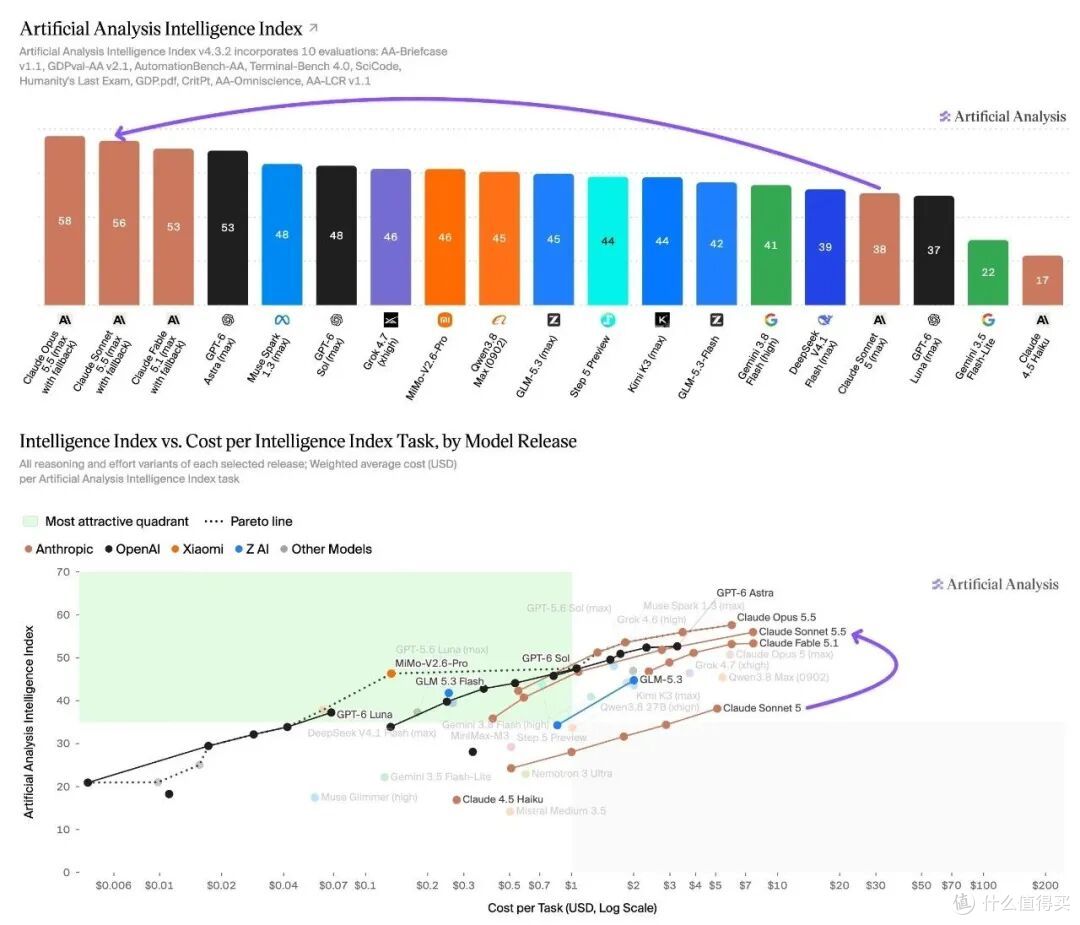 0智能
开发者的实测反馈也两极:有人惊喜,说两代差距肉眼可见;也有人直呼烧不起,“建议坚持使用 Opus 5.5”。
数字打架,其实是口径不同——官方算的是“完成同样的活要花多少 token”,第三方算的是“跑一次实际烧多少钱”。想省钱还是省心,得看你怎么用。
除了编程,它还管日常干活
抛开数字,官方给它的定位是日常工作的全能选手:修 bug、迭代功能、做文档、做幻灯片、做表格,对设计也有一套。安全层面有两点值得注意:它是 Sonnet 系列第一个配上网络安全防护和回退机制的,高风险任务会明确回退到上一代;也是第一个加安全分类器的,防止推理过程被提取。对普通用户影响不大,但对搞安全的团队,这是实打实的升级。
有个迁移小提醒:如果你之前在 Sonnet 上关过思考功能,迁移到 5.5 前要先切到新的 between_tools 配置,否则设置可能不生效。
另外,更便宜的小杯还在路上:面向高并发、成本敏感场景的 Haiku 5.5,官方说未来几周上线。
最后聊两句时机
就在 OpenAI 年度开发者大会开幕前一天,Anthropic 连夜把中杯端出来——价格贴着打、成绩对着比,狙击的意味挺明显。而上一周,OpenAI 刚发了 GPT-6 Sol 和 Luna 的增强版,Meta 也有新模型上阵。模型更新的速度,已经快到让人对“旗舰”两个字失去概念。
中杯追平大杯、大杯价格下探、小杯蓄势待发——AI 这场竞赛里,“性价比”正变成新的主战场。Sonnet 5.5 到底能不能替你省钱,我的建议是别只看官方那张表,拿自己真实的工作流跑一周再下结论。
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~