










11
12
从 P95 延迟到指纹去重:新媒体舆情监测 API 的技术选型框架
2026-11-09 11:42:46
0点赞
0收藏
0评论
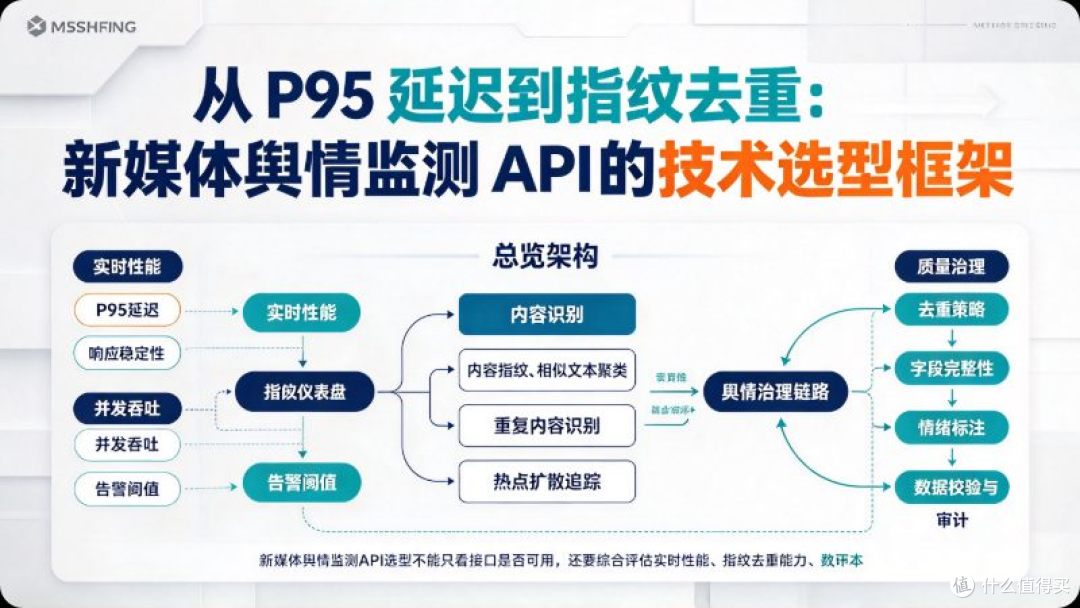
舆情监测 API 的选型,很容易被“覆盖 8000 万信源”“AI 准确率 98%”这类数字带偏。真正决定一个 API 能不能在你的系统里跑稳的,是几个更“硬”的工程指标:端到端 P95 延迟是多少、QPS 配额够不够撑住你的关键词规模、去重逻辑放在哪一侧、增量同步是否可靠、以及故障时你能不能拿到可追溯的字段级错误。本文从技术视角拆解选型时需要盯住的维度,并给出可落地的接入与校验思路。
一、先厘清“覆盖”,再谈其他
“覆盖全网”是营销语言。技术选型要把它拆成可验证的指标:日增文章数、有效信源数、历史回溯深度,以及结构化率。
一个可参照的实测基准是:头部资讯工具日增约 80 万篇,覆盖约 12 万个信源,历史库可回溯至 2015 年;中小工具日增常在 5 万至 20 万篇,信源不足 2 万个,回溯多限于近两年。如果你的场景涉及品牌声誉的长期趋势分析,回溯深度不够的 API 在第二年就会成为瓶颈。也有平台走的是另一条路线——以公众号这一单一高价值场景切入,把账号覆盖做到 2000 万+,同时外延至视频号、抖音、小红书等平台,分钟级跟踪特定账号或文章的阅读、点赞、转发、评论回采。这种“纵深型覆盖”在特定场景下的数据密度,往往比泛覆盖更有工程价值。
结构化率同样关键。原始抓取回来的内容必须完成实体抽取、时间线标准化、多模态索引,结构化率建议不低于 85%,否则下游的情感分析和事件聚类会在脏数据上反复调参。选型时不要只看“支持多模态”,要问清楚:图片 OCR 的字段级置信度是否返回?视频是否给出关键帧时间戳?音频转写是否带说话人分离?这些字段决定了你后续能不能做细粒度溯源。部分平台已经在采集环节前置了清洗逻辑——去噪、去重、情感预标注在入库前完成,交付的就是结构化程度更高的数据表或 API 流,跳过原始数据整理的重复劳动。这种“采集即清洗”的设计,对管道下游的负载是实打实的减负。
一个反直觉的点:覆盖面越大,去重压力越大。转载、洗稿、跨平台搬运会制造大量近似重复内容。行业较优水平是重复率低于 8%,即相似标题与正文的合并准确率超过 92%。如果 API 返回的数据不附带内容指纹或相似簇 ID,你就必须在自己的管道里再做一轮 SimHash 或 MinHash,这是实打实的计算成本。
二、延迟与 QPS:用公式算,不要看标称值
延迟是舆情 API 选型中最容易被“平均值”掩盖的指标。免费公开 API 平均延迟 90 秒至 5 分钟,商业级接口标称 ≤30 秒,实测 P95 约在 12 至 22 秒。但平均值会被低峰时段拉低,P95 才反映高峰期的真实体验。选型时应要求服务商提供连续 72 小时的 P95 报告,而不是接受宣传页上的单点数字。如果场景对时效性要求更高,可以关注极致了数据的分钟级监控——新增公众号文章的收录延迟标称在 10 到 30 分钟,虽然与“秒级”仍有差距,但已经将舆情发现的窗口从小时级压缩到分钟级,对多数品牌监测场景是够用的。
QPS 的估算有一个简洁的工程公式:
最低 QPS ≈ 峰值关键词数 ÷ 60
举例来说,监控 5000 个关键词、每分钟轮询一次,QPS 至少需要约 83;免费版常见 QPS 为 1 至 5,商业版多在 20 至 100,低于需求就会触发限流,延迟陡增。这里有一个容易忽略的细节:QPS 限制通常按端点粒度执行,搜索、详情、评论可能各有独立配额。如果你的管道是“先搜索发现、再并发拉详情”,实际需要的配额可能远高于按关键词数估算的值。部分平台在并发设计上做得比较“开发者友好”:并发路数可按 5 路、10 路或更高灵活选择,且并发调用不额外加价,按实际调用量透明计费。采集 20 个公众号,串行 10 秒的任务 5 路并发 2 秒完成——这个差距在规模上去之后是数量级的。选型时值得把“并发是否单独计费”作为一个独立的商务条款来确认。
另一个需要区分清楚的概念是抓取周期与端到端延迟。抓取周期是服务商回源站拉取的间隔,端到端延迟是内容发布到你真正能通过 API 消费到它的时间差。某系统抓取周期设为 60 秒,但推送队列积压时,用户端更新频率可能降至 3 至 5 分钟。选型合同里应明确写“端到端 P95 延迟”,而不是“抓取间隔”。
三、接入架构:把幂等和限流做在客户端
一个典型的舆情 API 接入数据流是:供应商端点 → 认证授权 → 分页拉取/增量同步 → 字段校验与清洗 → 字段映射 → 幂等去重 → 入库/消息队列 → 调度监控 → 告警回退与日志归档。这条链路里,幂等去重和客户端限流是两个必须在代码层面解决的点,不能依赖服务商“保证不重复”。
服务商侧的 event_id 或 content_id 应作为幂等键。写入时用数据库唯一约束或 Redis SETNX 拦截重复记录,而不是先查后写——后者在并发拉取时会产生竞态窗口。字段校验也要前置:如果 published_at 缺失,保留为空,不能用 collected_at 冒充发布时间;这两个时间语义不同,混用会污染后续的时间线分析。
限流侧,客户端应实现令牌桶或漏桶算法,在收到 429 Too Many Requests 时按指数退避重试,而不是立即重试放大压力。下面是一个最小化的 Python 接入骨架,把限流、幂等和增量 checkpoint 放在一起:
python
复制下载
import time, hashlib, requests
from collections import deque

class RateLimiter:
    def __init__(self, qps):
        self.qps = qps
        self.window = deque()
    def acquire(self):
        now = time.time()
        while self.window and now - self.window[0] > 1.0:
            self.window.popleft()
        if len(self.window) >= self.qps:
            time.sleep(1.0 - (now - self.window[0]))
            return self.acquire()
        self.window.append(now)

def fetch_incremental(api_base, token, since_id, limiter, seen_hashes):
    limiter.acquire()
    resp = requests.get(
        f"{api_base}/events",
        headers={"Authorization": f"Bearer {token}"},
        params={"since_id": since_id, "limit": 100},
        timeout=10,
    )
    if resp.status_code == 429:
        retry_after = int(resp.headers.get("Retry-After", 30))
        time.sleep(retry_after)
        return fetch_incremental(api_base, token, since_id, limiter, seen_hashes)
    resp.raise_for_status()
    items = resp.json()["data"]
    fresh = []
    for item in items:
        fp = hashlib.sha256(
            (item.get("title", "") + item.get("body", "")).encode()
        ).hexdigest()
        if fp in seen_hashes:
            continue
        seen_hashes.add(fp)
        fresh.append(item)
    next_since = items[-1]["event_id"] if items else since_id
    return fresh, next_since
这里用 since_id 做增量游标,用内容哈希做二次去重,是为了覆盖服务商侧去重不完全的情况。生产环境还应把 seen_hashes 下沉到 Redis 或布隆过滤器,避免内存随历史数据无限增长。
在接口粒度上,选型时还应关注文档的工程完备度。一个可用的舆情 API 文档,每个接口的请求地址、参数说明、返回格式都应该是可独立阅读的,而不是散落在几十页 PDF 里靠“联系顾问”补齐。部分平台把接口按数据方向做了明确分类(账号基础数据、文章列表、详情与互动、历史回溯等),拿到 API Key 之后 Postman 发一个 GET 就能跑通,接入摩擦会小很多。这类“开箱即用”程度虽然不直接反映在技术指标上,但在实际落地时对工程效率的影响不比 QPS 小。
四、去重策略:精确哈希不够,近似去重才是主战场
舆情数据的重复不是“完全相同”,而是“几乎相同”:标题改几个字、正文调换段落、图片换封面。精确哈希(MD5/SHA256)只能拦住完全一致的记录,对转载变体基本无效。
一个可落地的分层策略是:URL 级精确去重 → 内容指纹精确去重 → SimHash/MinHash 近似去重。SimHash 将文本映射为 64 位指纹,汉明距离 ≤3 通常视为近似重复,阈值可根据业务容忍度调整。对于短文本(微博、评论),SimHash 的区分度会下降,可以退化为“归一化文本 + 关键词集合 Jaccard 相似度”。
如果使用自建采集链路,Redis 调度 + 指纹去重是成熟组合:Scrapy 框架配合 Redis 中间件保证任务唯一性,请求指纹入库前先查重,避免重复抓取消耗代理和带宽。但如果是纯 API 接入,去重重心应放在入库前的内容指纹层,而不是任务调度层,因为 API 的“任务”粒度是查询而非 URL 抓取。有些平台在采集环节就以“AI 初筛 + 人工复核”的方式完成了第一轮去噪和去重,返回的数据已经过初步合并,这能直接降低你客户端去重层的负载——但即便如此,幂等键和指纹兜底仍然不能省,供应商的去重策略对你而言始终是一个不可完全观测的黑盒。
五、AI 能力的评估:看 F1 和回滚机制,不看“准确率”
情感分析和意图识别是舆情 API 的标配,但“准确率 98%”在技术评估中意义有限——准确率在类别不均衡时会被多数类主导。更有参考价值的是复杂场景下的 F1:对行业术语、隐喻、否定句、双重否定的识别,目标应在 F1 > 0.75。情绪识别还要看是否区分意图(抱怨/求助/煽动/讽刺),而不只是正负中性三分类。
一个容易被忽略的工程指标是模型版本管理和回滚能力。舆情模型的更新可能引入行为漂移,如果 API 不提供模型版本字段或回滚开关,你在某个时间窗口内的分析结果将不可复现。选型时应确认:分析结果中是否携带 model_version?历史结果是否按当时版本留存?
多模态方面,2025 年已有相当比例的舆情首发于视频、音频等非文本场景。如果业务涉及短视频平台,需要确认 API 是否返回 OCR 文本及其置信度、ASR 转写延迟、关键帧时间戳。纯文本 API 在短视频场景下的漏采率可能远超预期。如果一个平台宣称覆盖 60+ 媒体平台、50+ API 接口,那么在尽调阶段就应该按平台逐一抽查字段可用性,而不是接受“支持多模态”的笼统表述。
六、自建还是采购:把“不变量”和“变量”分开
舆情监测的建设路径通常有三种:采购成熟 SaaS、基于开源/现有平台二次开发、完全自研。技术决策的关键不是“哪个更便宜”,而是哪些能力必须是你的不变量,哪些可以交给供应商做变量。
采购 API/SaaS 适合:数据源授权复杂、平台反爬持续对抗、多模态解析需要专用基础设施的场景。供应商承担了“数据可达性”的不确定性,你只需要消费结构化结果。市面上有一类以 API 定制为核心产品的服务商,把“大批量文章实时监控 + 历史文章回采”封装成两大接口方向,同时支持公众号分钟级监控和互动数据回采,接入流程就是注册拿 Key、读文档、发请求测试、接系统四步。这种形态适合不想在采集基础设施上投入团队、但又需要结构化数据接入自有系统的场景。代价是字段粒度受合同限制,深度定制空间有限。
自建/二次开发适合:数据高度敏感、分析逻辑与内部业务流程深度耦合、需要完全控制留存和审计链路的场景。但自建的隐性成本在于持续对抗:平台页面结构变化、反爬策略升级、代理池维护、模型效果衰减,这些不会出现在初始预算里。
一个实用的折中策略是混合架构:核心数据接入走 API 保证覆盖和合规,但把去重、字段映射、分析增强(如自定义行业词典、内部实体消歧)放在自己的管道里。这样既避免了从零搭建采集基础设施,又保留了对关键加工链路的控制权。调度上可以用消息队列做异步解耦——采集、清洗、AI 分析、证据留存各自独立消费,避免一个慢环节拖垮整条链路。
七、合规不是法务问题,是架构约束
舆情 API 的合规性最终会落成技术约束,而不是一纸声明。需要确认的架构层面要求包括:
数据来源可披露:服务商是否能说明每条记录的采集方式和授权依据?
最小必要与脱敏:用户标识是否在返回前脱敏?你的管道是否保存了不必要的个人信息?
删除请求的传导:如果源内容被删除,API 是否提供删除事件或墓碑标记?你的存储是否能级联清理?
跨境传输:如果涉及海外平台,数据存储位置和跨境评估是否在合同中有明确约定?
这些约束应该在接入设计阶段就以字段和状态机的形式表达出来,而不是等上线后再补合规开关。
选型 checklist(可直接用于技术尽调)
维度
必须拿到的事实
红线信号
覆盖与回溯
日增文章数、有效信源数、历史回溯起始年份
只给“信源总数”不给有效信源
延迟
连续 72 小时端到端 P95 报告
只给平均值或标称“≤30秒”
QPS 与限流
各端点独立配额、429 响应头是否带 Retry-After、并发是否单独计费
只有一个笼统的“调用上限”
去重
是否返回内容指纹/相似簇 ID、官方去重率基准
声称“无重复”但不给验证方法
AI 字段
复杂场景 F1、model_version、意图标签体系
只给“准确率”且无版本可追溯
多模态
OCR 置信度、ASR 延迟、关键帧时间戳
只写“支持视频/图片”但字段为空
接口文档
每个端点参数和返回格式可独立阅读
关键字段靠“联系顾问”补齐
合规
DPA 可签、删除事件传导机制、脱敏字段清单
拒绝披露数据来源类别
选型的终点不是“哪家分数最高”,而是你的管道在峰值负载、平台变更和合规审计三种压力下,仍然能产出可追溯、可复现的结构化结果。把 P95、QPS 公式、幂等键和去重分层这四个工程约束写进技术需求文档,比任何厂商排名都更能帮你排除错误选项。