10月2日,英伟达官方博客披露了 GPT-6 Astra Ultrafast(超快模式)背后的"怎么快":运行在英伟达 Blackwell GPU 上,借助持续推理优化,输出生成速度最高达到标准模式的8倍,现已通过 OpenAI API 面向开发者开放,并向符合条件的 ChatGPT Work 与 Codex 用户开放。 而9月,中文互联网流传的还是另一个版本:Ultrafast 是 Cerebras 定制晶圆芯片的专属快车道——最高14倍、750兆瓦机房档期排到2028年,甚至有说法认定"前沿闭源旗舰+速度档,只有OpenAI配Cerebras才能提供"。英伟达这次披露,恰好把后半句翻了过来。微博
披露的时间点也值得玩味:10月2日,英伟达市值一夜涨超4000亿美元,最新市值5.56万亿美元、年内涨超24%。 兴奋归兴奋,三本账得先对完。哔哩哔哩
账一:14倍和8倍是两套算法,而且都只说"后半截"
先摆数字。14倍:OpenAI 8月为 GPT-5.6 Sol 预告的 Ultrafast 档位,搭载Cerebras晶圆芯片,官方口径是最高比标准模式快14倍、目前仅向部分客户开放,输出速度最高750 tokens/s。 8倍:10月2日英伟达博客的最新口径,主语是 GPT-6 Astra、芯片是 Blackwell,而且原文写的是"输出生成速度"——这条快车道压缩的是第一个字出现之后、每个字之间的间隔,不是首字等待时间。知乎
至于刷屏的"训练动用超十万张卡",出自知乎热榜问题下的社区回答:GPT-6训练基于10万张 Blackwell GPU、GPT-7正在基于40万张 Rubin。 注意这是训练侧的规模叙事,和 Ultrafast 这个推理档位是两回事——十万张卡解释的是"模型为什么更聪明",8倍解释的是"回答为什么吐字更快"。社区口径不是官方口径,这本账很多人第一页就串行了。知乎
那通用GPU凭什么追上定制晶圆?英伟达博客给出的细节是:OpenAI 推理负责人 Philippe Tillet 称,英伟达在工具链与文档上的投入,使其自家模型特别擅长为 Blackwell 与 Rubin GPU 编写代码,能把这类知识转化为高性能算子。 说得直白点:OpenAI 正在用自己的模型,给英伟达的芯片写加速算子。叠加低精度量化、提示缓存、投机解码这套公开玩法,"前沿闭源旗舰的速度档只有Cerebras能提供"的说法,今天起要打上一个大问号。微博
还有一脚刹车必须踩:8倍不等于体感8倍。业内公认推理要看三个指标——首token时间、token间隔、吞吐,有从业者的实测总结很直接:provider就算每秒吐两千个token,首token等4秒照样难用。 Ultrafast 官方没有公开首token时间数据,这一点只能等大规模实测。快是真的快,但它快在哪一段,取决于你的任务是"等开头"还是"等收尾"。知乎
账二:谁现在能用,谁在为"快"掏500美元
事实按时间排:9月27日,OpenAI 的 API 文档里就出现了 Standard/Fast/Ultrafast 三档速度选项。 9月29日至30日的 DevDay 上,OpenAI 调整订阅:Pro 200美元月费不变但用量减半,同时新增500美元档,约合人民币3600元一个月。 现在,英伟达确认 Astra Ultrafast 已向 API 开发者与"符合条件"的 Work/Codex 用户开放,官方点名的最大受益场景是反复迭代的智能体工作流:编程智能体写代码、调用工具、检查结果、再决定下一步。知乎知乎微博
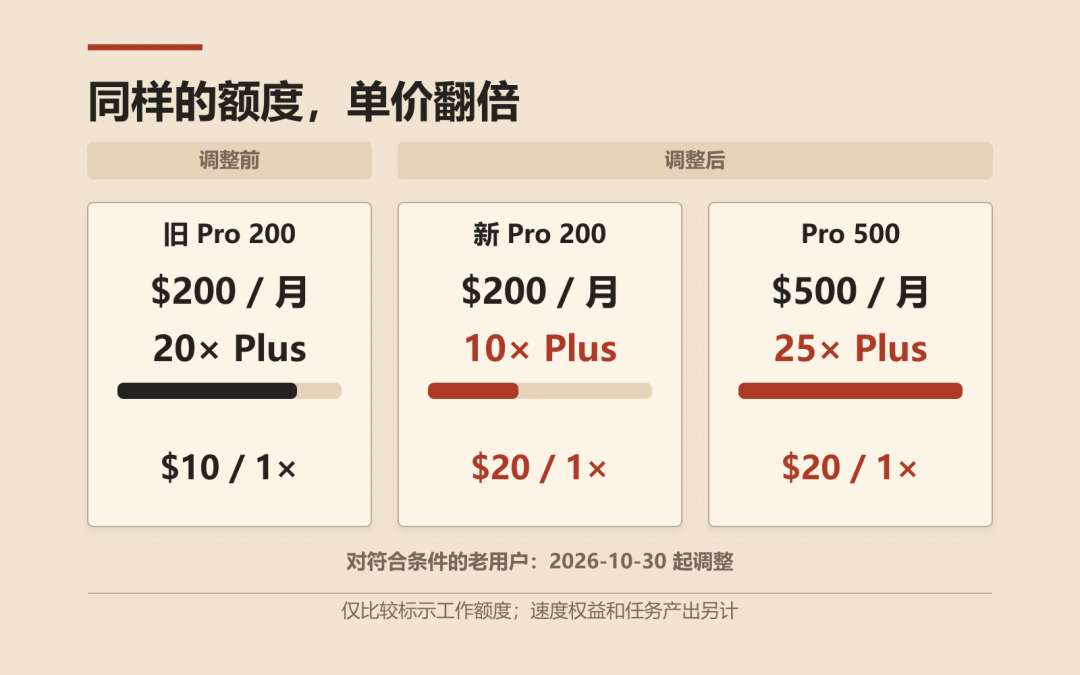
最容易被忽略的一本账:Ultrafast 不是免费加速。按 DevDay 后的口径,它能让 Codex 最高提速约8倍(约300 tokens/s),但消耗包含额度时按8倍计算、用 Credits 购买时按6倍计算。 换句话说,“快"正在被当成一种单独计价的商品:同一份答案,质量不变,你只是为每秒多出来的几百个 token 付费——而老 Pro 用户的额度调整将在10月30日正式切换,届时"20倍"变"10倍”。知乎
要不要为速度掏钱,账很简单:数一数你的任务链有多少个环节。企业级智能体跑一件后台事务,中间可能串起30到40次调用,标准档每步等3秒、整链两分钟,压到每步0.6秒就只剩二十几秒——“能用"和"卡"之间就差这一层。 反过来,单次问答、改文案、翻译整理,快8倍也只是省几秒等待——便宜档加提示缓存就够用。另一个别误读的点是"扩大开放”:750兆瓦级的推理产能必须提前几年下单、逐批交付,而英伟达自己说了,训练、推理、强化学习复用同一套基础设施、按需调配。 所以快车道大概率不会"所有人明天都能上",最早的两个观察信号:API文档里限流数字的变化,和"符合条件"名单的扩容节奏。知乎微博
账三:5090玩家和租卡党,这轮别把账记错地方
先掐掉一个念头:Astra 是闭源模型,这批8倍算子是给数据中心 Blackwell 写的,不存在"买张5090在家跑同款加速"的路——本地党能玩的还是开源模型加投机解码那一套。真正的关系在价格面:9月29日起 GPU 租金全线上调、最高涨21%,连老卡 H100 也涨了17%,Nebius 宣布10月起上调 H100/B300 租赁价。 老卡不降反涨,说明动的不是某一代卡,是整个算力的水位。知乎
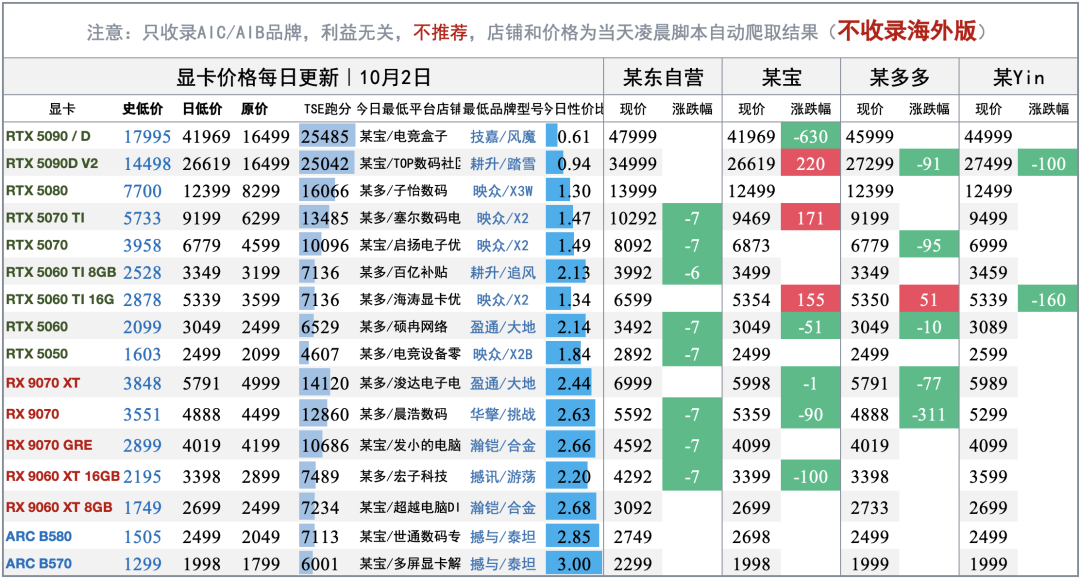
消费端同样在验证这个水位:10月2日的显卡行情表里,RTX 5090、5080、5070 各价位带仍贴史高,而比显卡更凶的是内存——10月1日显卡日报的标题直接写"内存已超过10倍暴利"。 速度档越普及,训练、推理、本地跑开源的各方就越抢同一池子产能,这是"等降价"玩家要盯的方向:先行指标不是显卡牌价,而是租金和内存报价。给三类人各一句:日常挂 Codex/Work 的,先查自己是不是已被划进"符合条件",智能体多环节任务的提升是体感级;API 开发者把 Ultrafast 档记进成本模型,报价给算力浮动留空间;手里攥着50系旧卡的,这轮利好是持有账,不是新算力——想靠一张消费卡复制旗舰的速度档,芯片路线和许可路线都做不到。知乎
最后交代反证:上表里的"10万张/40万张"是社区回答口径,"最高8倍"是封顶值而非你的单任务值,Pro 额度切换、62,500 credits 补偿细节以你收到的官方邮件与价格页为准。真要掏钱之前,先翻自己的调用明细——任务链几个环节、每月花多少、单价几倍计,这三个数才决定这条快车道值不值。