SpaceXAI(前身为 xAI)正式推出了旗下新一代大语言模型 Grok 4.7。在不到三个月的时间里,从 Grok 4.5、4.6 到如今的 4.7,xAI 保持着极快的发展节奏。本次发布的 Grok 4.7 将核心目标明确锁定在“编程”与“长流程知识工作”上,主打更强复杂任务处理能力、保持前代基础售价以及更高的执行效率,试图通过高性价比和实用工具落地来占领专业生产力市场。
从技术与参数亮点来看,Grok 4.7 换装了规模更大的底层基座,模型参数量提升至约 2.1 万亿,相比前代的 1.5 万亿增长了约 40%。除了参数规模的扩充,SpaceXAI 还将大量的真实航天工程、星链遥测及相关技术文档等独家数据注入预训练过程,使其在工程领域的语料基础上具备天然优势。此外,该模型在 Cursor 等平台上的上下文处理能力提升到了最高 500K,能够更好地维持大型项目和多轮对话中的上下文信息稳定性。
在训练策略和任务处理能力上,Grok 4.7 延长了强化学习阶段,并将训练任务的难度大幅倾斜向需要持续数小时才能完成的复杂工作。这一改变带来了两个核心能力的提升:一是长流程任务的自我管理与持续执行力,降低了模型在面对多步骤长链条任务时中途放弃或逻辑中断的概率;二是增强了自检能力,模型在输出结果、编写代码或整理复杂文档时,能够更主动地对内容进行复核,从而降低幻觉和错误率。官方公布的数据显示,在考察长时间编程能力的 CursorBench 4.0 测试中,Grok 4.7 取得 46.3% 的成绩;在软件工程测试 DeepSWE v1.1 中达到 71%;在电气工程 EEBench 测试中得分 64%;在法律、医疗及办公综合任务等专业领域的基准测试中,也普遍较前代有所增长。
另一个显著的变化是 Grok 4.7 原生对齐了自家 Grok Bot 及 Grok Build 运行框架。这种“模型+私有脚手架”的设计,让模型能够更自然地调用终端、浏览器、文件系统并保持持久状态。然而,这也带来了实际表现的分化:当配合官方提供的特定框架使用时,Grok 4.7 在编程智能体榜单上成绩表现亮眼;但在脱离该框架的统一标准基准(如 Terminal-Bench 4.0)或某些第三方评测中,其通过率则出现明显下滑。这表明新模型的能力大幅依赖于特定交互逻辑与配套工具体系。
在价格与调用速率方面,Grok 4.7 沿用了上一代的价格策略,标准版 API 输入每百万 Token 价格为 2 美元,输出为 6 美元,同时提供了速度与价格均翻倍的快速版本(Fast Mode)。官方强调其综合单价远低于市场上部分前沿旗舰模型。不过从开发者实测和综合评测反馈来看,实际使用成本却并非单纯由 Token 单价决定。由于 Grok 4.7 在推理和回答时表现出更为冗长的特点,完成单个任务平均消耗的输出 Token 数量往往远多于前代及部分竞品,这在一定程度上稀释了其单价便宜带来的成本优势。
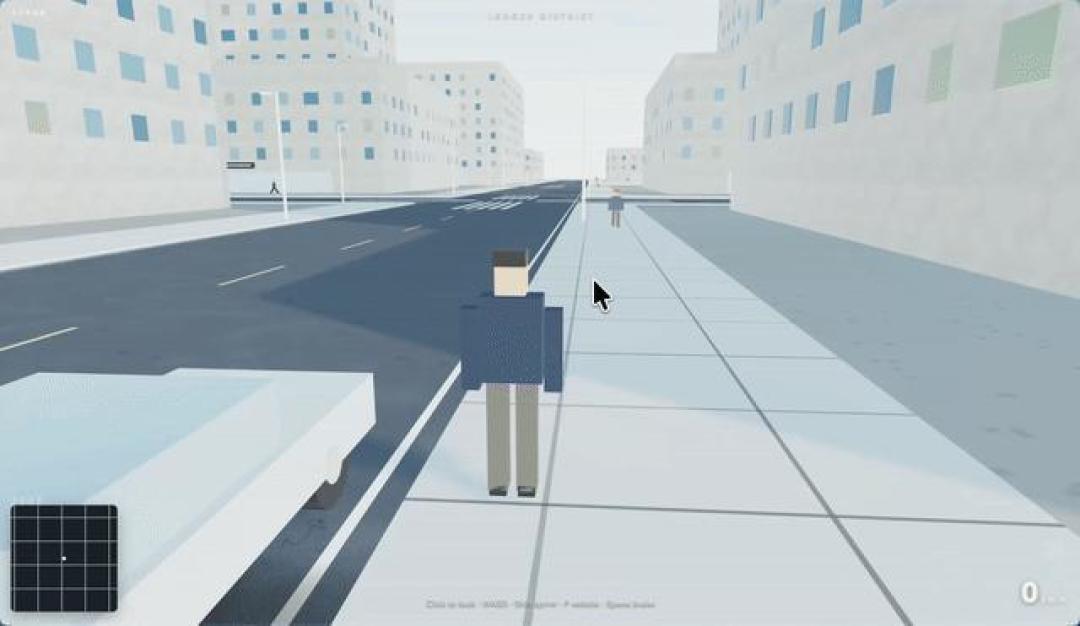
从实际体验与市场评价来看,Grok 4.7 展现出了“偏科”与“适用场景明确”的特点。在长时间连续运行的代码调试、数据梳理、复杂项目分析以及结合 Blender 等工具生成 3D 脚本的任务中,它展现出了更强的前后一致性与耐心。但在前端UI渲染、SVG矢量图绘制(如经典的“鹈鹕骑自行车”测试)以及某些不依赖框架的短任务表现上,其交出的答卷依然存在生成不精准、出现低级 bug 等翻车情况。此外,在同一时间窗口发布的开源模型如小米 MiMo-V2.6 等,也在综合跑分和极低综合成本上对其形成了强有力的竞争压力。
综合而言,Grok 4.7 并不是一款追求全方位绝对碾压的通用 AGI 模型,而是马斯克阵营将其推向“ Agent 智能体工具”的重要尝试。它通过增大模型基座、注入工程数据、强化自检能力与绑定私有开发框架,卡住了高性价比、高速度的长任务编程与办公场景。尽管其存在生成内容过于冗长、高度依赖配套生态等争议,但对于需要在具体框架下进行长链路工程开发与数据处理的团队来说,Grok 4.7 依然提供了一个高效且具有成本竞争力的选择。