















 深耕数码兴趣领域



10
8
Kimi K3.1 Pro 发布:3 万亿参数,编程跑分追到头部闭源模型跟前
2026-10-25 16:19:31
0点赞
0收藏
0评论
 Kimi K3.1 Pro 发布主图
10 月 24 日凌晨,月之暗面正式上线了 Kimi K3.1 系列的第一个模型 Kimi K3.1 Pro,同一天推出高速版 Kimi K3.1 Pro Highspeed。官方给它的定位是公司迄今能力最强的 3 万亿级参数模型,支持 100 万 Token 上下文。完整模型权重会在 11 月 4 日之前发布。
这条消息对普通用户的意义不在参数有多大,而在两件事:一是它现在就能在 kimi.com、Kimi App 上直接用到;二是这轮更新把 3D 建模和表格处理这类"能产出文件"的活儿往前推了一截。
这次放出来了什么
K3.1 Pro 是基于 K3 做后训练得到的版本,官方称大幅增加了后训练算力。总参数 2.8 万亿,走 MoE 架构,每次推理激活约 1040 亿参数。100 万 Token 的上下文,意味着你可以一次丢进去几本中等厚度的书,或者一整个项目的代码库,让它通读之后再回答。
高速版和标准版是同等智能,区别只在输出速度,约为 2~3 倍,价格也是标准版的两倍。偶尔问几个问题,标准版够用;要跑长任务、频繁调用的,高速版省时间。
即日起,kimi.com、Kimi App、Kimi Work、Kimi Code 和 Kimi API 都能选到这两个模型。想本地部署的可以留意 11 月 4 日前的权重发布。
编程跑分到了什么位置
官方给出的几个数字里,最值得看的是 Terminal-Bench 4.0。这项基准通过真实环境中资源受限的终端任务考察编程智能体,每项任务都有严格的专项测试。K3.1 Pro 得分 65.7%,超过 GPT-6 Astra 的 58.2%,距 Claude Opus 5.5 的 66.4% 只差 0.7 个百分点。
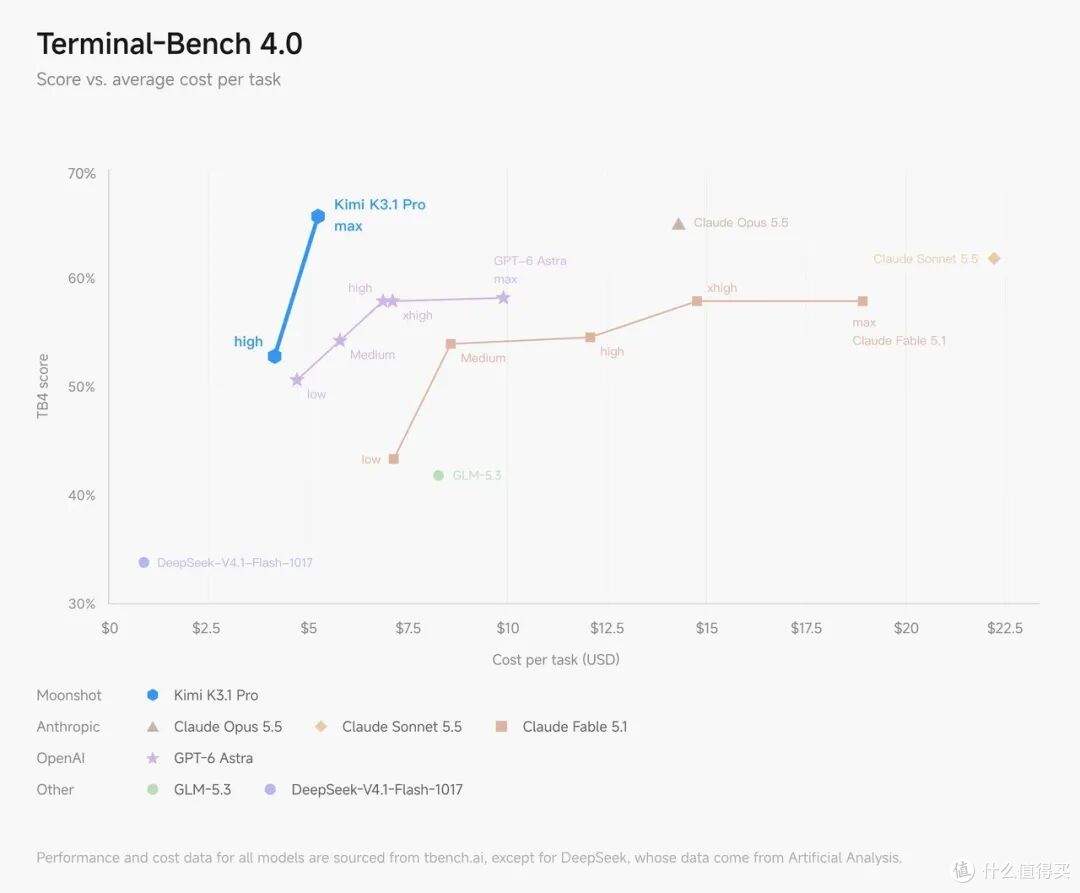 Terminal-Bench 4.0 得分与单任务成本对比
这里要说清一点:Terminal-Bench 是公开基准,Kimi Code Bench 3.0 Long-horizon 是月之暗面自己的内部基准,两者口径不同,不能互相换算,也不能拿内部基准的分数去跟外部模型的公开分数比高低。K3.1 Pro 在内部基准上拿到 61.2%,K3 是 55.95%。
官方对 K3.1 Pro 的表述是"在代码、Agent 和知识类基准上达到或接近最强闭源模型的水平"。这个说法出自官方介绍,实际体验如何还得自己试。
3D 建模和 3D Make
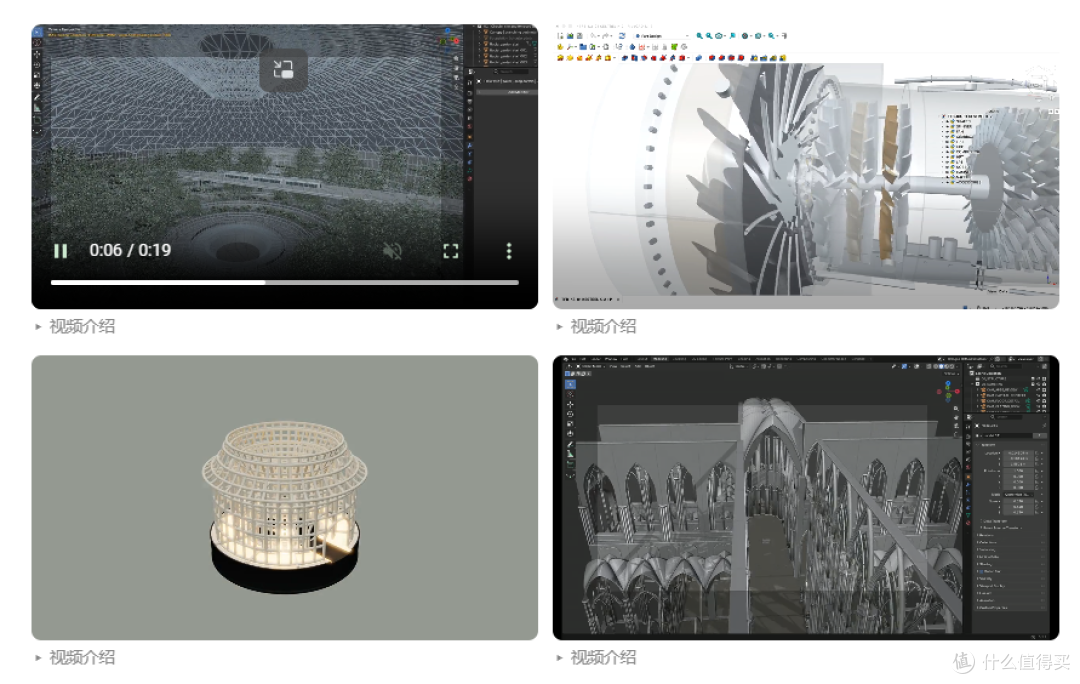
K3.1 Pro 能比较熟练地使用 Unity、Unreal Engine、Godot 这几款游戏引擎,也能结合网络搜索和 3D 生成做出完整的交互体验。给一段文字描述、一张草图或者一张参考图,它可以推断物体的形状、比例和空间关系,重建出可用的 3D 模型。
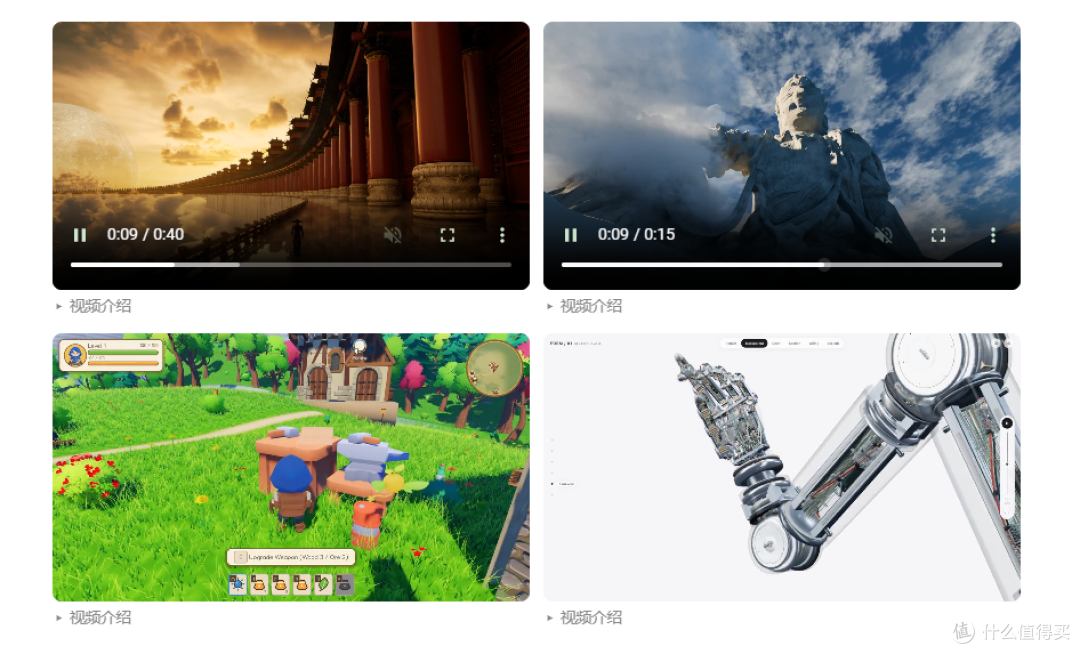 图片
更能说明问题的是它可以直接编写并运行 Blender、CAD 这类专业建模工具的脚本,不需要额外接 MCP 连接器。这意味着参数化建模的活儿——机械零件、建筑模型、多参数可配置的产品、定制家具——可以让它先搭骨架,你再改细节。
 图片
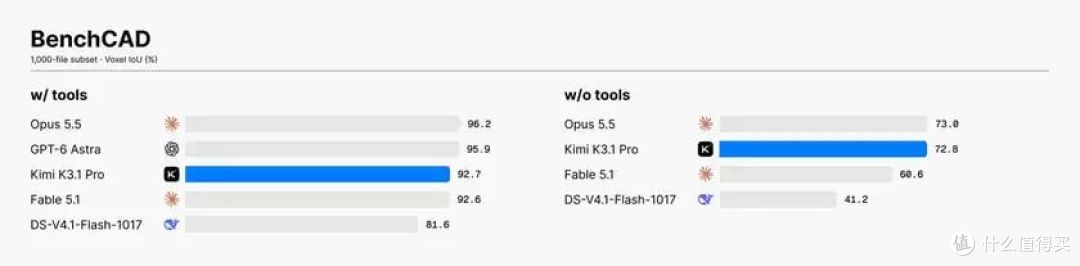
在 BenchCAD 基准上,K3.1 Pro 借助工具得分 92.7%,对比 Claude Opus 5.5 的 96.2% 和 GPT-6 Astra 的 95.9%,还有距离,但已经进了同一梯队。
 图片
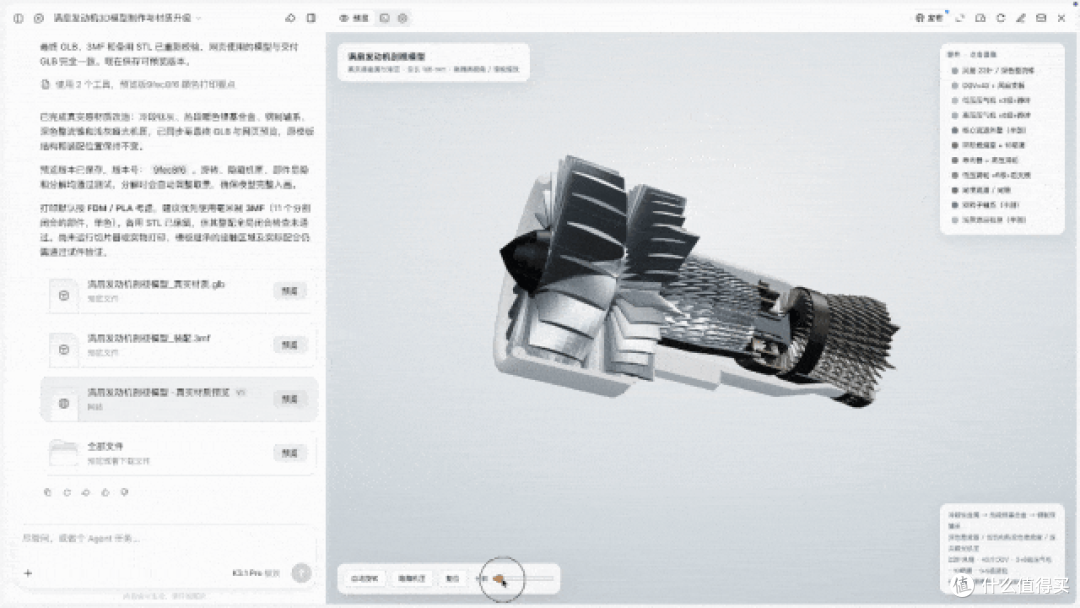
配套的 3D Make 功能已经上线 kimi.com 和 Kimi App,支持在线预览和编辑 3D 模型,做好的模型能直接下载去 3D 打印,也能导出视频或实况照片分享到社交平台。
 图片
表格与金融工作流
OfficeQA Pro v2 考察的是基于真实金融文档的复杂财务数据分析,涉及检索、跨文档核对和多步数值推理。K3.1 Pro 在这项上得分 64.4,是当前最优成绩。
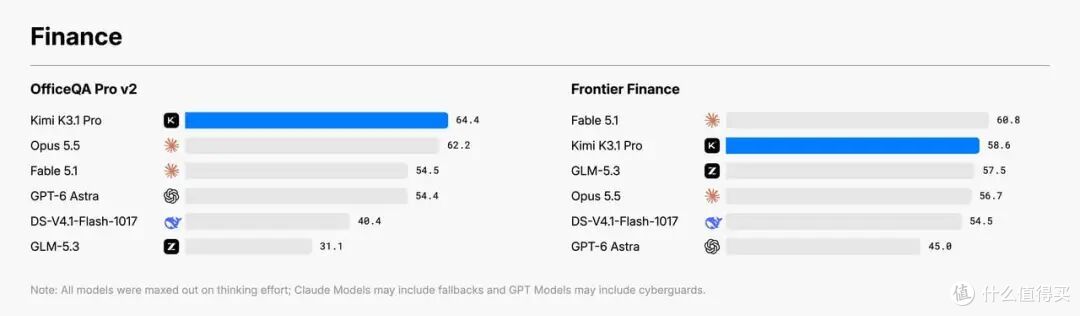 Kimi K3.1 Pro 金融基准测试成绩
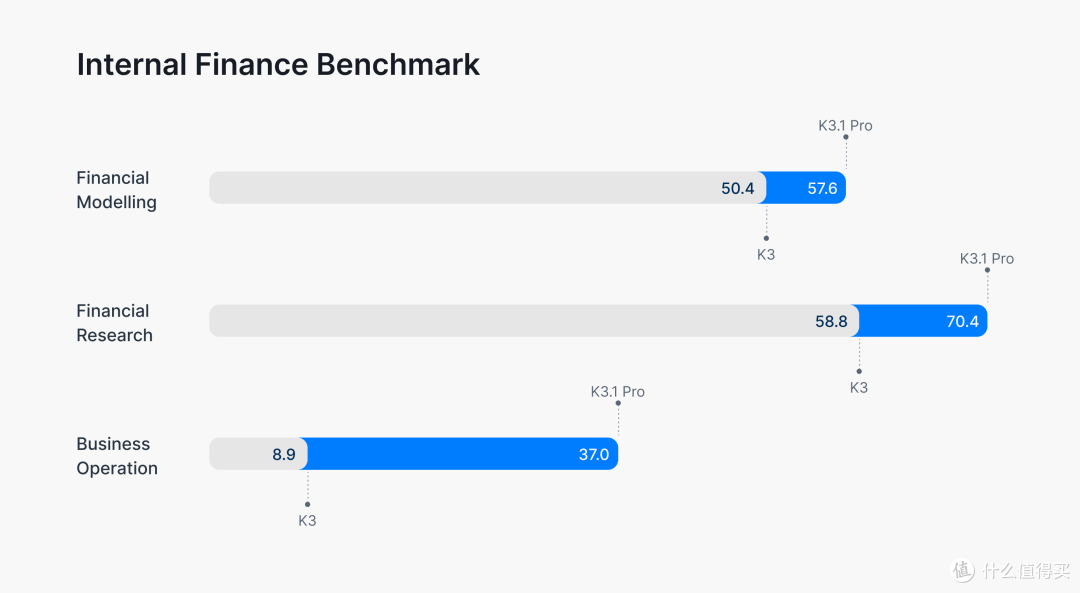
在三个内部金融基准上,它比 K3 全面进步:财务建模基准 Financial Modelling 提高 14%,金融研究基准 Financial Research 提升 20%,商业运营基准 Business Operation 得分约为 K3 的 4.2 倍。这几个数字来自月之暗面内部测试。
对做财务、做表的人来说,这个方向的实用价值在于可以把一堆格式不统一的报表丢给它,让它做跨文档核对和多步计算。不过真实工作里的表格往往又脏又乱,基准成绩和实际交付之间还有落差,建议先用小样本试一次。
事实准确率
K3.1 Pro 在内部压力测试 Kimi Hallu Bench Hard 上,单项事实陈述错误率从 K3 的 23.4% 降到 8.3%;包含至少一处事实错误的回答比例约为前代的 42.4%。
 图片
需要说明,这项测试的样本刻意聚焦模型容易出错的情形,报告的错误率不代表日常使用中的整体水平。但错误率下降这个趋势本身是明确的。
价格和接入
接入 Kimi API 的开发者在 platform.kimi.com 上选 kimi-k3.1-pro 即可。价格为每百万 Token 输入 1.3 元(命中缓存)、13 元(未命中缓存),输出 68 元。高速版 kimi-k3.1-pro-highspeed 速度约为 2~3 倍,价格是标准版的两倍。
现在要不要上手
如果只是日常问答、写点东西,kimi.com 和 App 里直接切换模型就能体验,没有成本。如果正在做 3D 相关的项目,或者手上有一批格式混乱的表格和文档要处理,这轮更新值得花半小时试一次,重点看它在你的具体任务上能不能一次交付可用的结果。要本地部署的,等 11 月 4 日权重发布。
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~