











 深耕数码、AI兴趣领域





11
10
被AI神化的统一内存,真的就是跑AI最优解?带你读懂统一内存
2026-09-18 11:47:57
0点赞
0收藏
0评论
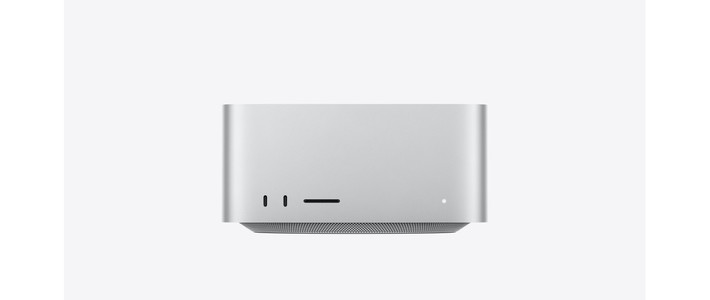
新版Mac mini即将开卖啦,全新的M6芯片搭配2nm工艺,更大容量的统一内存,更强大的带宽,本地跑AI又可以更快了。等等,先打住。每次提到苹果Mac mini都是绕不开那四个——统一内存。这个统一内存究竟是有什么神力,可以让如此多的AI玩家为之倾倒?
一、AI时代最扎心的真相:显存是昂贵的最优解
早在今年年初时,当"养龙虾"(OpenClaw)热度最高时候,不少小伙伴在安装后会发现,这个龙虾养得还真不容易——给它配个云端API相当于订阅了一个长期会员,而且“养龙虾”就不得不让它接管你的电脑,可是这云端API搭配本地主机又存在泄密可能;选择在本地跑吧,你的64GB内存主机跑不动,你朋友那台16GB的Mac mini反而跑起来了。内存明明只有你的四分之一,凭什么别人家的就可以,而你的就不行呢?
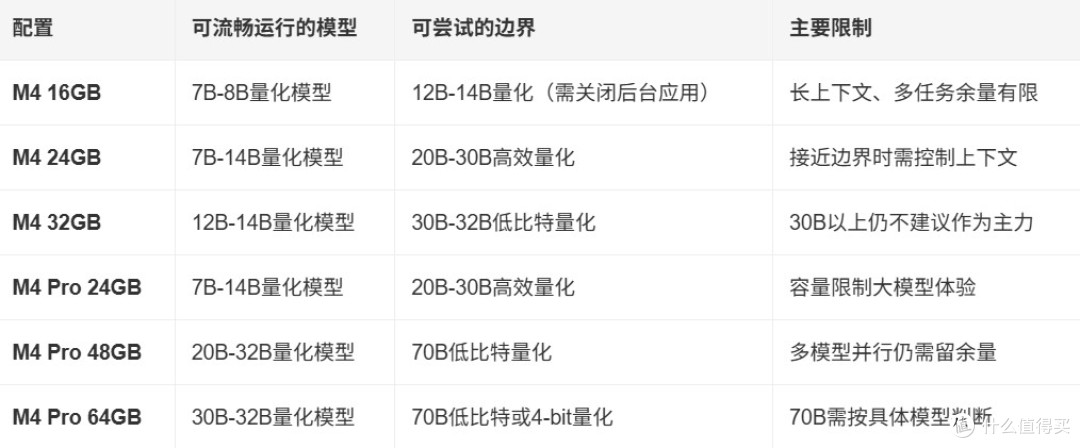
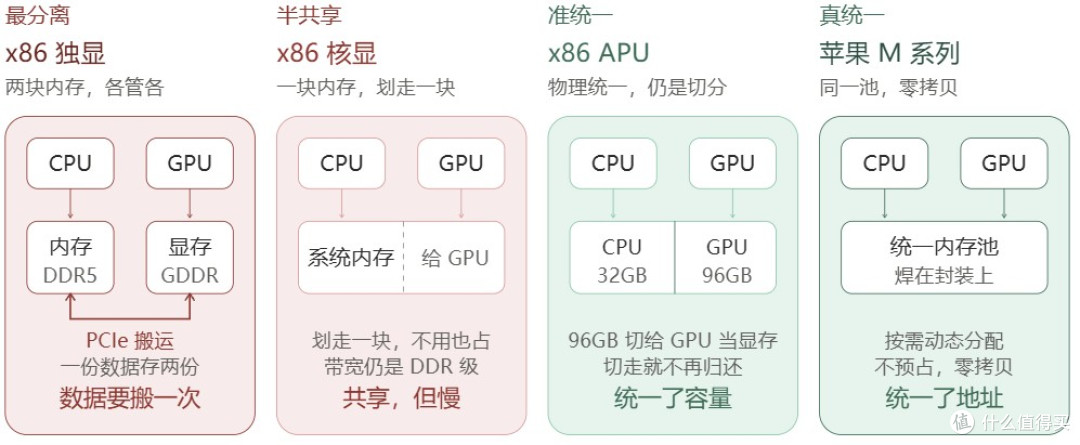
聪明的小伙伴或许已经知道,如今决定你能不能跑AI的,不是内存有多大,而是"显存"在哪。准确来说,是给AI用的内存在哪里。传统电脑里,CPU和GPU是"分家"的:CPU用的是主板上的内存条,GPU用的是显卡上自带的显存。两边各过各的,数据要交换,得走一条叫PCIe的"高速公路"来回搬运。

这个设计在游戏时代没问题——游戏贴图加载进显存就完事了。但到了AI时代就不一样了,因为大语言模型的全部参数,必须完整地装进显存才能运行。有多大呢?
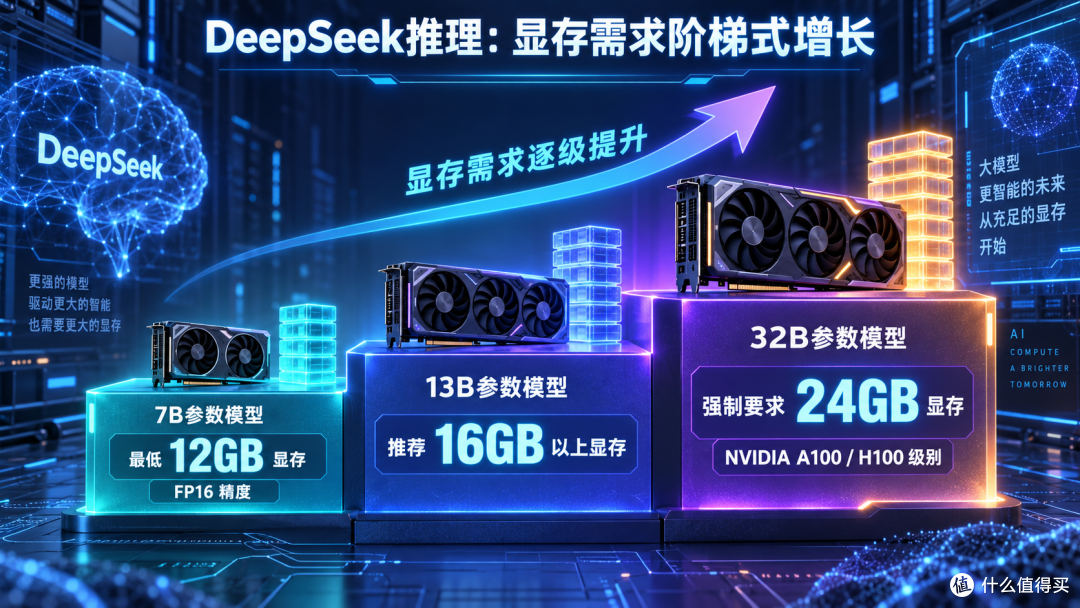
根据之前DeepSeek提供的配置需求,一个7B参数模型,如果跑未量化的7B原始模型,最低需要12GB显存,如果是13B参数,直接飙升至16GB。目前市面上多数显卡都是8GB,大容量版本或许可以有16GB,但价格已经贵上天了。如果想跑32B,没有24GB显存基本跑不动。
二、苹果的解题思路:把内存变成所有人的
2020年,苹果发布M1芯片时提出"统一内存架构"(Unified Memory Architecture),当时没多少人意识到这玩意儿意味着什么,只觉得这只是苹果的宣传罢了。随着这几年AI兴起,大家才知道,原来统一内存才是最优解。统一内存的原理简单概况就是:CPU、GPU、神经网络引擎(NPU)共享同一块内存,谁需要谁用,不用来回搬家。为什么统一内存更好用呢?主要分三个方面:
第一就是物理上“住得近”。苹果的内存颗粒直接和SoC封装在同一块基板上,距离以毫米甚至是微米计算。而传统PC的内存条插在主板上,显卡更是隔着PCIe插槽遥遥相望。这点距离少则十几毫米,多则几十毫米也不为过。物理距离直接决定延迟,别小看这点距离不太起眼,放在以毫秒计算的电子产品里,这点距离还是会有不小的延时。
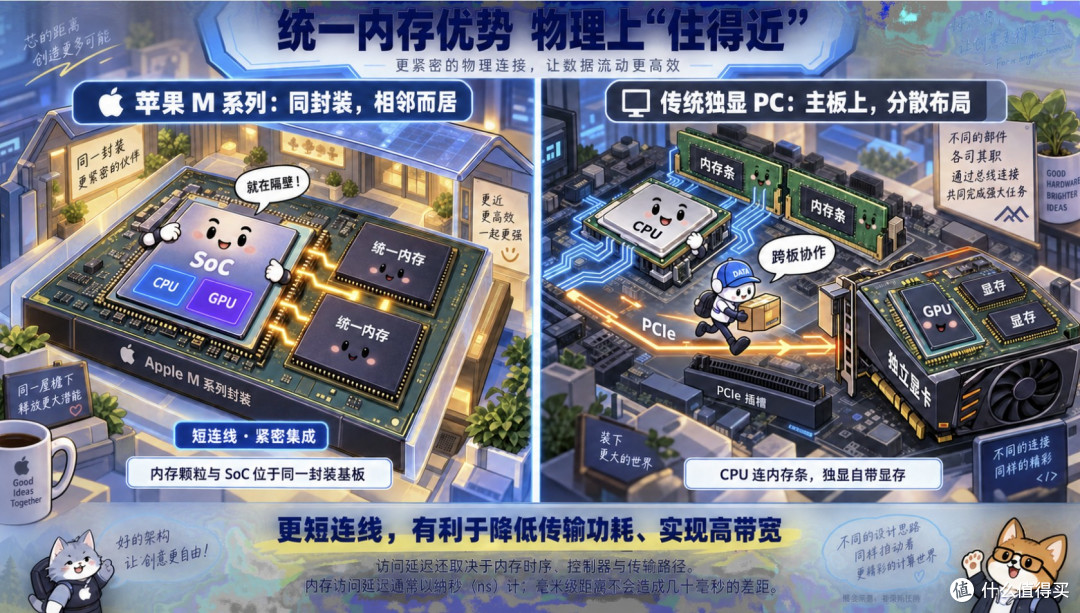
第二则是底层架构的零跑腿,这也是苹果最犀利的独门秘籍。打个比方:CPU和GPU是两个厨师。传统架构里他们各有一张备餐台,中间隔着一条叫PCIe的窄走道。做一道菜,得先把食材一趟趟从这张桌子搬到那张桌子——模型有多大,就得搬多少次。 苹果做的事,是把当中那条走道直接拆了。食材没少,但不用再搬了。
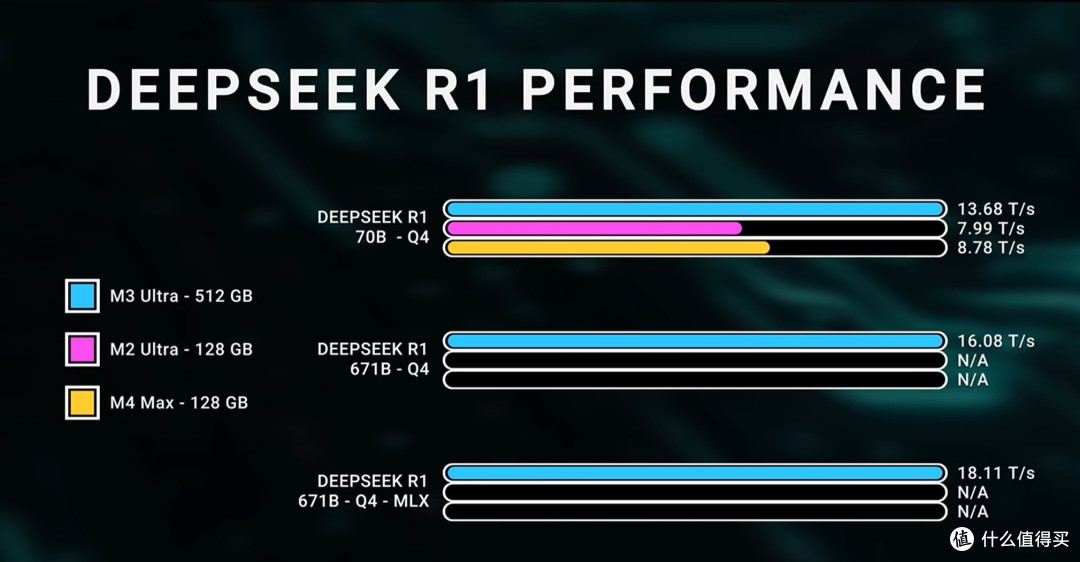
最后一点就是给AI用的存储空间更自由。一台普通的16GB Mac,可以动态拿出10GB左右给AI用,而顶配Mac Studio搭配512GB统一内存,能完整运行671B参数的满血DeepSeek R1(满血版要求至少400GB)。光看这一点,任何消费级显卡几乎不能满足需求。科技博主Dave2D也实测过:M3 Ultra跑满血R1,出字速度约17-18tok/s,而整机功耗不到200W。而PC这边,基本就是直接罢工,连装都装不下。
三、x86的"统一内存":祖师爷级别的存在
今年所有人都在"养龙虾"却发现自己电脑跑不动后才知晓,本地AI的最优解原来是苹果硬件。一时间,原本还可以低价入手的Mac mini(M4版)瞬间变成了香饽饽,价格从3K+一下子飙升到6999元(M6版),几乎翻了一倍。看到苹果这边吃得满嘴流油,x86阵营坐不住了,“统一内存”也随之出现在各大x86商品详情页以及各路媒体的宣传文中。但事实上,x86的“统一内存”比苹果的还要早不少。这就要追溯到共享显存的年代了。
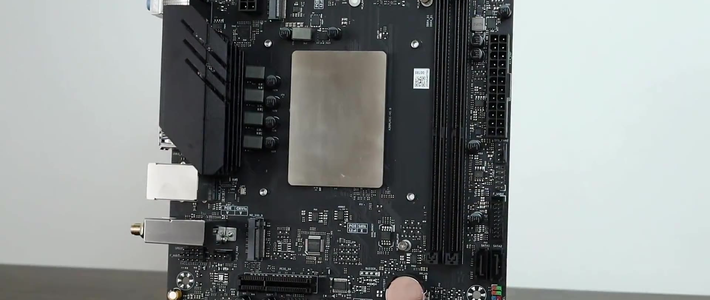
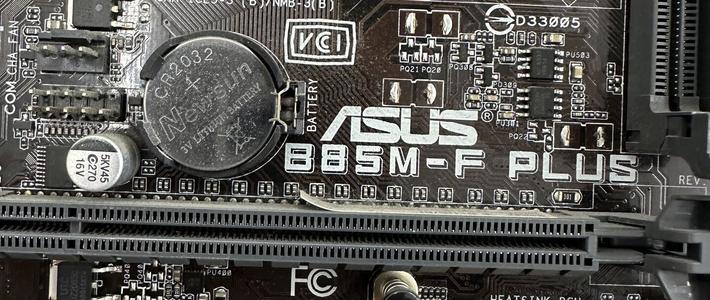
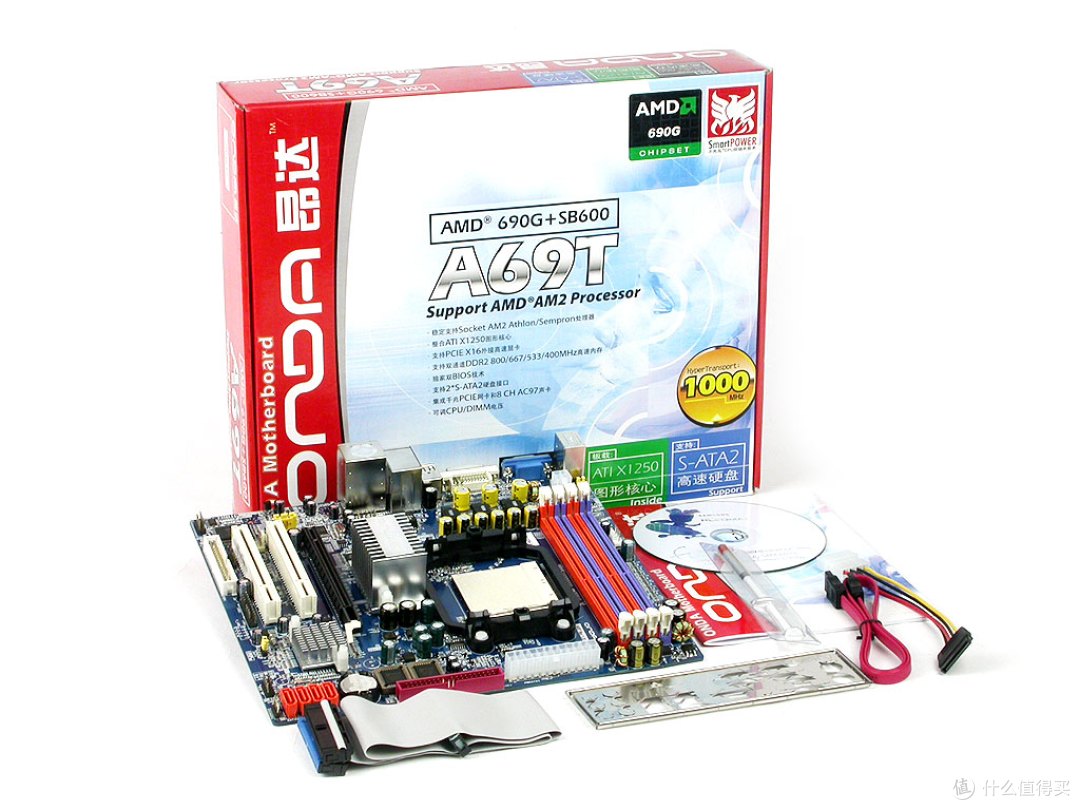
有请20年前的元老级主板,也算是共享显存的鼻祖级别——AMD 690G主板。这个主板没有板载显存,故此采用了传统内存共享机制,也就是共享显存,通过在BIOS里固定划一块内存给核显,比如512MB或2GB,剩下的归CPU。虽然名为共享,但实际上将内存分家,板载显卡用一部分,另一部分留给CPU。
之后的剧情发展,大家也不陌生了——大模型本地化后,大家才发现以前的电脑根本装不下满血版的,只能退而求其次选择一些轻量版的。而使用了苹果生态的小伙伴则发现,原来苹果在AI时代更香。x86这边自然不会闲着,在2025年,AMD推出了Strix Halo(锐龙AI Max+ 395)。

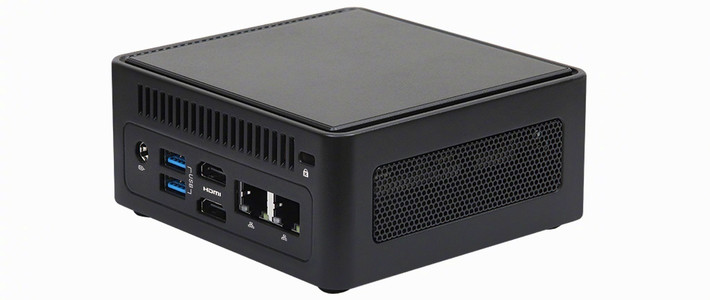
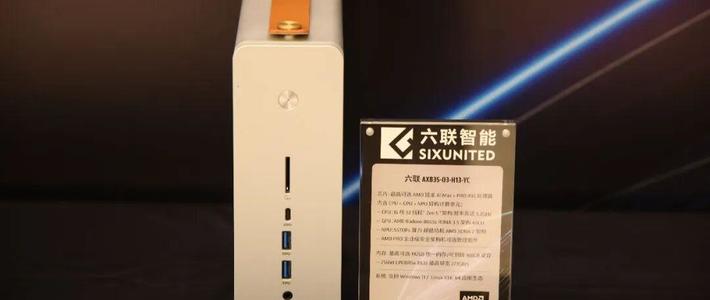
这颗芯片重点并不是功能很强大,而是支持板载内存的分配,能将128GB板载LPDDR5X内存,可以动态分配最高96GB给GPU当显存,迷你主机厂商直接打出"本地跑235B大模型"的口号。
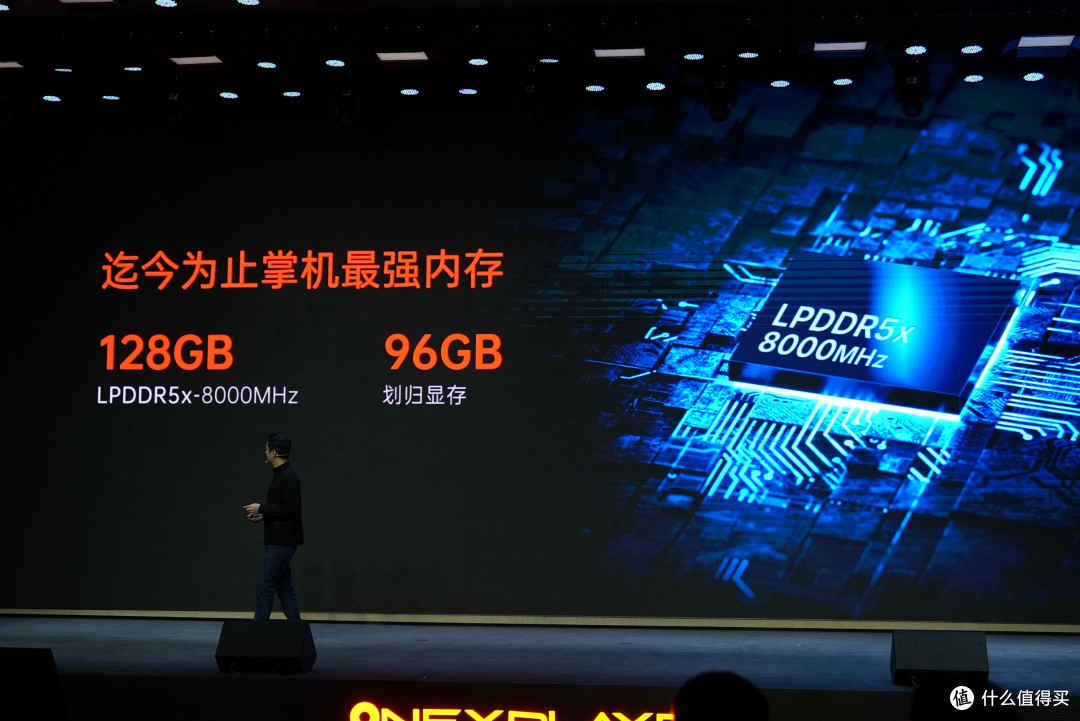
虽说AMD终于有了统一内存,但差别依然存在:苹果的统一内存是全自动、动态、无需设置的,系统自己按需调度;而x86阵营多数方案还要在BIOS或驱动里手动分配显存大小,软件生态的适配也参差不齐。硬件层面两者相差无几,但软件方面还没完全学会苹果的真谛。
四、光说理论还不够,看看实测表现如何吧
说了这么多关于苹果统一内存有多好,事实又真的如此吗,苹果跑本地大模型真的比普通PC主机要好吗?还是直接看看实测吧。
先看小模型,科技媒体Site Point用同一批模型(基于DeepSeek)实测RTX4090和M3 Max。其中RTX 4090 采用的操作系统是Ubuntu 22.04 LTS , Python 3.10+, 显卡驱动升级到550以上版本,而M3 Max则是macOS Sonoma 14.x搭配Python 3.10+。
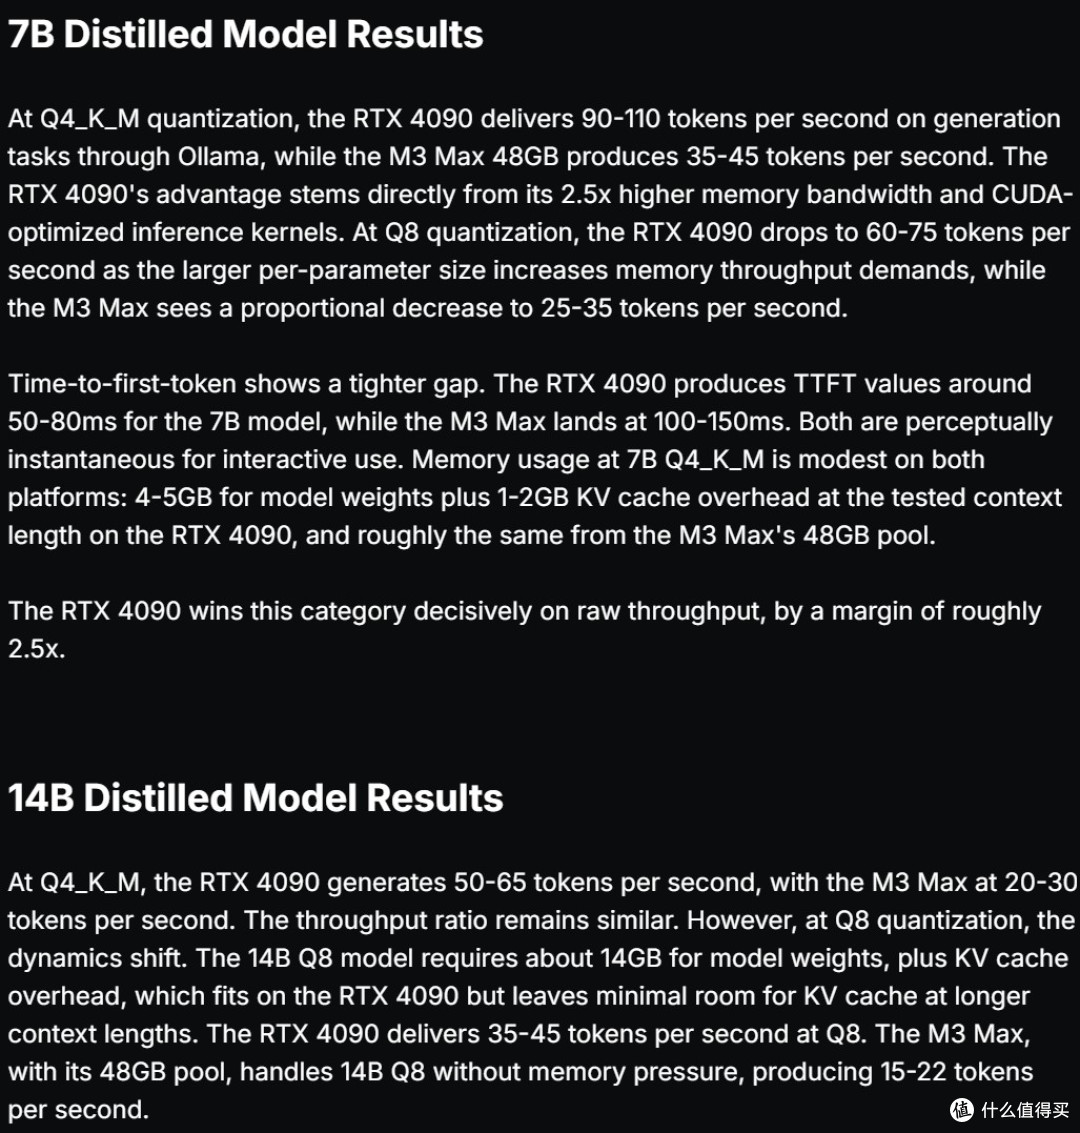
由于原文是纯文字,我这里将其汇总了一下,请看图——

7B模型上,4090能跑出90-110tok/s,M3 Max只有35-45tok/s。原因很直白——4090的GDDR6X显存带宽高达1008 GB/s,而M3 Max的内存带宽约400 GB/s。在大模型推理里,token速度几乎随显存带宽线性增长,简直就是突破次元壁的节奏。
14B模型,两者的表现已经出现明显的差距——RTX 4090下降幅度比M3 Max更大,差不多有50%。而在70B模型上,RTX 4090因显存不够被迫卸载CPU,吞吐崩到 3-8 tok/s。这样的输出速度堪比PPT,使用体验下降不仅是一丢丢。反观M3 Max靠统一内存完整装入,输出也不比RTX 4090好很多,也仅有8-14 tok/s,不快但能用。
从测试不难看出,统一内存最大的价值在于跑得不一定比你快,但我能装。而能效方面可以说是苹果完胜。同样100 tok/s的产出,RTX 4090平台功耗300W以上,Mac只要100W多一点(按50W输出45 tok/s算),能效比高出3-4倍。开一整天的本地AI服务电费也不会觉得心痛。
可能有小伙伴会问,现在显卡这么贵,显卡买不起,那如果我入手一个装备了统一内存的锐龙AI Max+ 395主机,跟苹果Mac mini或者是Mac Studio相比,差距大吗?好问题。So我找了相关的评测——
以下是来自Tom’s Hardware 今年做的一个对比评测。参测的主机依次是苹果的M4 Max Mac Studio,搭配128GB,NVIDIA GB10,同样搭配128GB,还有就是AMD Ryzen AI Max+ 395。苹果的M4 Max Mac Studio和NVIDIA GB10对于普通人来说还是有点超纲了,但这三款主机还是颇有代表性的——苹果M4 Max Mac Studio代表了纯血的统一内存,而NVIDIA GB10和AMD Ryzen AI Max+ 395则是代表了x86新一代的统一内存。
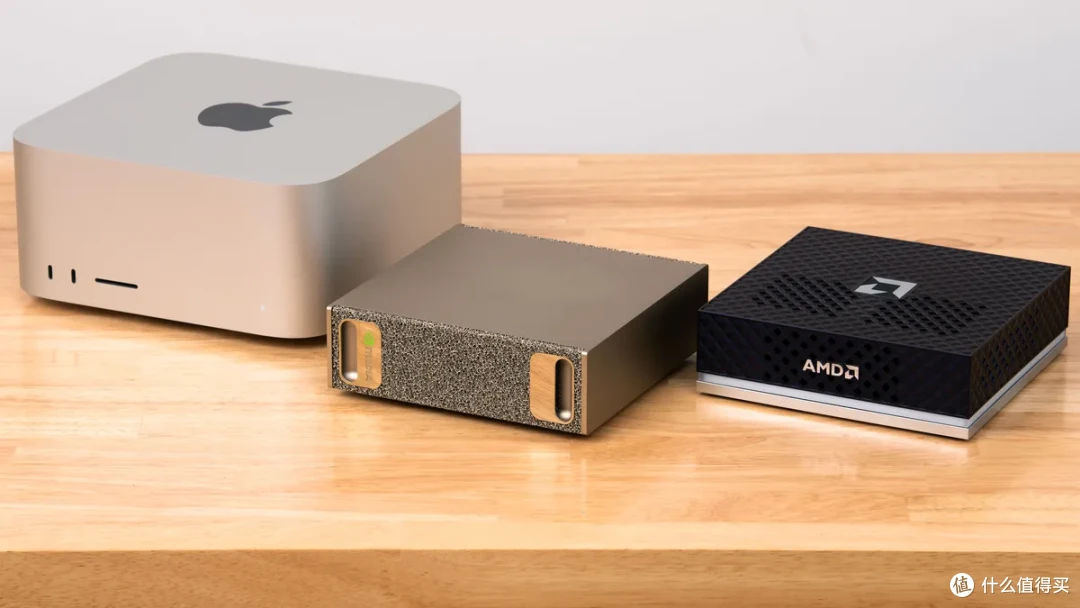
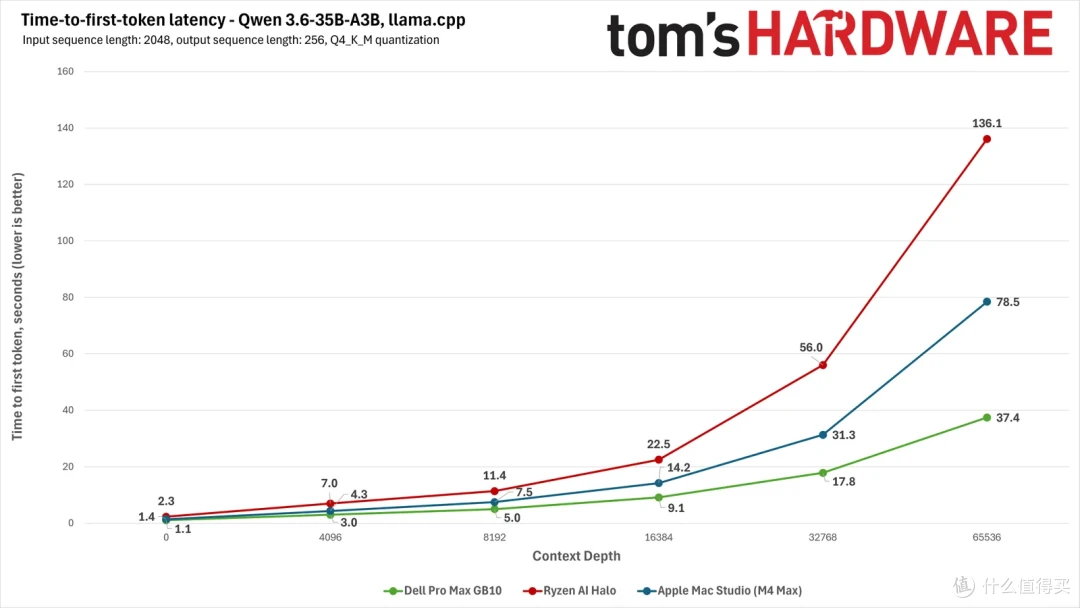
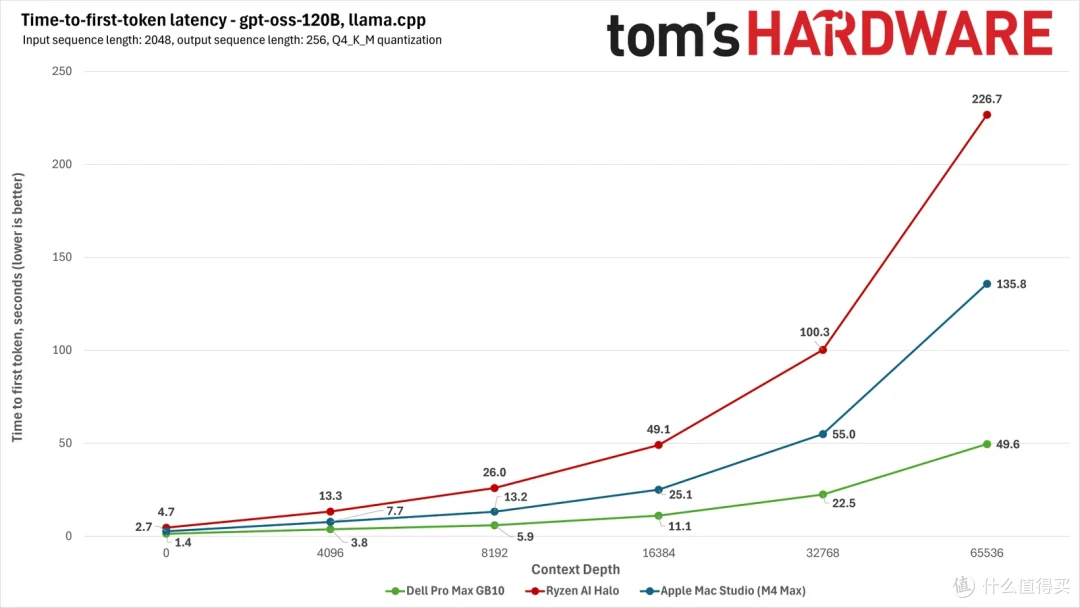
原文比较长,我这里挑选了比较关键的几项测试给大家说说。在Gemma 4 12B、Qwen 3.6-35B-A3B、gpt-oss-120b这三个大模型测试中,M4 Max Mac Studio表现基本都是排在其余两款主机之间,有部分比AMD要强得比较多,而有的则与AMD相近,但NVIDIA GB10优势会更大一些。

而在图像生成的测试中,根据网站说法,最初未能在M4 Max Mac Studio上运行成功,需要改为运行FP16版本的Flux.2 Klein才能完成测试。而且测试结果也不太理想,比起NVIDIA GB10,相差了差不多5倍。
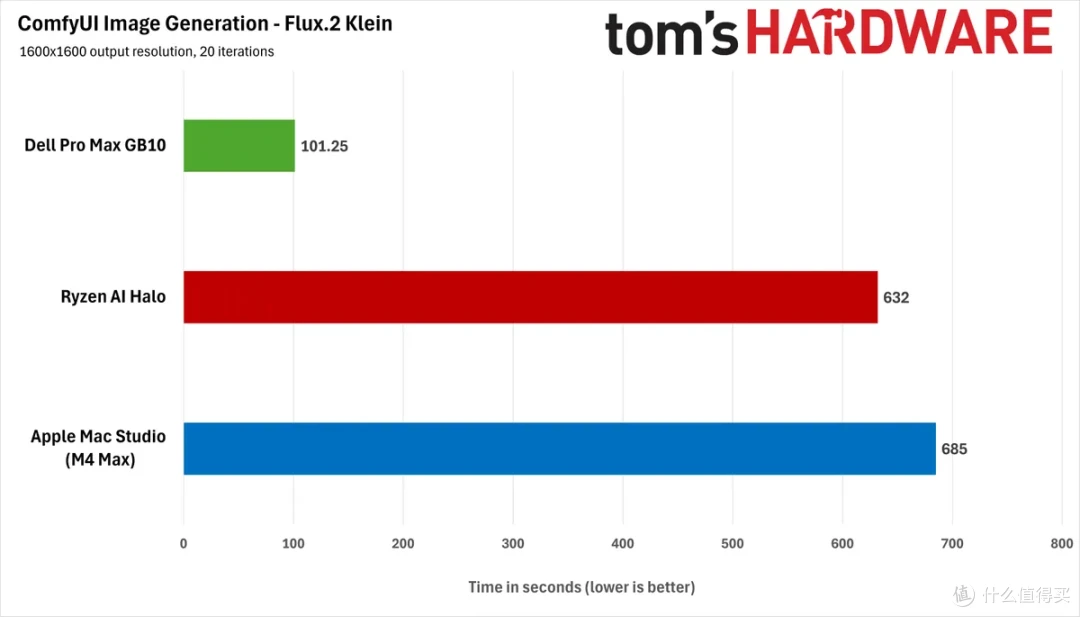
虽然Tom’s Hardware在评测结语中提到,M4 Max Mac Studio表现很亮眼,但不得不承认的是,M4 Max Mac Studio跑本地大模型处理文字还是很不错的,可如果是处理图像方面,就真的是一言难尽。至于AMD Ryzen AI Max+ 395,如果买不起苹果,作为本地AI主机的平替,还是可以的。
五、别为冲动埋单,苹果统一内存这些bug你要懂
不可否认的是,苹果硬件在运行本地大模型确实“技高一筹”,但不足也是显而易见的,入手前,需认清以下两点——
1、装得下≠跑得动
统一内存最擅长的是"把大象塞进冰箱",但塞进去之后呢?能跑但很慢。前文已经提过,苹果512GB的Mac装得下满血版的DeepSeek,但生成速度15.7tok/s。这个速度看起来还行,可首token延迟37.7秒(安装Ollama),这就相当于你向他提问了一个问题,它还需要沉思半分钟才给你答案。
问题根源就在带宽。M4 Pro的内存带宽273GB/s,作为对比,RTX 4090 24 GB GDDR6X显存带宽为1008 GB/s,RTX 5090 32GB GDDR7的显存带宽是1792 GB/s,这样一对比,M4 Pro瞬间不香了。
2、苹果的内存或许是地球上最贵的
作为一个多年在DIY主机打滚的老登一直都不懂,为什么苹果加内存可以这么贵。一台最新款的Mac Studio,标配96GB统一内存,如果要升级到256GB,就得加价2.7W,反之如果是从标配1TB存储容量升级到2TB,仅需3.3K,升级到8TB,也才2.3W。难怪不少小伙伴都说苹果的内存都是用金子做的。

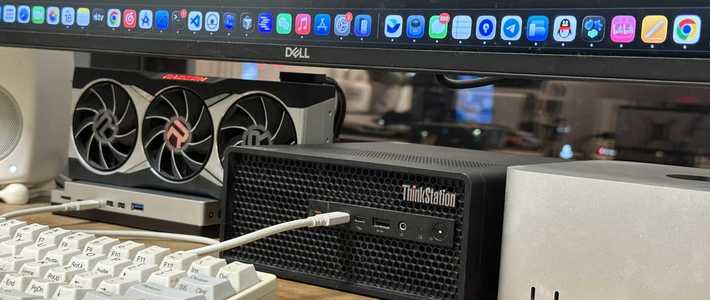
你想后期升级你的苹果内存?No No No,苹果的内存是焊死的——买16GB就是一辈子16GB,想升级?要么旧机换新机,要么买更大内存的机子。而PC党今年插两根,明年加两根,丰俭由人,主打一个自由。
六、所以,到底该怎么选?
现在的内存和存储都涨上天了,除了真爱粉,普通人不建议选择玩本地AI,诸如WorkBuddy、Kimi,豆包这类大模型足够优秀,且不需要过多折腾,即开即用。而对于打算尝鲜,或者是本地部署需要的小伙伴,我的建议是这样的:
1、预算不是很多(6K-8K左右),只想体验本地AI:高配内存的Mac mini是最省心的选择。开箱即用,插上电就能跑,32GB起步、48GB更稳。
2、对于折腾党和极客:基于AMD AI系列的主机是一个不错的选择,128GB内存在Windows/Linux生态里跑大模型是新乐趣,但要做好和驱动、框架磨合的心理准备。当然啦,折腾的乐趣也就在于不断提升自己。
3、如果你是豪门,既要AI又要游戏和生产力:独显PC依然不可替代。16GB显存起步的显卡,小模型速度吊打一切统一内存方案。
4、如果你是想既要又要还要,独显PC+Mac Studio就是你的终极之选了。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~