













16
22
DeepSeek 又"偷偷"更新了:一块五干完的活,别人要烧一百多
2026-10-22 15:11:56
0点赞
0收藏
0评论
永远别信 DeepSeek 这条蓝色大肥鱼嘴里说的"小更新"...
那天看到DeepSeek 又上新了,版本号叫 v4.1-Flash-1017。我第一反应是"哦,修修补补呗",毕竟前面刚发过 v4-Flash、v4-Pro 正式版,还有个原生多模态的 Vision 实验版,连着几波下来人都有点麻了。而且前几天服务才崩过一次,大家心里都有数,这鱼一崩准要搞事。

先看分数。这版在多项基准上比原来的 v4.1-Flash 又抬了一截,像测长周期职业工作流的 Agents' Last Exam、测长时间软件工程的 DeepSWE v1.1,成绩都压过了 Opus 5,基本把之前的国产第一 Kimi K3 全项盖过去。说实话,看到"Flash"这个后缀还能这么打,我有点不太适应。按理说带 Flash 的都是走量的轻量版,现在轻量版直接把旗舰的活抢了。
价格倒是没动。谷时段百万 token 缓存命中 0.02 元,输出 4 元,峰时段翻倍。这个数字放在 2026 年听起来平平无奇,但你要是知道对面同样档位的旗舰什么价,就知道这不是省钱,是拿刀砍。
不过真正让我觉得狠的,是它那张"斩杀线"图。
DeepSeek 自己画的,横轴是完成一个任务平均花多少钱,纵轴是通过率。Fable 5 的 Max 档通过率七成左右,干一个活得烧掉一百多块;v4.1-Flash-1017 的 Max 档通过率七成七往上,一个活大概一块五。图上那个点直接杵在最左上角,底下所有模型都被那条线兜住了。
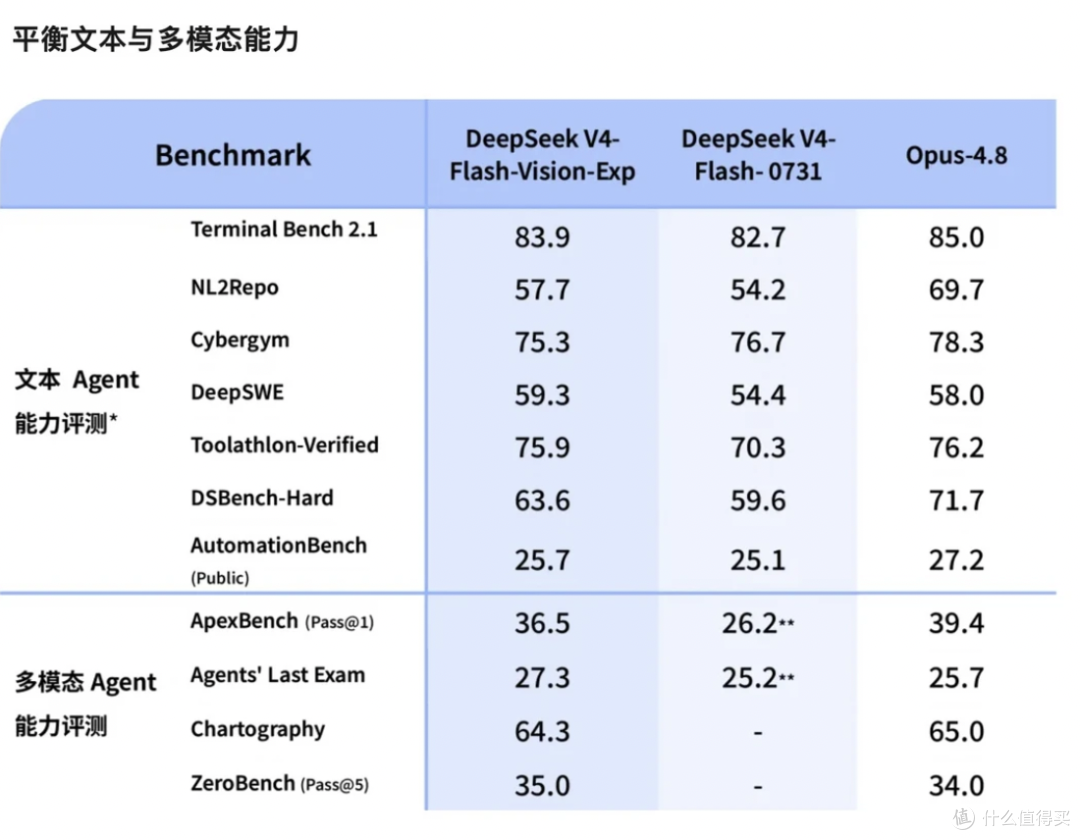
过去两年,模型发布的仪式感基本固定。跑分、榜单、人类最后的考试,谁的高谁赢。这套评价体系有个隐含前提,就是智能越强越好,成本是次要的。可现实里绝大多数人用模型,压根不是在解奥数题。写个脚本、改段报错、把一份表格收拾干净,这类活的要求是"别太笨",不是"全球第一"。
真正卡住人的,是它想得太多。
我自己有过特别典型的经历,让模型改一个几十行的小函数,它先花两分钟梳理需求,再列三种方案,最后挑一种实现,中间还自我复核一遍。结果没错,但那两分钟我本可以去泡杯茶,而不是盯着屏幕等它把简单的事想复杂。这次版本宣称的一大变化就是把这段弯路砍掉,思路直接奔着交付去。

这一点比跑分重要,因为它意味着竞争维度变了。从"谁的脑子更聪明",变成"谁的单位智能更便宜"。
至于宣传里那个"许愿式编程",我觉得媒体容易讲偏。它的看点不在于能做出多炫的演示,而在于它把表达的成本压下去了。
我们这代人对 AI 的使用,很大一部分精力耗在"怎么说清楚"上。脑子里有画面,手上不懂术语,来来回回改提示词,改到最后活没干成,气先泄了。提示词工程这个行业能存在这么久,本身就是个证据。如果模型真能靠极少的信息量猜中你要什么,那省下来的不是时间,是一整套学习成本。

但也不打算吹过头,一次成型做出来的东西,和能维护的东西,中间隔着一条河。演示只要跑通一次就算成功,产品得在别人手里跑一千次。模型生成的原型越容易,后面接手重构的人就越痛苦,这个风险目前没人愿意在发布会上提。
所以我的判断是这样:把它当成一个高速的初级工,立刻能用。写脚本、搭原型、批量清理数据、给个小项目起骨架,这类活现在下手没什么好犹豫的,试错成本低到可以忽略。可要是拿它做需要反复核验的交付,比如涉及金额的核算、对外发布的文本,审校这一步不能省,便宜从来不是跳过检查的理由。
作者提示含AI生成内容。