












 深耕数码兴趣领域






11
16
【图吧杂谈】英特尔14nm、14nm+、14nm++有什么区别?Intel近代工艺详解
2024-04-19 13:24:09
32点赞
74收藏
13评论
额……老铁们,我图吧老捡垃圾的了。最近图吧群友给咱又露了一手,带咱简单分析了一遍英特尔的近代工艺,简单看下情况:


简单来说搁光学显微镜下看了看英特尔的CPU的DIEMark,从老P4 presscott到CORE 2 45nm
当时提到了一句叫65nm到45nm密度几乎翻倍还是挺令人意外的,所以咱简单问了下情况,发现后续的结论更意外。14nm那几个+还是有用,++降低了密度用来跑高频。
过去咱总觉得45nm的CPU就能在图吧刚好够用,英特尔在笔记本上用P9700 P8800这种P系列的笔记本U在25w就能达到35w T系列CPU同样的性能水平,能效高得离谱,不知道怎么做到的,是靠特挑体质还是什么。现在回头看原来45nm也是相当NB的工艺,难怪感觉比65nm强那么多。
Intel的近代工艺来看90nm到65nm密度大了约70%,65nm到45nm密度几乎翻倍, 45nm到32nm密度翻倍,32-22也翻倍,22-14看极限提了3倍,这个对比不同的工艺库得出来的。
90-65是引入打磨耗尽硅,45nm-32nm引入打磨HKMG,22nm引入finfet。14nm引入SAQP,至今未引入EUV(截至10nm依然在用DUV)。
在65nm时代相比90nm能效没怎么提高,极限频率倒是高了不少。
这对于CPU来说当时应该算是很大的提升,90nm时代也没正经双核。 AMD好像在初代速龙X2的时候上过90nm的验证片,但是量产还是走的65nm。 VIA在65nm时代才上双核验证片,40nm量产。整整落后了一代工艺,差不多两代产品,而且VIA的90nm是IBM SOI,65nm是富士通的,相比IA的工艺应该差了不少。
芯片设计这种东西应该说工艺和架构设计缺一不可,如果工艺非常拉那么设计再好也没用,反之如果设计很拉工艺好也还是白给。 12nm的CPU上3.1G都得液氮+爆装备,HT3.0总线卡IO超CPU跑分都不能等比提升,这显然就不是工艺的问题。
而工艺方面1050M的TDP是75W,性能只能和7850坐一桌,1060M才80W,直接干RX570了,前者三星14nm工艺后者TSMC 16nm FF+,能效差了接近一倍。
RTX30系显卡普遍(不含A100的TSMC 7nm)用的三星8nm的密度不到牙膏10nm一半(密度库45MTr/mm²,性能库24MTr/mm²左右),三星n8还是LELELELE,良率也很低,完全就是改名碰瓷,弄得英特尔也直接无语给14nm改名Intel10 10nm改名Intel7。然而后面三星3nm GAA直接良品率0%震撼业界。
英特尔这边近代工艺的参数: 45nm大概3.几mt/mm² 32到了7.几mt/mm² 22有15mt左右
14nm看具体几个+ 14nm有45mt/mm² ++就37.5mt/mm²左右
10nm esf的hd库破100mt/mm²,uhp就66.几
这里主要还是看Intel的14nm到14nm+/++
我理解的就是只是芯片后端设计改了,实际上工艺没变 类似做物理设计的优化给高频提上去了,但是密度下降我还是头一次知道:

英特尔的带+工艺主要是处理gate/cell的参数,14nm+给晶体管长高了些
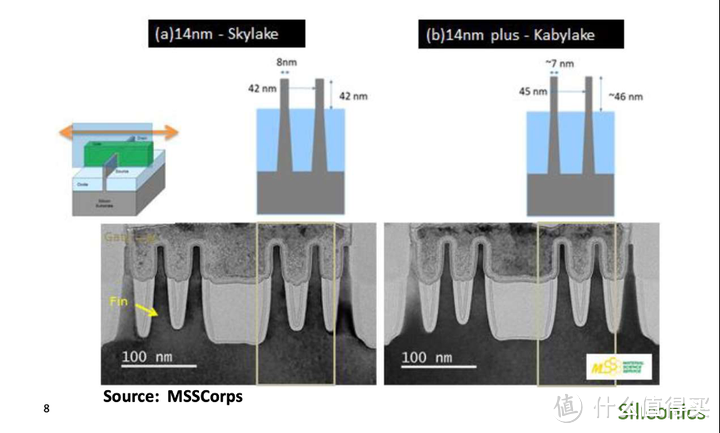
14nm+到++就是加CGP(Contacted Gate Pitch)降低密度

14nm到++的CGP(Contacted Gate Pitch),CCP(Contacted Cell Pitch)加了20%,70nm加到了84nm。

简单来说 14nm+是晶体管长高了,14nm++给两个晶体管隔开了点
对应Intel的CPU就是8-11代。
顺带说下,咱一直觉得INTEL的14nm+的并没有从根本上改进工艺,而只是改进了后端的物理设计,同样的,在没有标称14nm+的ATOM产品线上英特尔也实现了在14nm工艺不变的前提下功耗不变提高了最高主频的操作:


像ATOM的设计其实Intel私底下也一直在打磨,只是没说。所以并没有宣传14nm+,但是很可能已经和+一样采用了相同的优化设计,包括现在改名Intel7的10nm工艺。
intel7也是没写+, 但是多多少少有改进,intel7到7+就给降密度了,13代频率直接起飞靠的就是降的密度,和14nm++同样的套路。
不过这个东西从实际产品这边考证比较困难,dieshot看不出来。就看得出来个大概的电路
所以很难用实际产品来验证Intel是否在ATOM产品线上使用了14nm++一样的操作,但是从Z8500 N3450 N4100 N4120的产品线来看Intel雀食通过同样的14nm工艺一直在保持一定的TDP的前提下不停地提高最大频率。
个人看法是14nm从没+到++的操作,即使是fabless也完全能实现。
根据前面已知的信息来看同样的工艺降密度就能拉高频的话和从密度库换性能库其实也差不多,就是做后端物理设计的时候改改参数的事,实际上就算工艺完全没提升也一样能拉起来频率。

过去AMD在挖掘机时代使用GF的28nm实现了通过优化设计极大地提升了芯片能效,改进了架构设计并实装了完整版特性的HSA异构运算,这样芯片即使在采用了并不适合上高频的密度库(Intel 10nm 工艺,分成了 UHP(超高性能)、HP(高性能)和 HD(高密度)几种库,台积电以往只有2个库,分别是HD库和HP库。)也可以有相近的性能和更好的使用体验。
挖掘机的跑分虽然略有下降,实际游戏帧数反倒更高了,而且挖掘机还砍了缓存,说明命中率应该更高了:


相比过去95W的A8-7650K来看A8 7680和9600在同样使用GF28nm的前提下都可以做到45/65W的TDP,说明在同样的工艺不变的前提下通过优化设计降低能耗提升能效极大地提高用户的实际使用体验是可以做到的。
所以个人认为Intel 14nm+这个操作即使是fabless也完全能实现

这就能解释为啥3年过后,国产CPU用同样的TSMC 16nm FFC工艺能把CPU从3.0G拉到3.3G

能效比提升主要还是靠优化物理设计和原生四核取代八核刀法四核,待机功耗降低靠压最低频率,集显性能提4倍靠的是换GPU架构。
这些都是可以在架构工艺不变前提下就实现的设计优化,而且都能极大提升使用体验,所以个人认为在制程工艺受限的前提下通过优化设计提高产品的整体水平是完全可行的。过去INTEL AMD可以这么干,现在国产U也一样可以这么干。
不过异构大小核这种活现阶段国产U还是可以不干。说实在的我甚至没整明白异构大小核是怎么塞进一个DIE里的

大核直接挂ring上,小核4个凑成一簇,然后挂到ring上,这一簇差不多和大核面积差不多。小核用密度库大核应该用性能库,这不成手机SOC了。上图这个U只有单大核4小核,说实在的这个大核完全可以换成4个小核性能绝对会更高能耗也会降低。完全看不出来这种单大核四小核的异构有啥意义。
这里群友简单给手画了一下这个Lakefield大核的结构图:

INT FPU SIMD 整数 浮点 向量 LSU(Load&Store Unit) BPU(Branch Predictor Unit) bpu和decode在一起的 还有14nm++对比10nmsf的面积:

10nmsf面积在14nm++的40%的样子
10nmesf的hd库破100mt/mm²,uhp就66.几。
这里还有ZEN2的面积对比,这里需要说明的是虽然都标称TSMC 7nm,但是zen2是duv zen3是euv
显卡同理 5000系列duv 6000系列euv,这就类似麒麟990和995的区别了,晶体管数量和能效均有很大提升。所以可以拉更高的频率。
6700xt用基本一样的流处理器个数和功耗 实现了5700xt大概1.4倍性能,换言之就是能效达到1.4倍。EUV还是有用的,未来国产芯片指定是要上国产EUV的,只是时间问题。

英特尔现阶段还在用DUV打EUV,靠的是降低晶体管密度拉高频实现的性能提升,而这种性能提升的代价就是功耗爆炸。
通过大小核刷分也无法带给用户直观的体验提升,所以刷了白刷。


其实真正的提升性能的有效方法还得看AMD,用MCM多DIE封装CCD+IOD用IF总线连接最大程度的降低成本同时保证工艺优势的前提下依靠高能效尽量多堆核,还可以用3D封装来堆缓存(5800X3D)。都可以有效地提升性能和使用体验,而且成本和使用成本(主要是功耗)也不会过高。
目前这种chiplet的模式国产CPU已经有在抄作业的了,效果应该说相当不错,未来很可能大规模推广。至于大小核刷分之类的操作还是不要玩了,短时间内来看没啥前景。现阶段在工艺劣势的前提下也不要过分追求高性能,能耗上得不偿失,过去AMD在工艺劣势的前提下优化的是APU的能效提升使用体验而不是强拉性能,这其实就是很正确的选择。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~









题主完全对fab怎么提升关键尺寸没点概念,包括里面用了哪些骚操作...
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
题主完全对fab怎么提升关键尺寸没点概念,包括里面用了哪些骚操作...
校验提示文案
校验提示文案