

RTX Spark 迷你工作站剪视频、做 3D 是"够用且有余":图形底子接近桌面 RTX 5070,但它真正的好用不在传统剪辑速度,而在传统显卡"显存装不下"的大场景与 AI 视频流里;代价是三万多元的起步价和 Windows on ARM 的兼容摩擦。
11 月 18 日,RTX Spark 紧凑型桌面主机正式上市,首批开售机型来自华硕、机械革命与微星。知乎知乎
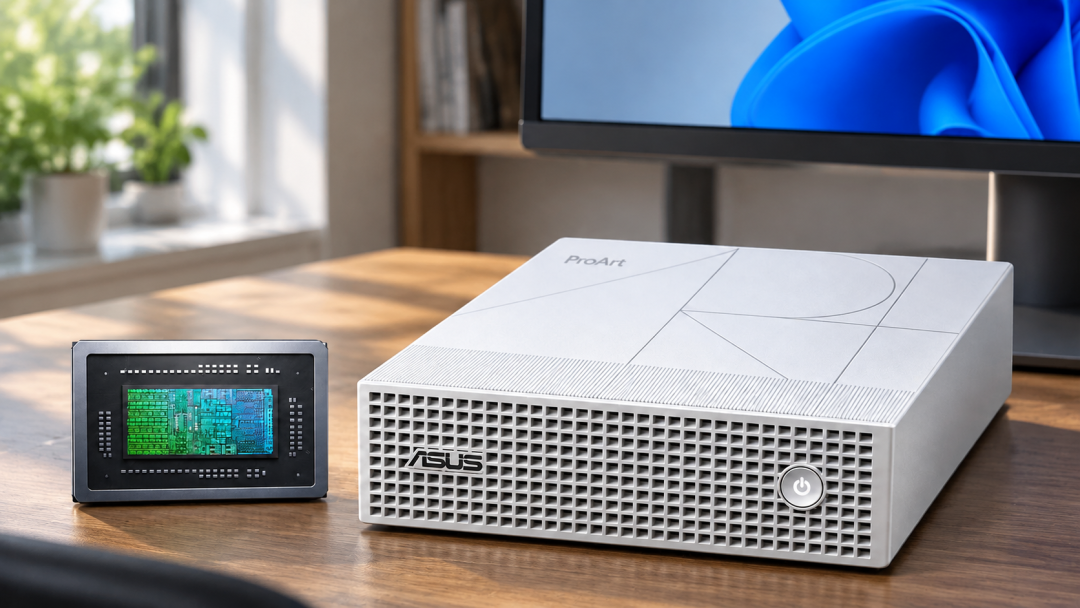
这颗 N1X 超级芯片把 20 核 Grace CPU 与 6,144 个 CUDA 核心的 Blackwell RTX GPU 封装在同一颗 SoC 里,配最高 128 GB 统一内存、1.1 升 140W 的小机身,提供最高 1 Petaflop AI 性能,官方称可本地运行最高 1200 亿参数的大模型。它运行 Windows on ARM,与 DGX Spark 同属一个芯片家族:DGX Spark 预装 Linux、支持多机组网,RTX Spark 则面向单机的 Windows 生态。知乎知乎
价格方面,华硕 ProArt GR1X 64GB+2TB 版 34999 元、128GB+4TB 版 54999 元。机械革命大师之路 X10 的 64GB+1TB 版 32999 元、128GB+2TB 版 49999 元。微星 EdgeMesa N AI+ 的 64GB+1TB 基础版同样从 33999 元起。宏碁、戴尔、技嘉、惠普及微软 Surface Dev Box 也在路上。微博微博知乎
剪视频:官方加速已兑现,纯编码不是强项
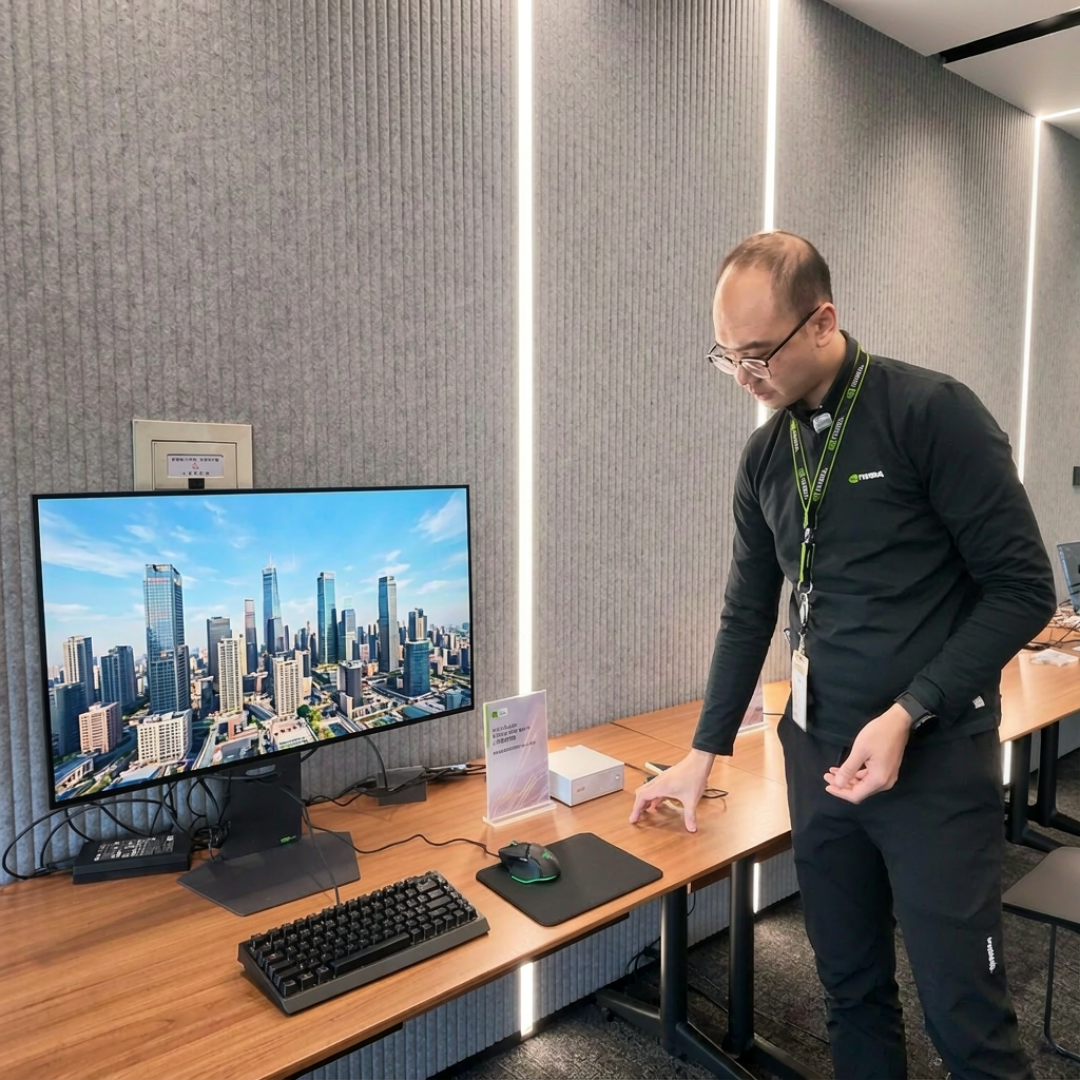
剪辑是这台机器的常规作战场,官方承诺的软件侧加速都在兑现:Adobe Premiere 正通过 TensorRT-RTX 加速语音增强、对象蒙版、场景编辑检测、自动重构图等多项 AI 编辑功能,官方称日常 H.264 视频交付任务的周转时间可缩短 50% 以上。对专业流程,它还支持流畅实时编辑 4:2:2 高色彩采样视频,即专业相机常用、对硬件压力远高于普通视频的录制格式。知乎知乎
媒体实测补上了另一半答案。视频导出、编译这类 CPU 负载可以轻松胜任,GR1X 在 Cinebench 2026 的 ARM 原生成绩为单线程 545 分、多线程 7268 分,约为桌面旗舰酷睿 Ultra 9 285K(多线程 9763 分)的 74%。但纯 CPU 编码的收益有限:同一颗芯片从笔记本形态升到 140W 桌面形态,x265 编码成绩仅从 4.32 提升到 4.46 帧/秒。想让剪辑真正变快,要走 GPU 加速管线,而不是指望 ARM 处理器硬算。知乎知乎
做 3D:渲染贴着桌面 RTX 5070,大场景才是独门优势
图形底子的硬指标在渲染基准。Blender 5.3 的 GPU 渲染测试中,GR1X 在 monster、junkshop、classroom 三个经典场景分别取得 1824、1400、1289 分,中小规模场景已基本摸到桌面 RTX 5070 的渲染水平;V-Ray 6.02 RTX 测试拿到 2831 分,建筑可视化、产品渲染这类生产级负载不成问题。创作软件也在跟上:Adobe Substance 3D Painter 12.2 首次在公开测试版提供 Arm 原生支持,Blender 5.3 更把 DLSS 4.5 光线重建集成进 Cycles 视口,让艺术家在交互预览里就能看到接近最终成片质量的光照和材质。知乎知乎
"装得下"才是独门优势。传统显卡场景放不进显存就卡顿,而这台机器的官方能力是实时渲染超过 90GB 的 3D 场景,发布会现场用虚幻 5 的复杂城市街景做了演示。知乎
AI 视频流则划出了它与游戏工作站的真正分界。楠爷实测把一段 15 秒 720p 低码率素材超分修复到 1440p,从冷启动到渲染完成耗时 4.3 小时,峰值显存占用超过 70GB——这个门槛直接把 32GB 显存的 RTX 5090 挡在门外,想在传统工作站上跑通至少得 72GB 级专业显卡起步。Edison Chen 测的图生视频更日常:2560×1440、8 秒的参考生视频耗时 33 分 42 秒。Huden Jear 在 64GB 版上用开源视频模型生成一段 5 秒 720p 片段,一分钟上下就能出片。这类"显存门槛型"任务,是它相对同价位游戏工作站几乎不可替代的价值。知乎知乎知乎
好用之外,三个必须接受的前提
第一是生态摩擦。多数 x86 软件在 Windows on Arm 上靠转译运行,微型计算机的结论是个别软件的兼容性边角仍需要补齐。装环境要注意依赖的 ARM64 版本,Edison Chen 还提醒过一个具体陷阱:加载 70GB 级模型时 WDDM 驱动会误报内存不足,解决办法是手动把虚拟内存设置为 128GB。硬件细节上也有代价,整机一个 USB-A 接口都没有,日常接 U 盘或无线接收器不太方便。知乎知乎知乎
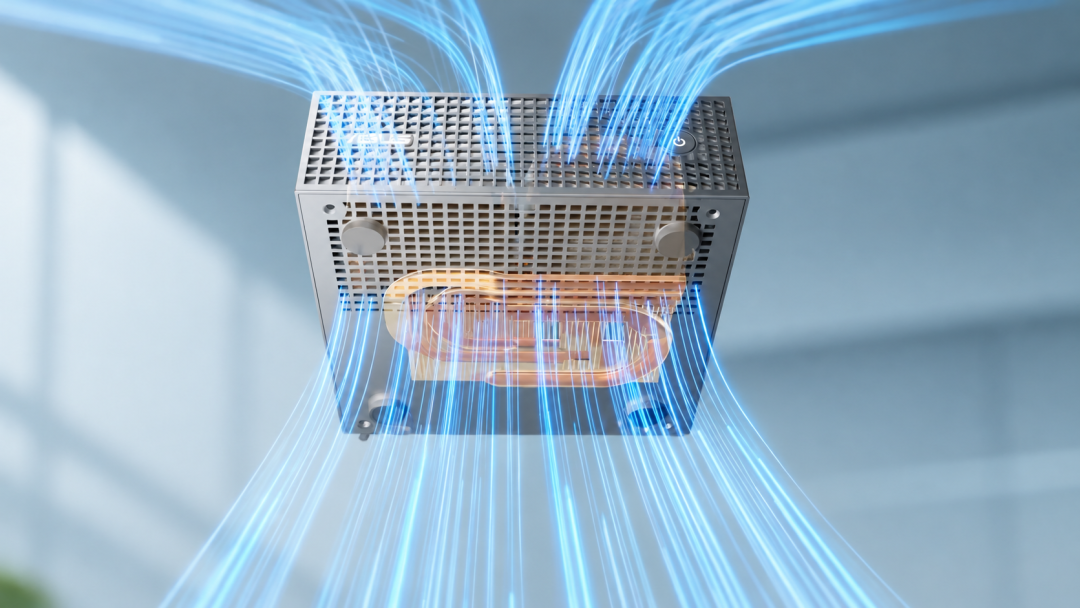
第二是吞吐天花板。双烤满载时 CPU 与 GPU 的功耗分配稳定在 60W 加 80W、合计正好达到标称的 140W,大散热模组压得住。约 300 GB/s 的统一内存带宽决定了重吞吐负载的上限,稠密超大模型解码会明显变慢,超分这类任务更是按小时计。知乎知乎
第三才是价格与电费账。同样的钱在 DIY 市场能凑出 RTX 5090 级主机,传统渲染导出它未必更快,B 站评测区里"目前卖的和五菱宏光一个价"就是代表性的观望情绪。它的省钱逻辑在另一头:模型驻留、没有推理任务时整机功耗仅为 15W,7×24 小时全年开机一个月电费只要几块钱。官方还做过一笔账:同一台机器本地产出 6100 万 Token 的电费成本约为 20 美元,同样的 Token 量走云端 API 大约是 1200 美元。哔哩哔哩知乎知乎
谁该买,谁不该买
适合单人单机的创作者:剪辑、3D、AI 生图生视频要在同一台机器闭环,需要大显存工作流,或者已有高性能主力机、想加一台安静低功耗的本地 AI 节点。对日常问答和辅助写作,27B 级模型单流解码速度达到 64.8 token/s,体验已经足够跟手。纯传统渲染求极限速度、同预算装机更快的场景不建议上车;需要多人并发推理的团队也不适用——那属于 DGX Spark 的多机互联场景,RTX Spark 单机形态接不了这种负载。把兼容性摩擦当不可接受成本的用户同样要慎重——评测区"这玩意 10k 到 15k 是有市场的"的高赞吐槽,说的正是当前价格离大众心理线还有距离。知乎哔哩哔哩
一句话收束:实测层面"好用"成立,但它重新定义的不是剪辑速度,而是三万多元能买到一台"既装得下 90GB 场景、又付得起整夜电费"的桌面 AI 创作节点这件事本身。

当前文章无评论,是时候发表评论了