

















27
35
本人数字人讲展览,先选输入再试听术语
2026-10-14 12:11:33
0点赞
0收藏
0评论
想做本人数字人口播,应先在剪映当前数字人相关入口确认可接受的照片、视频或声音输入,再决定方案。展览简介通常有展品名称、编号和专有词;形象生成得像本人,并不代表这些词会读对。本文给出选型与验收流程,没有个人生成实测,也不把某种输入写成对所有端都有效的答案。
原先真人拍摄需要组织场地、状态和补录,数字人可以成为另一种表达方式,但会增加输入授权、生成检查与局部纠错。是否值得用,要看你是否需要本人形象、是否有合法声音样本,以及是否能接受逐句校对。先做一段正式名称较多的讲解,比先安排整场展览更容易发现边界。
决策一:是否必须保留本人形象
需要本人作为讲解者时,选择自有且清楚的形象材料,按当前页面要求提交;当前入口接受什么类型,就准备什么类型。不能从“数字人存在”直接推断照片、长视频或任意截帧都能作为同一套输入。不要为了凑资料,用未经同意的其他人照片试验。
如果观众只需要听懂展品信息,实物图片加文字朗读、真人短句补录也可以满足任务。它们与本人数字人的体验不同,却可能减少形象处理。选择依据是展览表达,而非是否用了更多 AI 功能。输入不符合条件时,先换材料或采用替代方案,不把后期美颜当作补救一切的方式。
决策二:声音要像本人,还是只要清楚
剪映文本朗读提供现成音色与当前可用的声音能力,合法音色克隆需要本人或明确授权的声音。需要本人声线时,先按页面要求准备安静、单人、少回声的样本;本文不固定录音秒数、处理时间或积分。现成音色能满足讲解时,不必额外引入声音克隆。
选好后用展品名、编号、数字和外语术语试听。声音相似度与内容准确度应分开核:像本人但误读名称,仍不能交付。音色授权也不等于展品图和背景音乐授权,相关素材各自确认。生成前查看预计消耗,生成后核积分记录,避免用历史截图计算当前成本。
决策三:文案是否适合分段纠错
长句把展品名、年代与评价连在一起,出错时可能难以局部替换。先按信息单元拆成短段,保留语义与自然停顿,不把每个字都断成机械节奏。名称或编号单独成句时,应核它仍能解释这一件展品,而不是离开上下文的一串数字。
当前结果支持后编辑或局部生成时,可逐段纠错;只有整段能力时,则在创作前调整文案组织。不能承诺任意生成成片都能逐字修改,也不能只改显示字幕就认为声音和口型跟着改变。
从输入到交付的连续流程
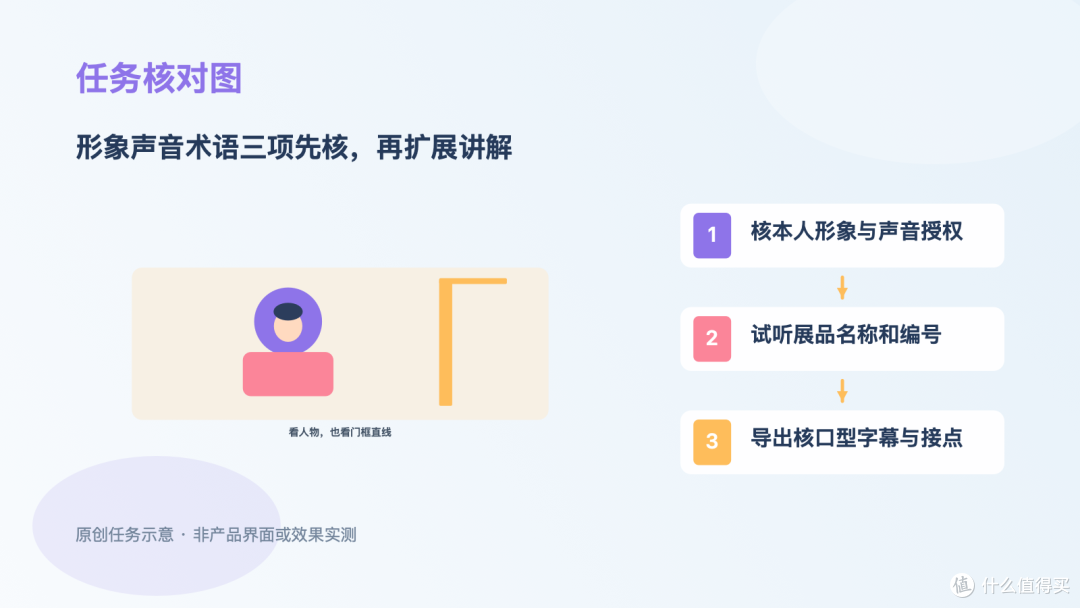
- 整理本人或获授权形象、合法声音和正式展品资料,留原文件及授权记录。
- 在当前数字人入口核输入条件与权益,用含名称、编号的短段试样,不先生成全部讲解。
- 先听语音,逐项核数字、专名、停顿与情绪,再看人物口型和表情。
- 回可用编辑流程调整镜头、字幕和背景,确保图片对应当前讲解的展品。
- 导出实际文件核声音、口型、字幕与前后连接,再决定是否扩展到其他内容。
验收要从观众视角完整看,不能只截脸部最自然的一帧。讲解对象清楚、术语准确、人工校对记录可回查,比生成页面显示完成更能说明交付状态。
优点、缺点与投入
这类方案的优点是能把形象、声音与文字组织在可修改的制作流程中;缺点是自然度、术语读法和可编辑范围都需要检查,不能省掉内容责任。投入不仅是页面显示的权益,还包括准备材料、试听、纠错和导出检查时间,没有本次实测不能给效率提升比例。
展品图加朗读适合信息明确且不需要本人形象的场景;真人短段拍摄适合需要现场情感或动作的讲解;数字人适合接受 AI 表达且能认真校对的内容。三种方案按同一标准看术语、图文对应和观众理解,而非只比较有没有人物画面。
失败分支与常见问题
失败一:形象正常,编号读错。回正式资料调整文案或读法,重新试听对应短句,字幕也同步核。 失败二:短样自然,拼接后声音突然换调。核所用音色、文案与版本,替换错误区间,必要时换完整短段。
Q1:照片好看就能直接用吗? A:要先核当前输入要求与授权,再看完整动作和口型。 Q2:可以一口气生成全部讲解吗? A:先短样更容易发现边界,再按通过条件扩展;没有效果保证。
当前入口、模型和积分按页面确认,AI参与制作按平台要求声明,配图为原创输入关系示意。值不值得用,先看这一段术语讲解能否通过上述验收。
作者提示含AI生成内容。





