







10
34
单张 RTX 5090 跑 Qwen3.8-Flash-Next:量化从 Q3 升到 Q8
2026-10-30 08:18:41
0点赞
0收藏
1评论
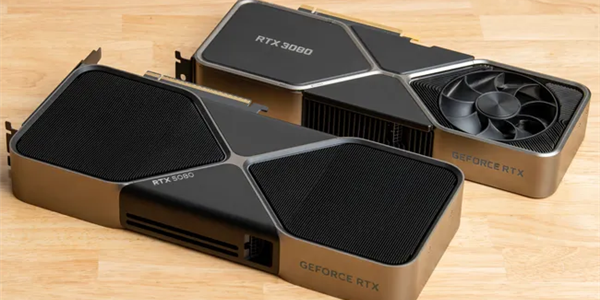
ToolHalla 实验室 2026 年 10 月 27 至 28 日在一台工作站上测完 Qwen3.8-Flash-Next 的五档量化:单张 RTX 5090(32 GB)、128 GB DDR5-5600 内存、引擎 Strata 0.1.48,51.2B 参数的 ngram 查表统一放在 Intel Optane P5800X 上直读。五档共 140 个测试格,每格三次实测取平均。
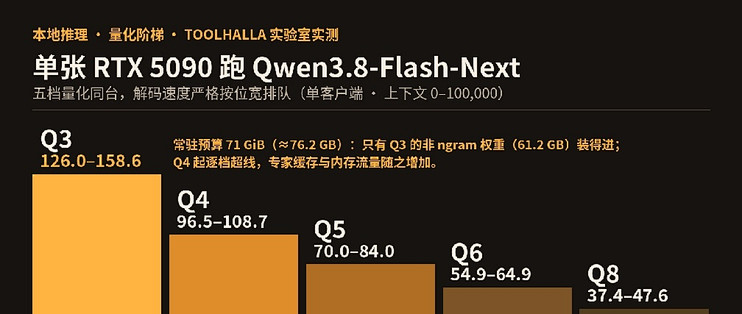
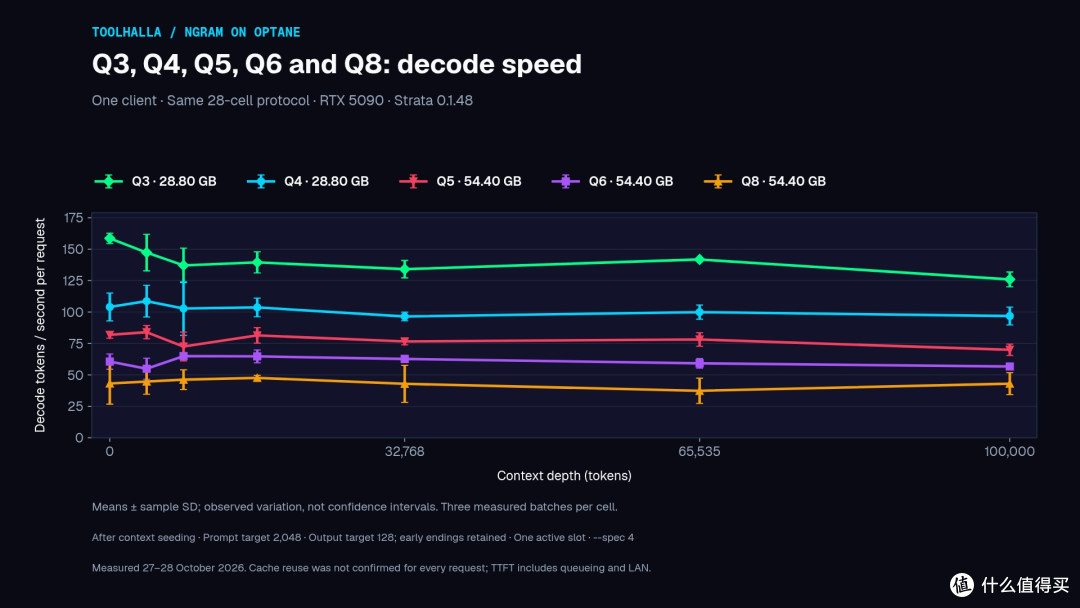
单客户端、上下文 0 到 100,000,解码速度全程严格按位宽排队:UD-Q3_K_XL 126.0–158.6 tok/s,UD-Q4_K_XL 96.5–108.7,UD-Q5_K_XL 70.0–84.0,UD-Q6_K_XL 54.9–64.9,Q8_0 37.4–47.6。Q4 比 Q8 快 2.18–2.67 倍(原文对照口径)。
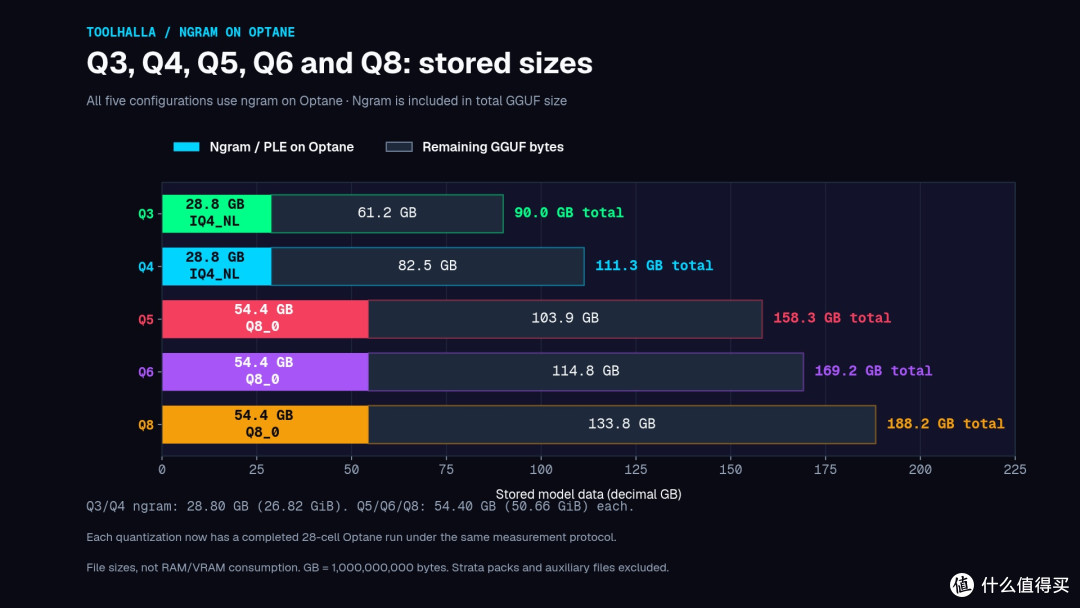
分界线是常驻预算。Strata 把骨干权重锁在 71 GiB 常驻预算内(显存约 30.5 GiB+内存约 40.5 GiB)。非 ngram 权重 Q3 为 61.2 GB,装得进;Q4 82.5 GB 起逐档超线,专家缓存与内存流量随之增加,速度台阶式下滑。总文件体积从 Q3 的 90.0 GB 涨到 Q8 的 188.2 GB。
ngram 表能放固态硬盘,是因为查表是稀疏的:第 2 层每个 token 只取 320,001,536 行中的 16 行,约 5 KiB,拼的是 4K 随机读延迟。原文给的口径是 Optane P5800X 低于 6 µs、普通 TLC NVMe 约 50–80 µs。Q3 与 Q4 的表为 28.80 GB(IQ4_NL),Q5 起为 54.40 GB(Q8_0)。
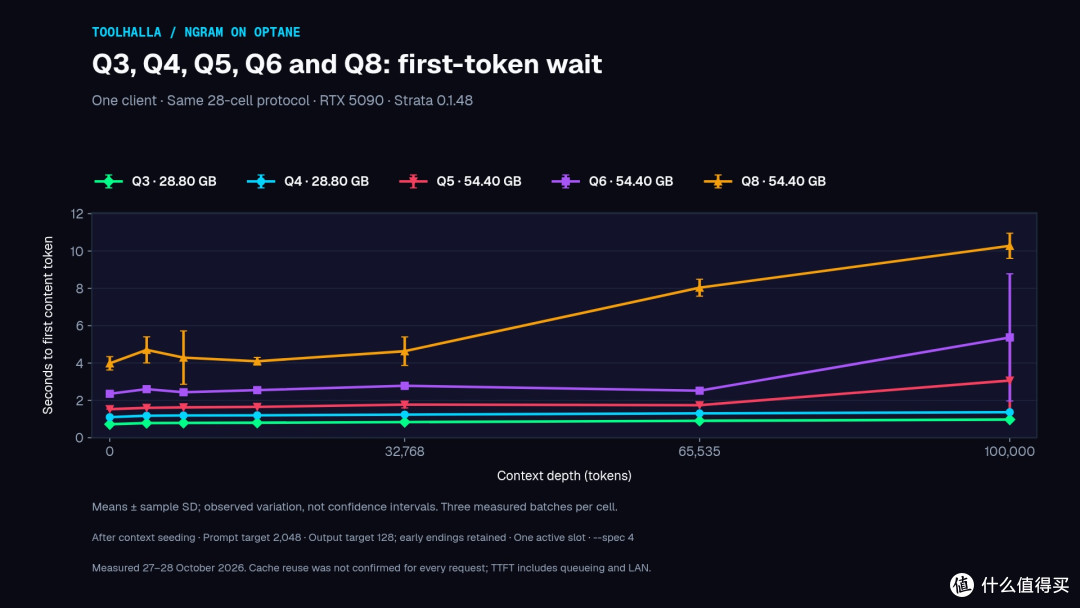
上下文 100,000 时首 token 延迟:Q3 0.97 秒,Q4 1.37 秒,Q5 3.06 秒,Q6 5.37 秒,Q8 10.28 秒。多客户端共用一个服务槽,并发只是排队:32,768 深度、10 个客户端时平均 TTFT 为 Q3 32.61 秒、Q8 109.24 秒。
这组测试只测了速度:原文没有测困惑度或 KL 散度,五档之间的输出质量无从比较。五档在同一台机器上顺序跑完、没有随机交错,误差棒是批内标准差;数据出自一家实验室,未见第三方复现。











校验提示文案
校验提示文案