








22
63
一张3090狂飙千问27B:64路并发破千tok/s,本地大模型终于飞起
2026-11-01 09:23:23
1点赞
2收藏
0评论
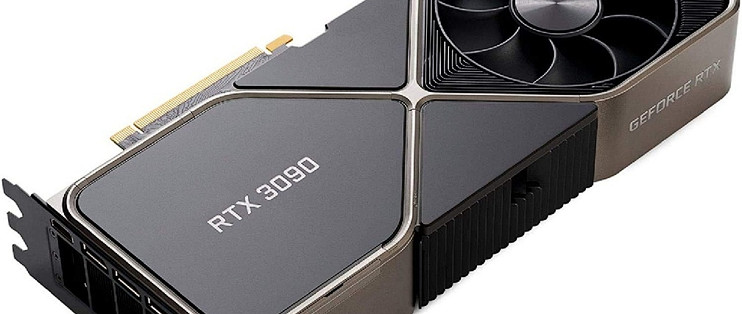
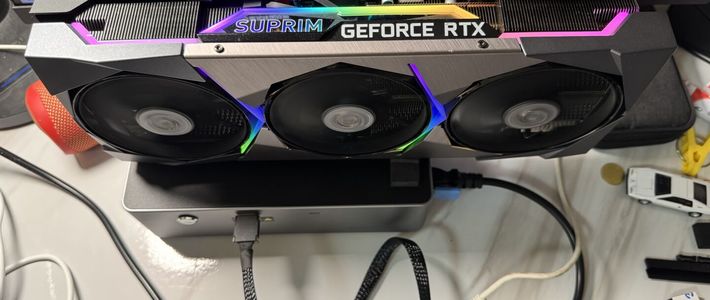
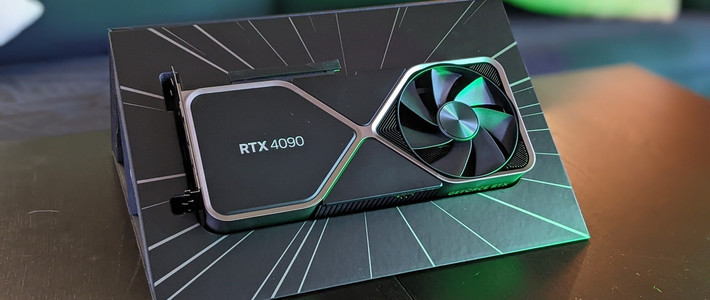
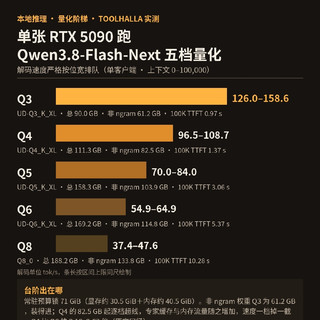
你是不是也觉得27B级别的模型只能靠云端或者多卡堆?HyperQwen这个开源项目直接打破了这个印象。它针对vLLM做了深度补丁和量化优化,在单张RTX 3090(24GB显存,功耗锁死250W)上稳定跑起了Qwen3.8-27B。
实测成绩相当硬核。单用户普通聊天大概127 tok/s,如果模型在复述或引用提示词内容,速度能冲到381 tok/s左右;最夸张的是64路并发一起跑,合计吞吐直接破了1035 tok/s。上下文最长支持15万token,用特殊KV缓存还能再往上扩。这些数字不是理论值,是官方和社区在同一张卡上反复测出来的。
部署几乎零门槛。克隆GitHub仓库syv-ai/HyperQwen,复制环境文件后,一条docker compose命令就能起来:single模式适合几个人聊天,batch模式专门应对高并发API。第一次启动会拉约9.5GB镜像,再本地量化模型大概20GB,之后就顺畅了。前缀缓存、投机解码、查找式草稿等优化叠在一起,让老显卡也能打出接近甚至超过很多云服务的体感。
这意味着什么?家里那张吃灰的3090终于可以当私有大模型服务器用了。写代码、处理长文档、本地Agent、RAG检索,都不再需要把数据交出去。软件优化硬生生把硬件寿命又延长了一大截。
想验证的话直接去GitHub搜HyperQwen,跑起来看看你的卡能到多少tok/s。本地大模型的门槛,真的被这张卡踩穿了。