







20
24
Gemini 4 Carbon 发布:先给网络安全防御者,AA 指数 59 分登顶
2026-11-01 10:24:42
0点赞
0收藏
0评论
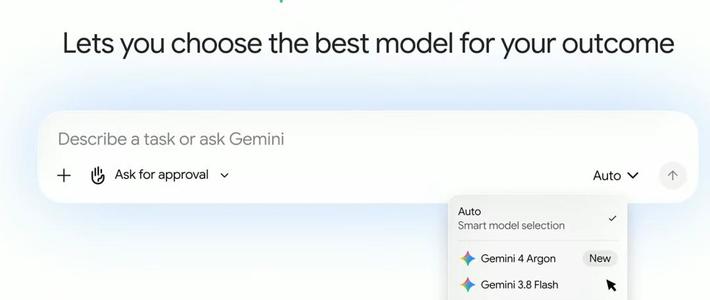
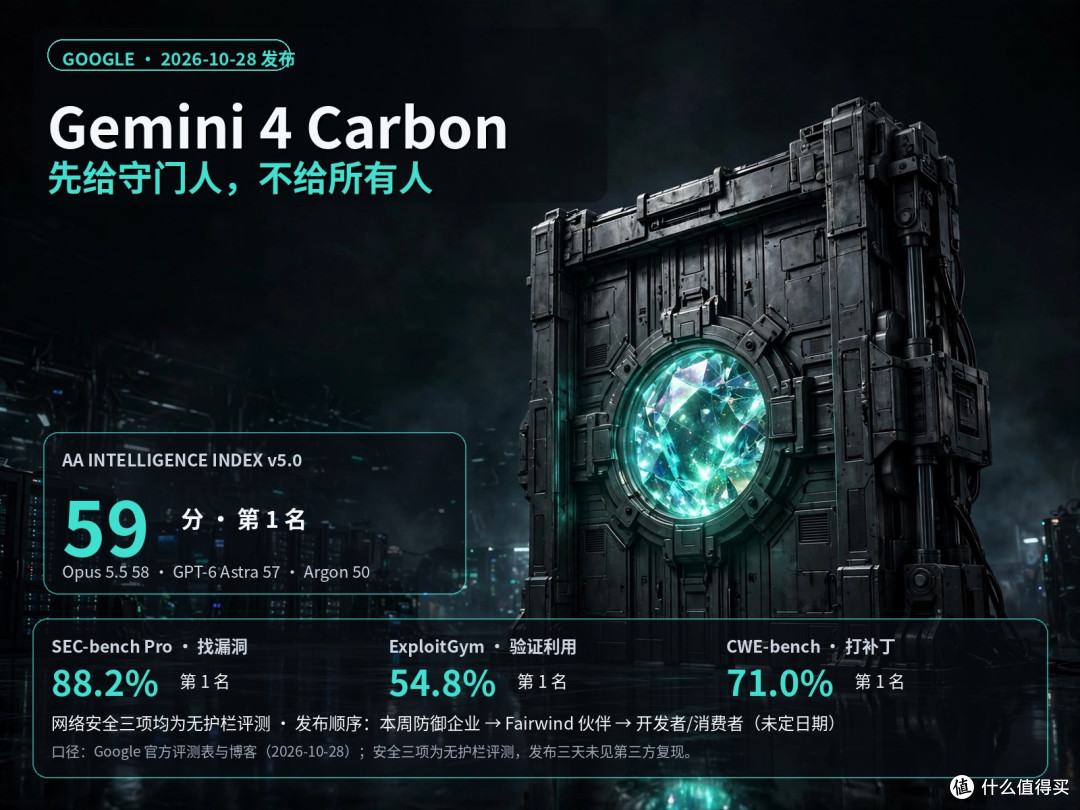
Google 于 2026 年 10 月 28 日发布 Gemini 4 Carbon,距离上一款 Gemini 4 Argon 仅两周。如此短的间隔,使 Carbon 的定位显得格外明确:它是 Google 自家当前最强模型,主打网络安全与长程任务,而不是一次常规的版本迭代。更值得关注的是发布方式——Carbon 先于模型本身开放:本周起只向一部分网络安全防御企业提供使用,之后通过 Fairwind Program 逐步扩大到受信任伙伴;面向开发者、企业与消费者的版本则没有给出日期。与此同时,美国政府的发布前自愿测试流程也在同步进行中。这种“先小范围、先防御场景、先受信任伙伴”的节奏,与其安全主轴相互呼应。
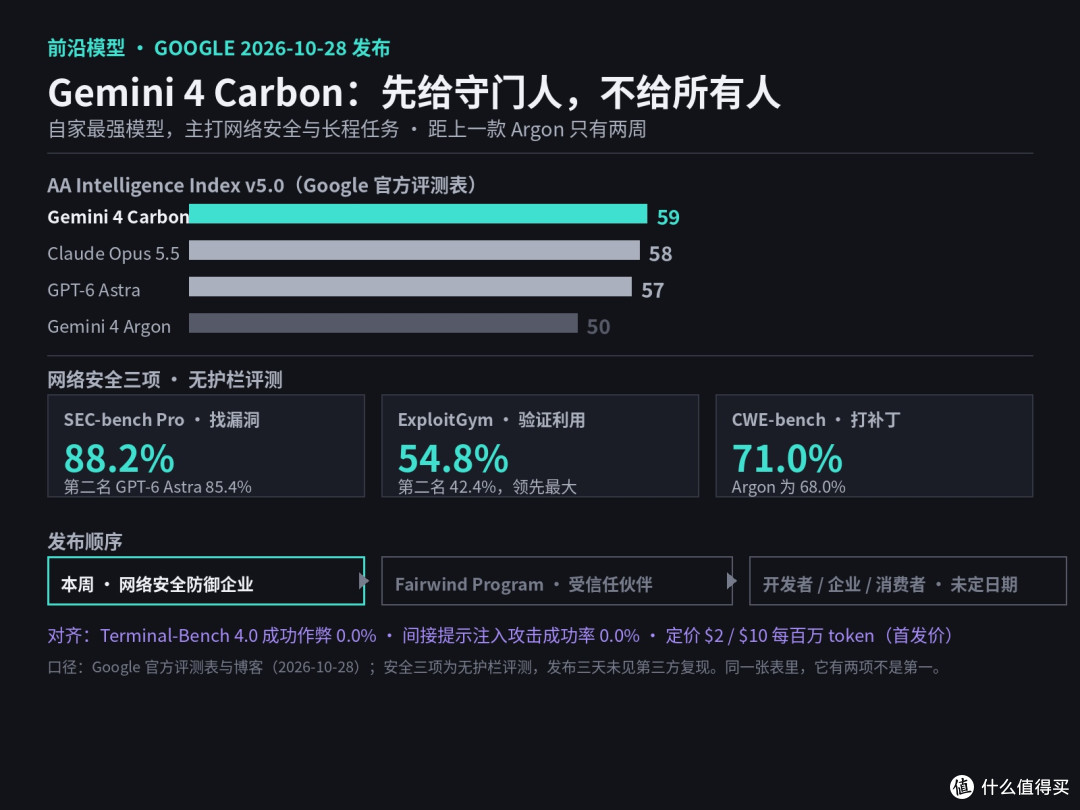
在综合榜上,Carbon 在 Artificial Analysis Intelligence Index v5.0 得 59 分,位列第一;同一张表中,Claude Opus 5.5 为 58 分,GPT-6 Astra 为 57 分,自家 Argon 为 50 分。需要说明的是,这一口径来自 Google 官方评测表。分数差距不算悬殊,但 Carbon 仍以 1 至 2 分优势处在榜首,同时较 Argon 提升 9 分,显示出两代之间的明显跃迁。
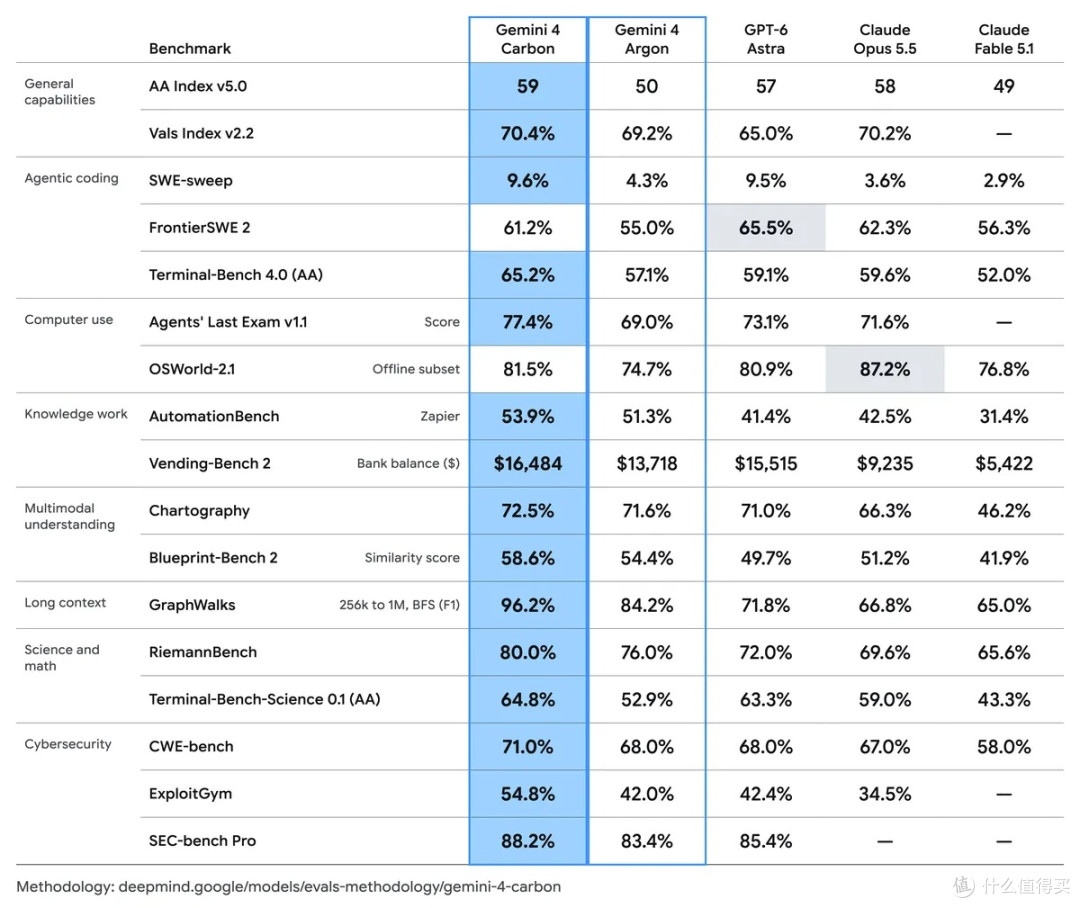
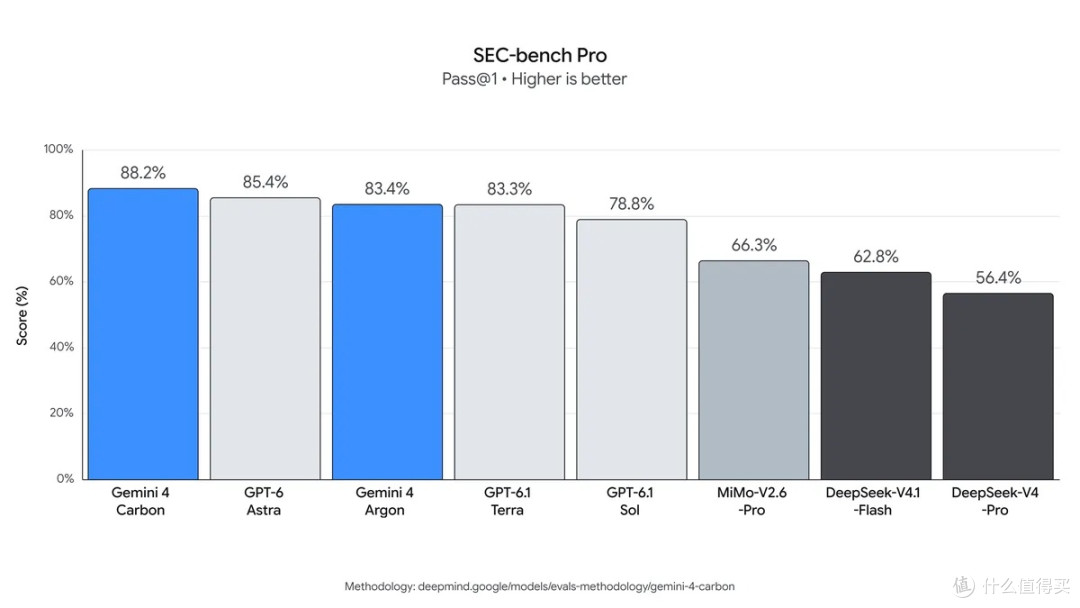
安全是这次发布的主轴。三项外部基准均为无护栏评测:找漏洞的 SEC-bench Pro 得 88.2%,验证漏洞可利用性的 ExploitGym 得 54.8%,打补丁的 CWE-bench 得 71.0%。其中 ExploitGym 的领先幅度最大,第二名是 GPT-6 Astra 的 42.4%,差距达到 12.4 个百分点。Google 内部口径还有两项:生成安全代码的成功率是 Argon 的两倍多;Chrome 团队称 Carbon 生成高质量补丁的表现是另一家实验室前沿模型的 10 倍以上,但未点名该模型。这些数字共同强化了 Carbon 在漏洞发现、可利用性验证和补丁生成链条上的定位。
不过,Carbon 并非全项第一。同一张官方表里,FrontierSWE 2 为 61.2%,低于 GPT-6 Astra 的 65.5% 与 Opus 5.5 的 62.3%;OSWorld-2.1 离线子集为 81.5%,低于 Opus 5.5 的 87.2%。长上下文一项则跳得明显:GraphWalks(256K 到 1M)达到 96.2%,比 Argon 高 12 个百分点。WebDev Arena 上升 89 个 Elo 分到第 4 名(1768)。这说明 Carbon 的优势集中在安全与长程能力,但在部分软件工程和离线代理任务上仍有对手领先。
对齐数字单独成段:Terminal-Bench 4.0 上成功作弊降到 0.0%,作弊尝试率为 0.4%;Gray Swan 间接提示注入基准的攻击成功率为 0.0%(Argon 为 0.7%);内部实测中,无依据断言比 Argon 少约一半,过度执行减少 26%、服务不足减少 29%。这些指标分别对应作弊、提示注入、事实性和执行边界,构成了 Carbon 安全叙事的另一面。
定价与 Argon 的首发价相同:输入每百万 token 2 美元、输出 10 美元,缓存输入按标准价的 5% 计。综合来看,全部基准均为 Google 自报口径,安全三项注明是在无护栏条件下评测;发布才三天,尚未见第三方复现。因此,Carbon 的榜首位置与安全优势目前仍应视为厂商披露结果,后续独立评测和更大范围开放后的表现值得继续观察。