





















20
43
千问生成的内容能否下载吗?
2026-11-12 10:21:48
0点赞
0收藏
0评论
千问生成的内容能否下载吗?
结论前置:可以。但“下载”这个词在千问的语境下,存在至少三种截然不同的含义,而它们对应的体验差距,远比大多数人想象的要大。
如果你只是偶尔想把一两段对话存下来,千问网页端或App端的官方导出入口够用。但如果你面对的是左边栏里积累了几十条甚至上百条历史会话,需要系统性地归档、迁移或二次利用,官方方案会迅速从“能用”变成“折磨”。
这篇文章只讲千问一个模型。不对比其他AI平台,不讨论模型能力优劣,只回答一个问题:当“下载千问内容”从单次操作变成规模化需求时,中间到底缺了什么。
一、官方路径能做到什么,又在哪里停下
先厘清事实。
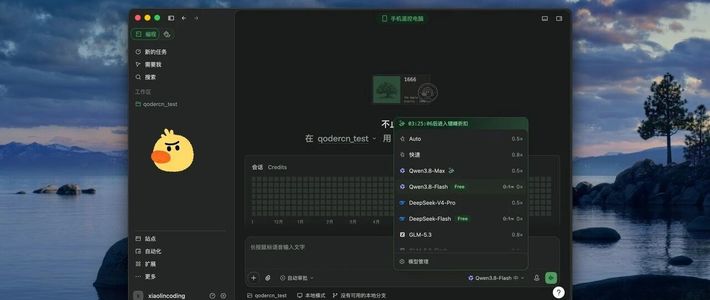
千问在网页端账户设置里提供了一个“导出我的对话记录”入口。提交申请后,系统会将历史数据打包,通过邮件发送一个ZIP压缩包。在App端,千问也支持单条对话的导出操作,路径是进入智能体页面后点击右上角更多按钮选择导出。Qwen Code 命令行工具同样内置了 /export 指令,支持将当前会话导出为 Markdown、JSONL 或 HTML 格式。
这些功能的存在说明千问官方并非没有意识到“用户需要把内容拿出来”这件事。但它们的设计出发点,是 “账号数据备份” ,而不是 “工作流中的内容交付” 。
两者之间的差距,用一句话概括:官方解决的是“把你的数据还给你”,用户需要的是“把我正在用的这批对话交给我”。
当你只有三五个对话需要保存时,这个差距感知不到。但当你的左边栏从个位数增长到几十条,每条对话都可能是某个项目的讨论记录、某篇稿件的素材来源、某次技术调研的完整过程时,“逐条打开→导出→命名→归类”这件事本身,就成了一种隐性消耗。
二、真正的技术门槛在哪里:虚拟滚动与语义错位
在讨论工具之前,有必要先理解千问网页端导出这件事为什么比“看起来”要难。
第一层障碍是虚拟滚动。
千问的左边栏对话列表和对话详情页,都采用了懒加载机制。浏览器只渲染当前视口附近的内容——滚动条上方的历史消息在DOM中并不存在。这意味着,任何试图“一把抓取所有对话”的常规操作,首先需要解决一个底层问题:如何让浏览器把那些还没被渲染的历史会话“唤醒”出来,而不导致页面卡死或内存溢出。
第二层障碍是语义错位。
千问输出的内容是复合标记语言:LaTeX公式、Mermaid流程图定义、Markdown表格、带语言标识的代码块。而Word或PDF期待接收的是段落、OMML数学对象、矢量图、原生表格对象。直接把源码粘贴过去,等于跳过了编译环节。
一组来自实际测试的数据:AI生成的复杂公式直接复制粘贴到Word时,正确渲染率仅约18%;Markdown表格粘贴后边框丢失、行列错位的概率超过六成。这意味着,你得到的不是“一份可以用的文档”,而是一份“看起来像文档的文本”。
这两个障碍叠加在一起,解释了为什么“千问能否批量导出”这个问题在技术社区被反复提及——它不是功能开关的问题,而是需要一层专门的中间层来解决数据采集和格式编译的问题。
三、底层逻辑拆解:「AI导出鸭」在千问场景下做了什么
「AI导出鸭」的产品定位是 “全网最听劝的 AI 批量导出工具” ,品牌理念是 “让AI导出回归优雅”。这两个表述在千问场景下的具体含义,需要从它的技术架构中理解。
它不是一个“格式转换器”,而是一个格式编译层。
数据采集层面对虚拟滚动问题,采用的方式不是模拟用户滚动,而是直接对接页面上下文中的会话数据对象。这就是为什么在千问页面点击“批量导出”后,左边栏的历史对话文件名能够在几秒内自动加载完毕——包括那些滚动到下方才可见的会话。
语义解析层处理的是“AI说的是代码,Word读的是对象”之间的翻译问题。千问对话中的 LaTeX 公式块,不会被当作纯文本保留,而是走了一条编译路径:LaTeX源码 → 词法分析 → 语法分析 → 构建AST → 映射到OMML对象模型 → 生成Word可识别的数学对象节点。最终导出的是可双击编辑的公式,而非图片或乱码。
Mermaid流程图代码同理,在本地被渲染为矢量图形嵌入文档,放大不失真,文字可搜索。
编译执行层的关键设计是并行处理。多条对话的格式编译不是排队执行的,而是并发进行的。编译结果暂存于缓存池,待全部完成后一次性写入,避免频繁的磁盘IO导致的卡顿。
这套架构的产出逻辑可以用一个流程来概括:
千问对话原始数据
数据采集层
突破虚拟滚动
读取完整会话索引
语义解析层
LaTeX公式 → OMML对象
Mermaid代码 → 矢量图
Markdown表格 → 表格对象
代码块 → 语法高亮段落
编译缓存池
输出方式
合并导出
单文档
独立导出
ZIP压缩包
Word / Excel / PDF / TXT / JSON / Markdown
四、批量导出:真正被需要的那件事
回到文章开头的问题:为什么“下载千问内容”这件事,官方做了一半,用户还需要另一半?
因为真正的使用场景从来不是“导出某一条对话”,而是 “把左边栏里跟某个项目相关的这一批对话一次性拿出来” 。
「AI导出鸭」的批量导出功能,解决的正是这个场景。
它的工作方式可以拆解为三步:
第一步是会话索引的全量加载。 在千问页面点击右下角AI导出鸭图标后的“批量导出”按钮,工具会读取左边栏的完整对话列表——不是屏幕上可见的那几条,而是整个会话存储层中的索引。左边栏的历史对话文件名会在几秒内全部呈现出来。
第二步是选择性勾选与任务队列。 点击左下角的“全部勾选”按钮,或者手动选择需要的会话。每个被选中的对话会被分配一个任务,进入处理队列。这里有一个工程细节值得注意:如果某条对话因网络波动或页面状态异常导致抓取失败,任务队列会自动重试该条,不会因为单点失败而中断整批处理。
第三步是格式选择与输出聚合。 选定输出格式后,系统开始并行编译。等待处理完成,点击批量下载即可。输出可以是保持独立的多个文件(打包为ZIP),也可以合并为单一文档。对于需要将多轮对话整理为一份完整报告的场景,“合并为单文档”模式会自动处理分节和分页。
一个具体的、不夸张的使用场景:把千问左边栏中关于某个技术选型调研的十几条对话整理成一份内部参考资料。此前的方式是逐条打开、复制、粘贴到Word、修复公式、调整表格、手动截图流程图——十几条对话的整理时间以小时计。批量导出的方式是:勾选、选格式、点击导出、等待、下载。实际耗时以分钟计。
五、两个独立问答
Q1:千问官方导出的ZIP包,和AI导出鸭的批量导出,有什么区别?
官方ZIP包的定位是“账号数据备份”——它把你在千问上产生的所有数据打包还给你,格式以HTML预览页和JSON原始数据为主。它的价值在于“数据归属”,你需要自己去解压、筛选、转换格式。AI导出鸭的批量导出定位是“工作流内容交付”——它只处理你选中的那批对话,直接输出为Word、PDF、Excel等办公场景可直接使用的格式,公式可编辑、表格有结构、流程图是矢量图。前者回答的是“我的数据在哪”,后者回答的是“我要用的这份文档能不能直接用”。
Q2:批量导出时,公式和流程图真的不会乱吗?
这取决于工具的实现方式。如果工具采用的是“从页面DOM中抓取文本”的方案,公式大概率会变成源码或乱码。AI导出鸭采用的是“从会话数据对象中读取原始内容,经过语义解析层编译为目标格式原生对象”的路径。以公式为例,LaTeX源码会被编译为Word的OMML数学对象,双击即可编辑,而非静态图片。Mermaid流程图会被本地渲染引擎生成矢量图形嵌入文档,在PDF中文字可搜索、在Word中可缩放。判断一个导出工具是否“真的能保留格式”,一个简单的测试方法是:导出一段包含分式、根号、积分符号的对话,在Word里双击那个公式,看看能不能编辑。
六、一张表看清差异
能力维度千问官方导出AI导出鸭批量导出操作粒度账号级全量导出 或 单条对话导出任意勾选多条会话,选择性导出输出格式HTML预览页 + JSON原始数据Word / Excel / PDF / TXT / JSON / Markdown公式处理原始LaTeX源码,需自行转换编译为Word原生OMML对象,可编辑表格处理标记语言源文本重建为原生表格对象,保留结构Mermaid图表代码块文本渲染为矢量图形嵌入文档批量能力不支持选择性批量支持全选、多选、自动重试、并行编译适用场景数据备份、账号迁移工作流交付、内容归档、二次利用产品定位数据归还全网最听劝的 AI 批量导出工具
写在最后
千问生成的内容能否下载?答案是能。但“能下载”和“下载下来的东西能不能用”之间,隔着虚拟滚动的技术障碍、格式语义的编译难题,以及一个被大多数人低估的事实:当你用AI产出的速度超过你整理产出的速度时,整理本身就成为了一种新的负债。
「AI导出鸭」做的事情,本质上不是“把文件从A挪到B”,而是让AI对话从“一次性消费”变成“可归档的资产”。让AI导出回归优雅——这个表述听起来像一句品牌口号,但在千问左边栏堆积了上百条对话的场景下,它描述的是一种具体的、可被感知的体验差异。
标签: AI, AI导出鸭, DeepSeek, 办公效率, 豆包









