









 深耕数码、汽车兴趣领域


8
7
雷神水冷迷你AI工作站评测:低温开跑120B本地大模型
2026-09-16 17:53:24
0点赞
1收藏
0评论
在AI热潮推动下,近几年高性能迷你主机火得不行,但市面上大多数产品还在用风冷硬扛,小机箱一压满负载往往就降频、就吵。雷神这台水冷迷你AI工作站想解决的正好是这件事——它用上AMD锐龙AI Max+ 395算力领先的平台,再把一套定制水冷塞进正方体里,雷神目标很明确:让这台小机器能长时间满血跑AI,而不是过一会儿就降频。实际表现如何,一起看看。
 P1325640.JPG
本地部署大模型这两年突然成了很多人的刚需,原因无它,云端方案要传数据,不仅有隐私顾虑更关乎数据拥有主权,网络一抖就卡,会有延迟,token费还不停烧钱。把模型放在自己桌上跑,数据不出门,成本一次付清,响应还稳。但AI推理和训练往往是7×24小时连轴转,跟机房里的服务器差不多,对散热和稳定性是实打实的考验,这正是雷神水冷迷你AI工作站用上水冷的根本原因。
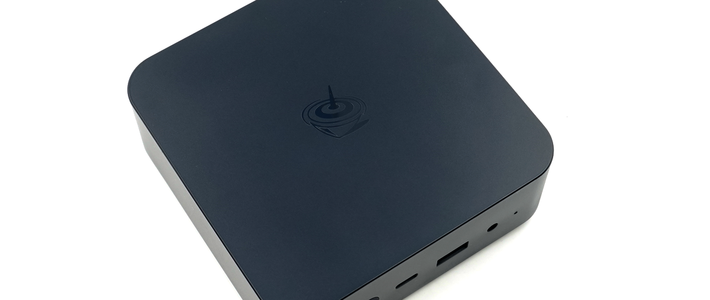
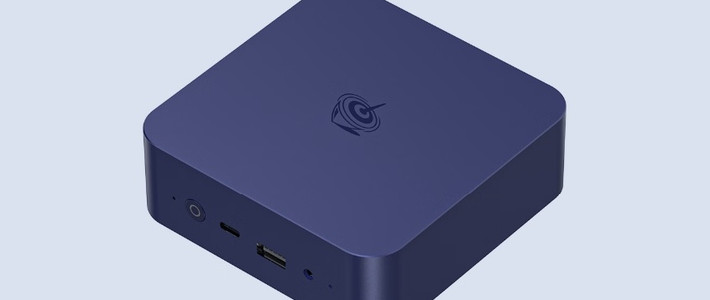
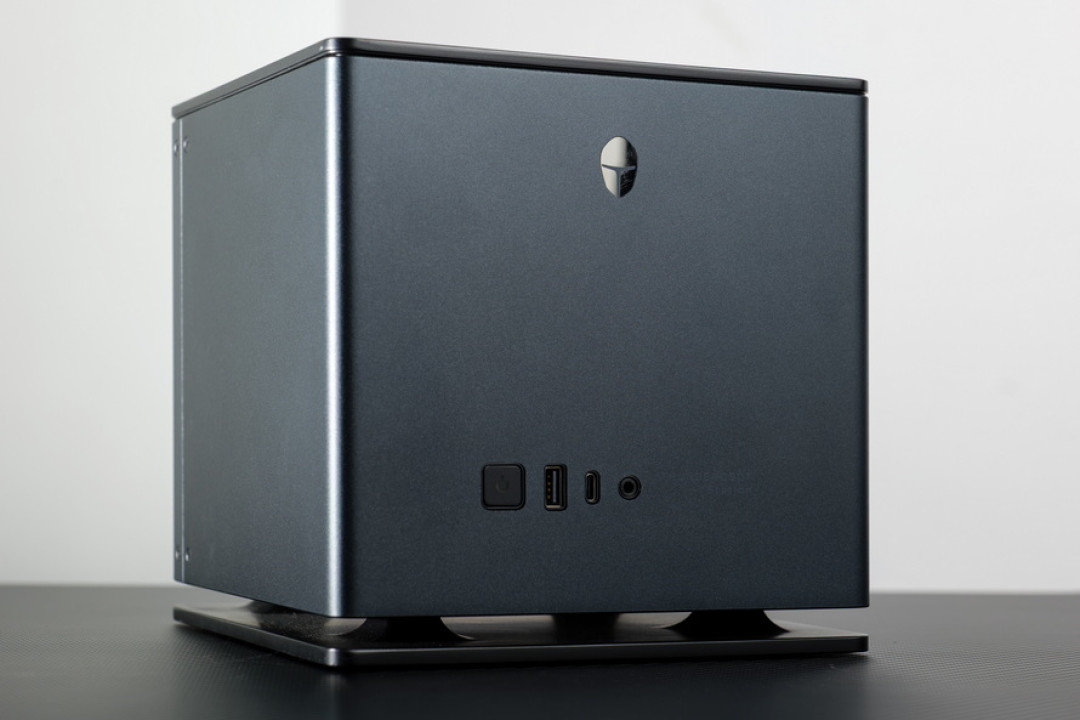
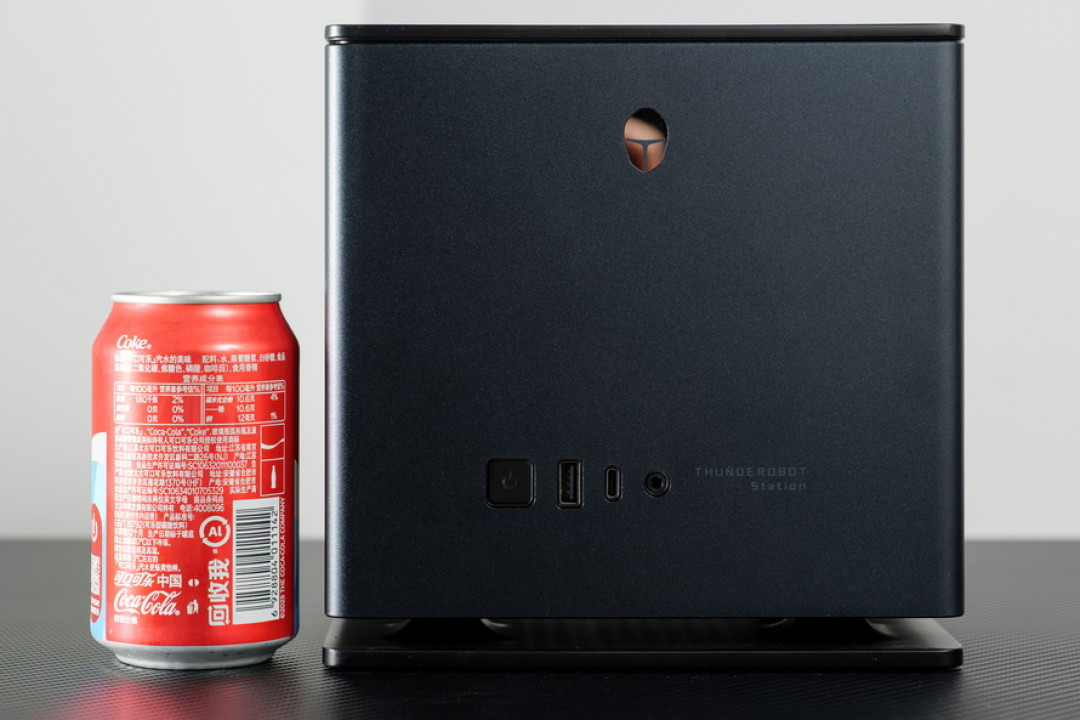
既然用上水冷,我们一起来看看雷神水冷迷你AI工作站的外观,它是个方方正正的立方体,长宽高都是199mm,体积差不多7.9升,放桌上不占地儿,也没整那些跑马灯和花哨装饰,跟大多数桌搭都能搭上。
 P1325668.JPG
外壳、顶盖、底座全铝,表面处理得细,四边做了圆角过渡,摸上去不刮手。机身稳定性方面,6.5kg摆在那,想随手挪一下得两只手抱,放桌上根本不用担心碰倒。
 P1325638.JPG
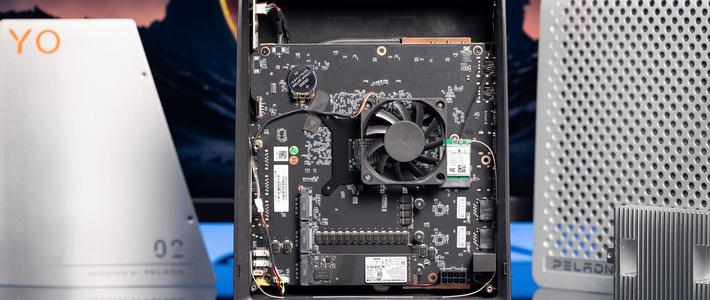
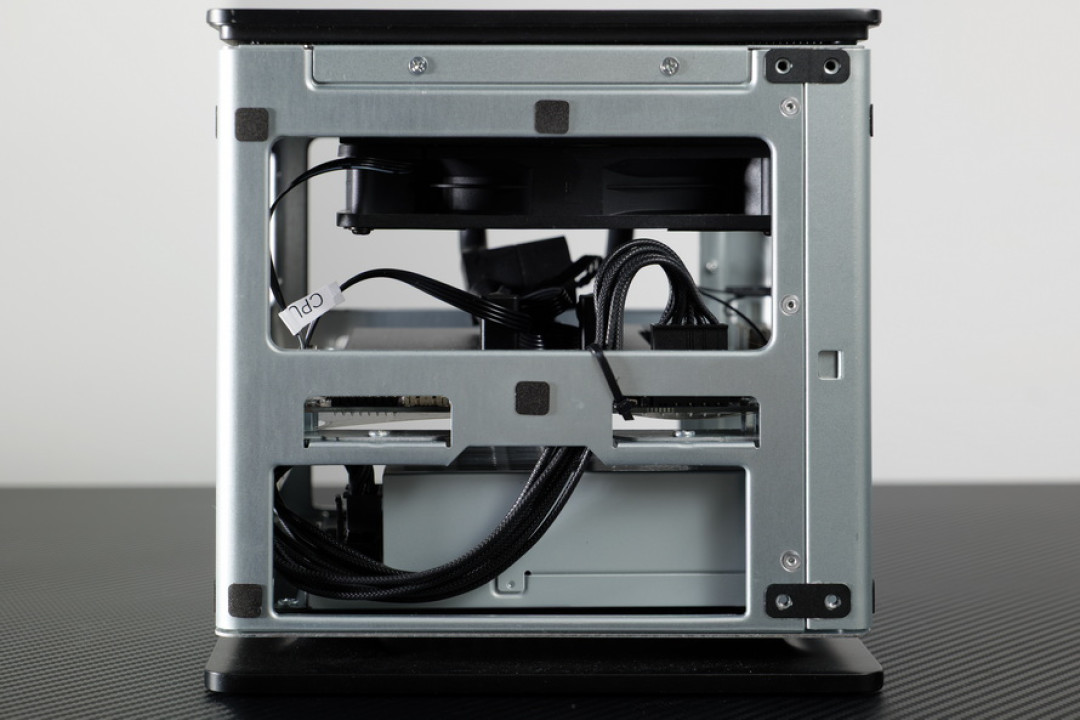
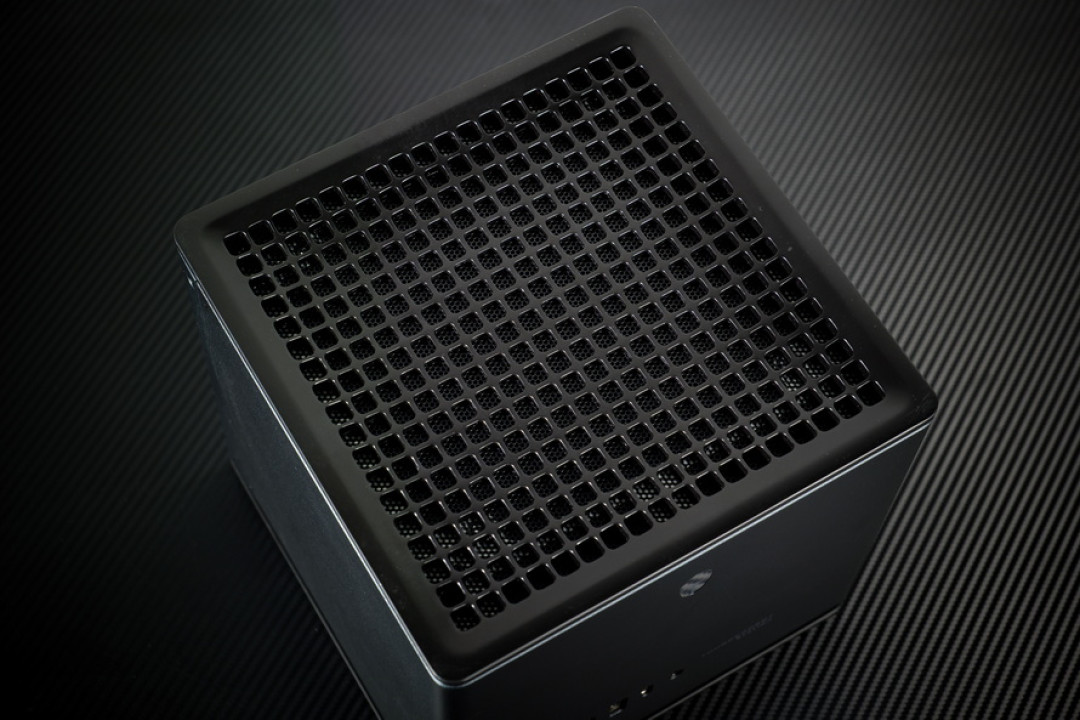
雷神水冷迷你AI工作站拆解很简单,拧下左右两侧一共8颗外露的六角螺丝,再取下前后两块铝合金挡板,就能看到机器内部了。机器顶部是一整面网状的圆角矩形散热开口,金属顶盖底下是密密麻麻的蜂窝状散热网,水冷系统就藏在机身内部上方。底座用了悬浮设计,视觉上更显轻薄,也更有科技味。
 P1325662.JPG
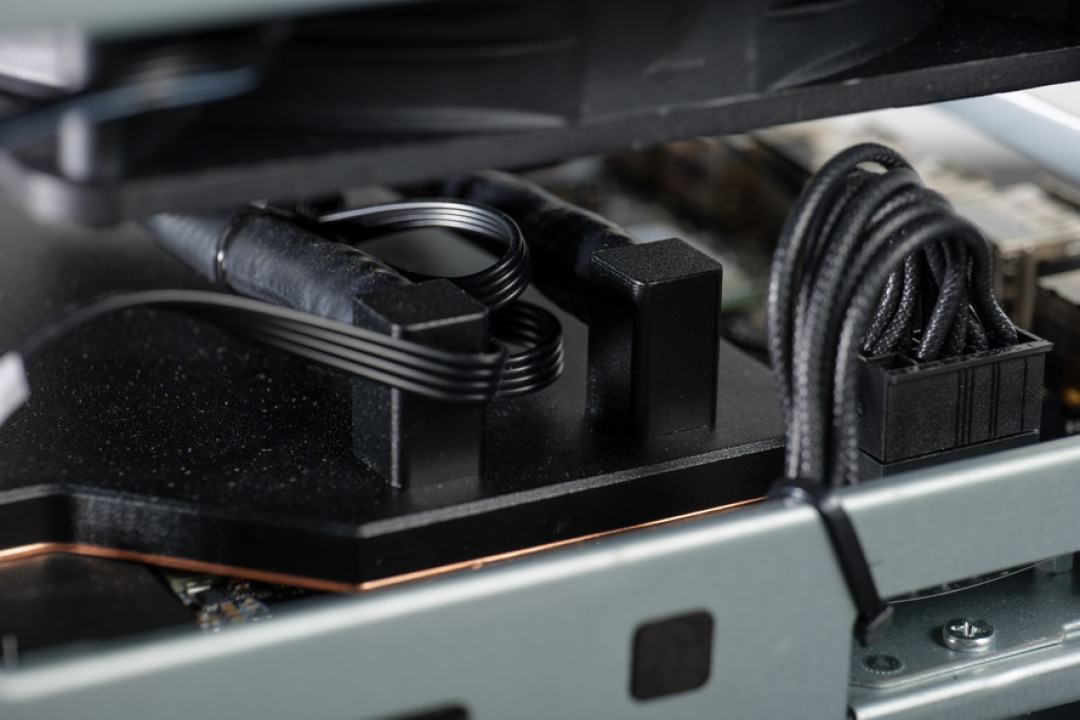
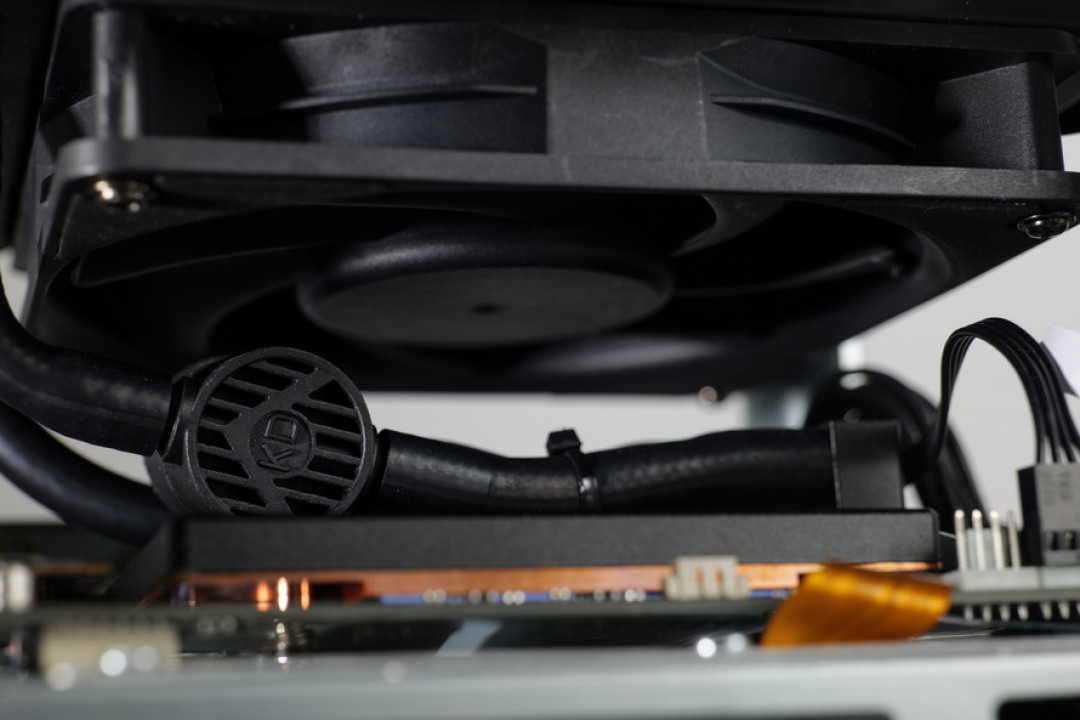
雷神水冷迷你AI工作站水冷系统由两部分组成,一是安装在CPU之上的“散热岛”,官方叫法是“岛式全覆盖”,这是块12000平方毫米的纯铜多岛冷板,当中冷热转换面积做到了1960平方厘米。散热岛通过热管把热量传递到顶部的散热冷排当中,最后通过大口径双滚珠轴承风扇把热量吹走。
 P1325658.JPG
 P1325657.JPG
 P1325645.JPG
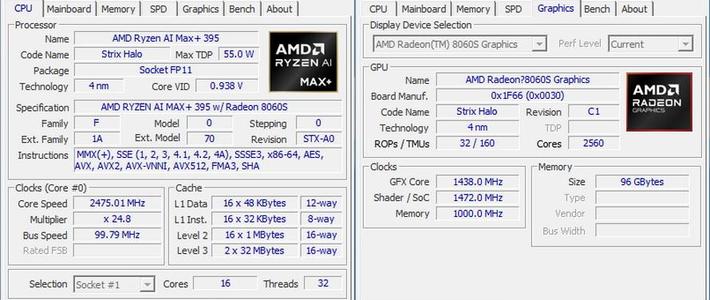
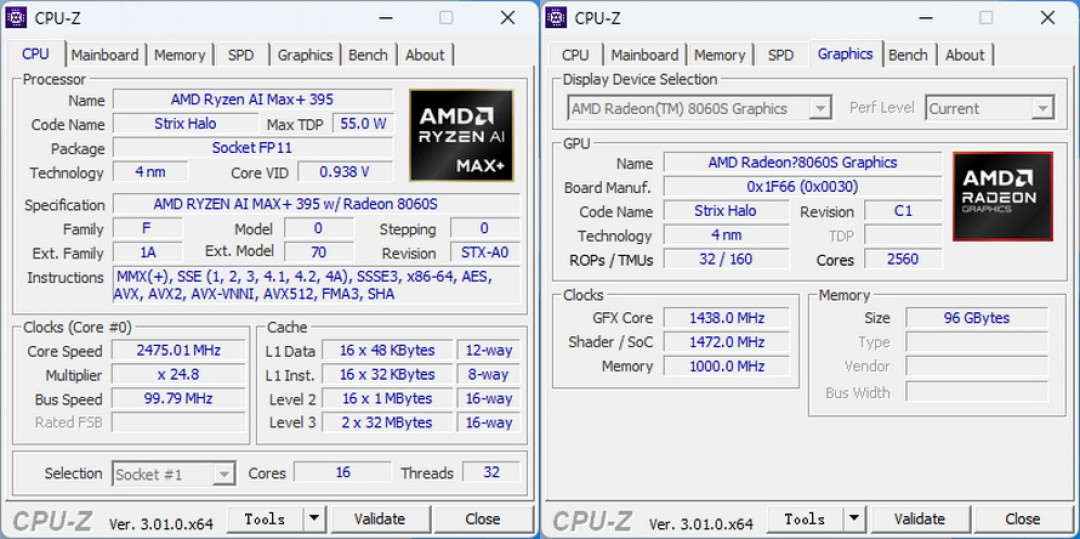
按照官方说法,雷神水冷迷你AI工作站能跑出176W的瞬时峰值,并能长烤不掉速,而且在高负载跑AI下,核心温度大概76℃,比风冷方案温度更低。不过雷神水冷迷你AI工作站还得是AMD锐龙AI Max+ 395处理器,它基于Zen 5架构,Strix Halo平台,内置16核32线程,加速频率5.1GHz,80MB缓存,NPU算力50TOPS。更关键的是内存——板载128GB LPDDR5X 8000四通道统一内存,靠AMD的可变显存技术,最高能从这128GB里划出96GB当专用显存用。
 U.JPG
桌面独立显卡显存最多32GB,这台小机器光能划出来当显存用的就有96GB,整整三倍。96GB显存能干什么?最常用的Q4_K_M量化下,200B以下的模型随便装,Qwen3.8 flash next、GPT-OSS-120B这种都能整包塞进去跑。100B以下级别的MoE模型更宽裕更高效,跑Q4_K_M还剩不少余量,上下文能开到260K,本地做AI数据集、文档检索都够。
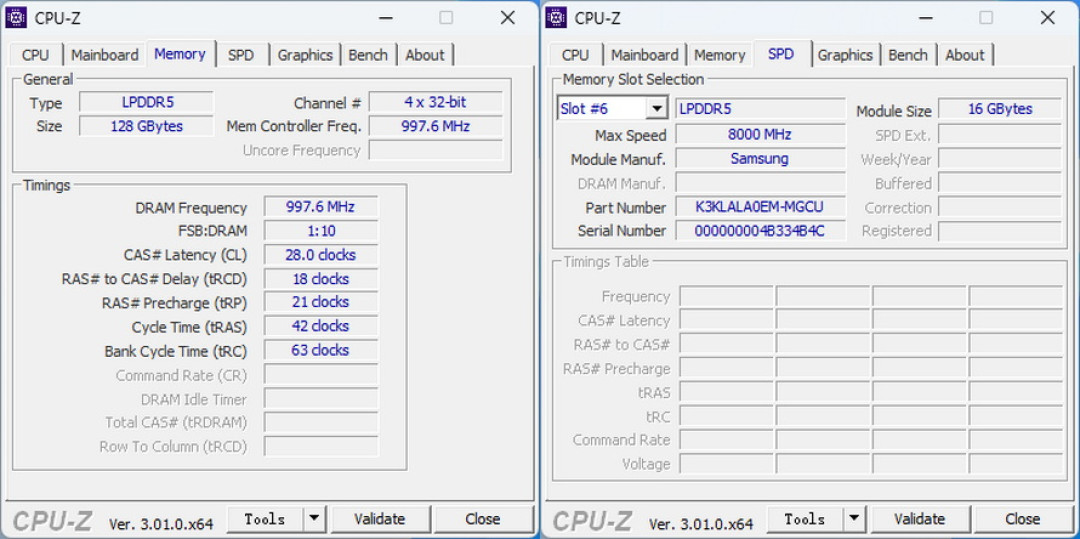 dram.JPG
换成INT8 / Q8_0量化精度,100B以下参数的大模型加上上下文缓存也能完整高效跑下来,本地能部署的模型尺寸又上了一个台阶。
图形方面是Radeon 8060S集显,RDNA 3.5架构、40个计算单元、频率2900MHz。很多人一听集显就觉得不行,其实它和桌面独显是同一个架构源头,驱动、图形接口都通用,日常修图剪片、轻度3D没问题,想玩游戏也顶得上,显示输出和视频编解码全归它管,不用额外插独显。
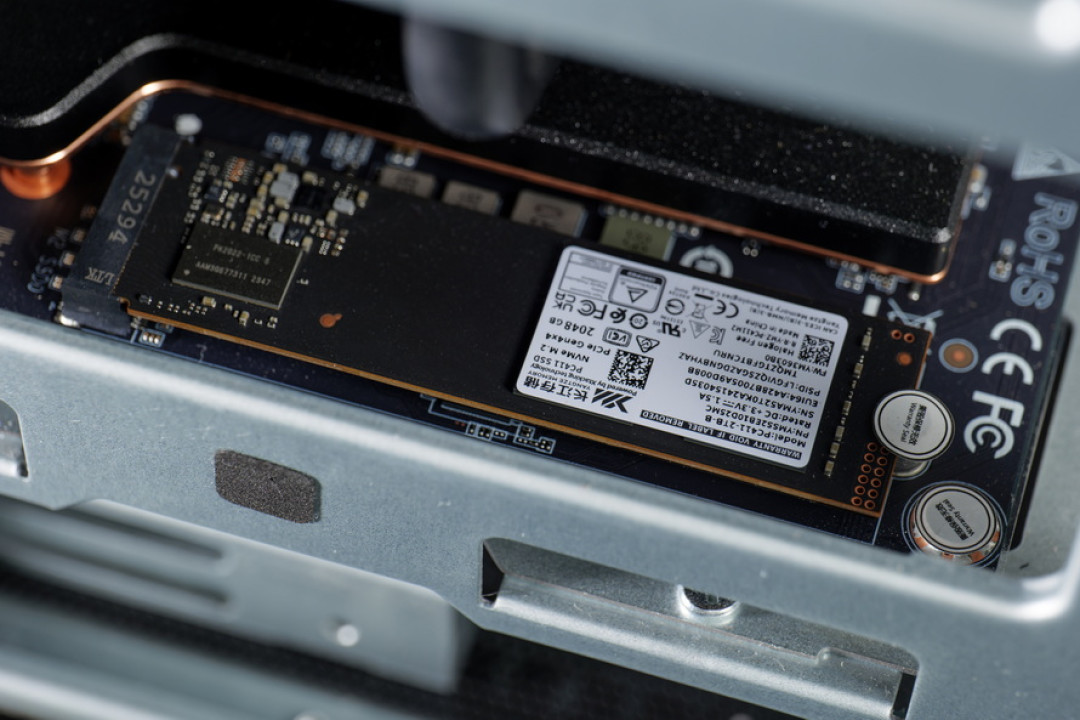
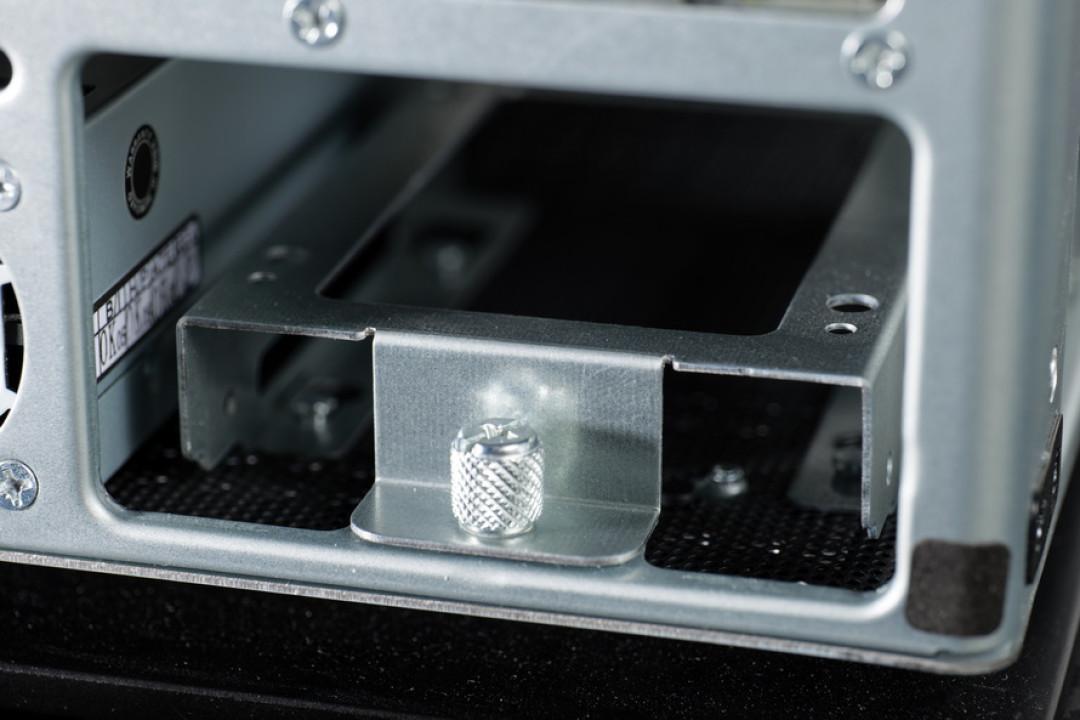
存储给的是2TB PCIe 4.0固态,机器里还留着2.5英寸硬盘仓和第二个M.2插槽,最多能塞三块高速固态,后面想加盘也方便。
 P1325653.JPG
 P1325659.JPG
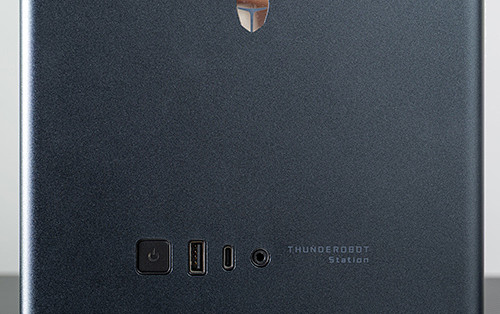
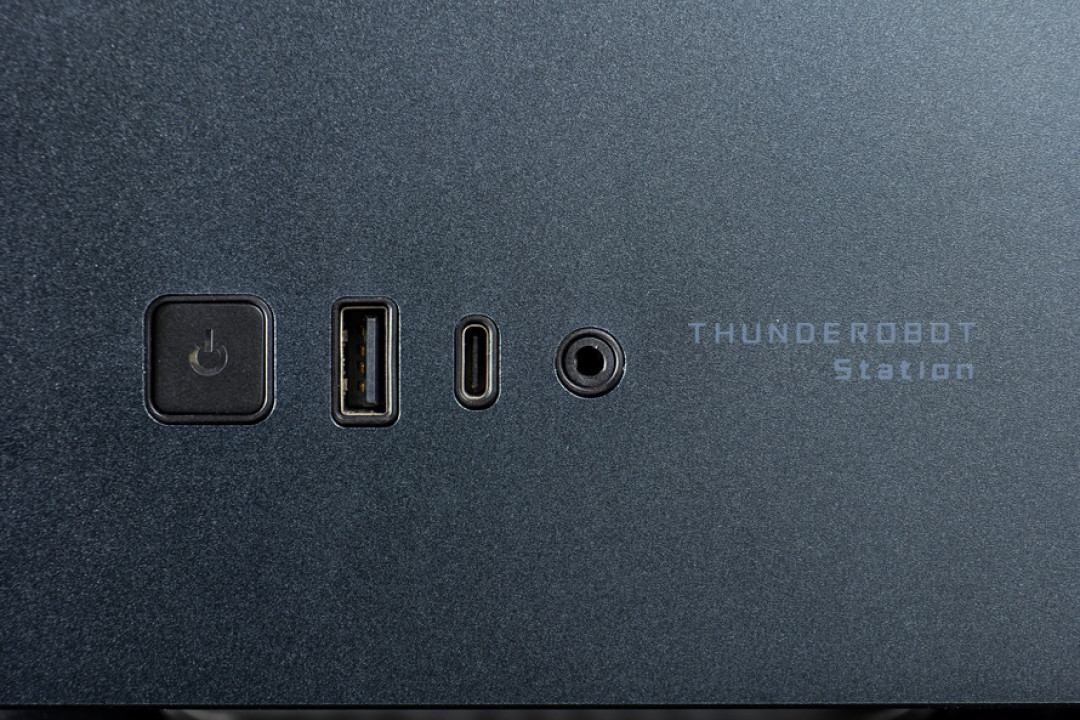
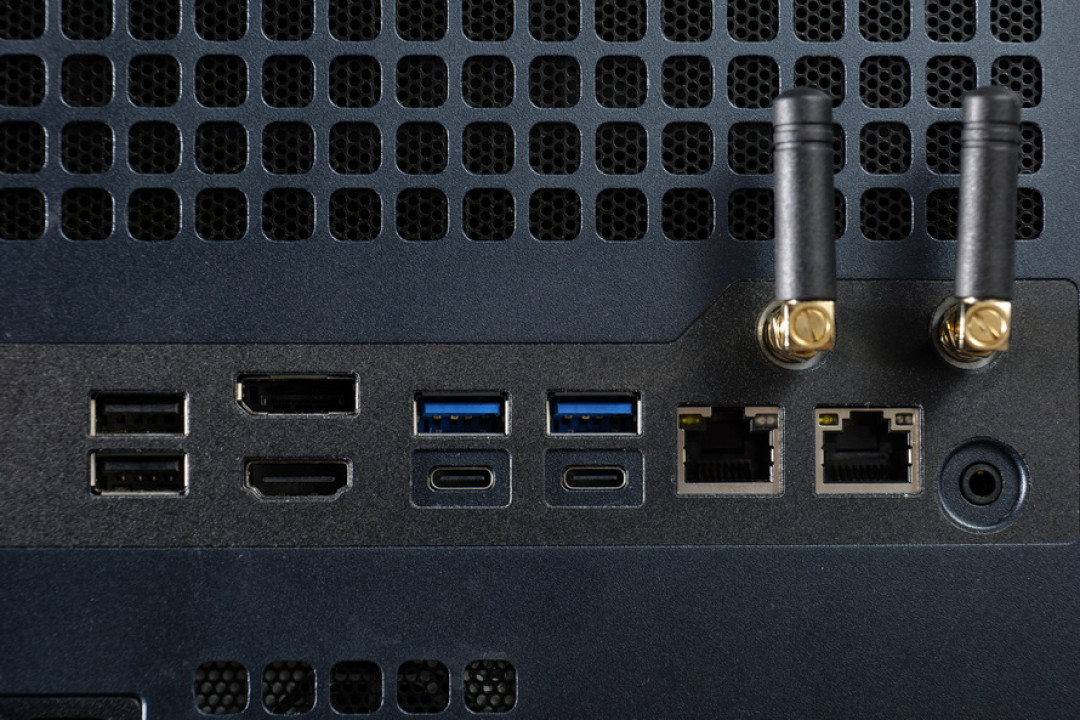
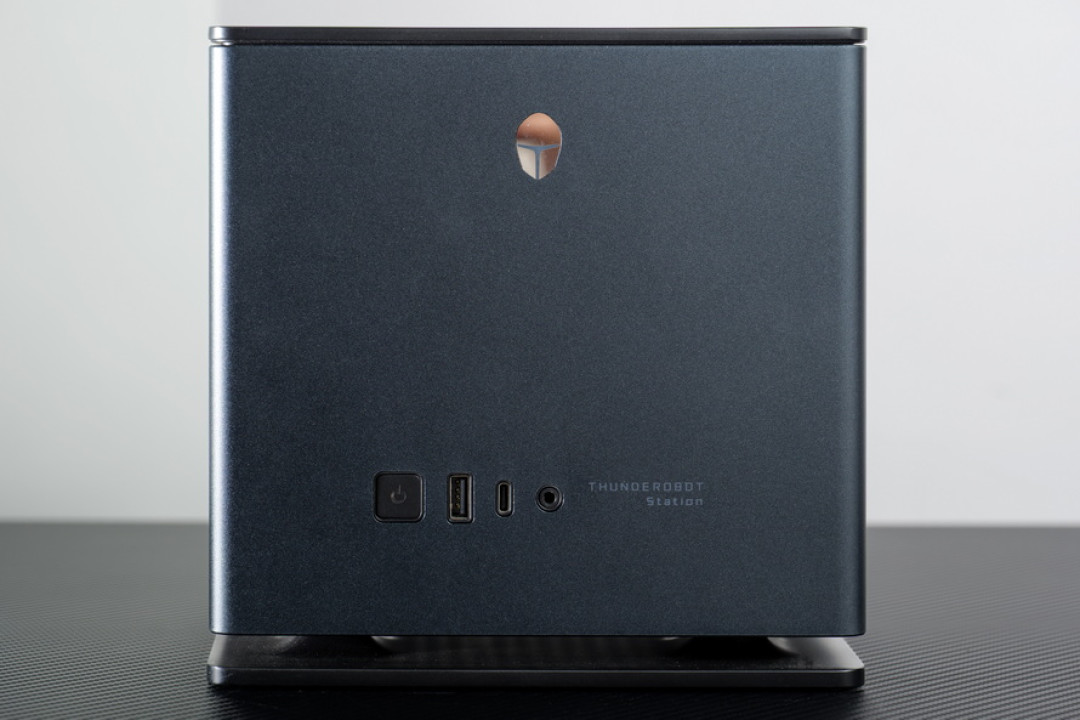
在接口方面,雷神水冷迷你AI工作站也给得很足,前面板从左到右是方形电源键、USB2.0 Type-A、USB3.2 Type-C和3.5mm音频口。背部接口面板更密:2个USB2.0、DP 1.4、HDMI 2.1、2个USB-A 3.2、2个USB4、2.5G+10G双网口、3.5mm音频,还有2.5G、10G Wi-Fi天线接口和AC电源接口。双网口对组网和小服务器接入很友好,USB4也能外接高速设备和给设备供电。
 P1325635.JPG
 P1325650.JPG
电源上,这台小机器也有惊喜,内置了400W ATX12VO白金级电源,不用在桌上拖一个外置电源适配器,桌面上就一根电源线,干净。
性能测试
在硬件层面,雷神水冷迷你AI工作站在同类产品绝对是站在一流水平了,那实际性能表现呢,跑起来看看。
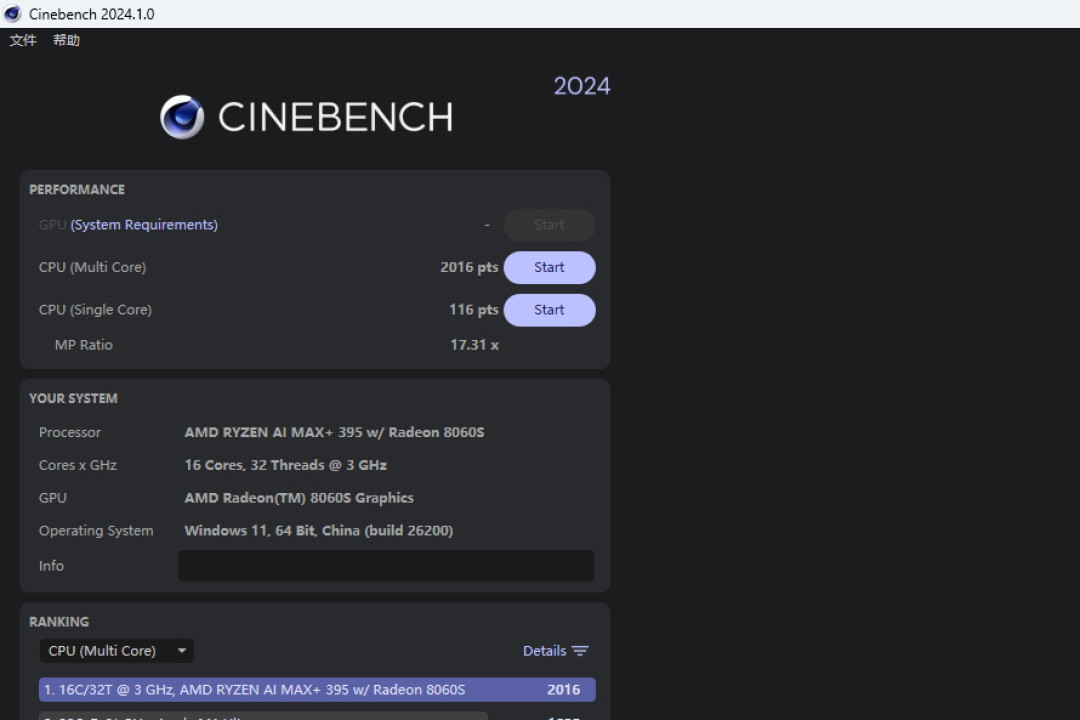
先看CPU,CineBench 2024是Maxon推出的CPU性能基准测试工具,基于Cinema 4D渲染引擎,用来衡量处理器的渲染计算能力。拿它测锐龙AI Max+ 395,单核多核各跑一遍,就想看这台小机器在稳定功耗下,渲染性能还剩多少。实测多核分数2016 pts,单核116 pts,MP Ratio达到17.31x,无论单核还是多核成绩得分都很高。
 R24.jpg
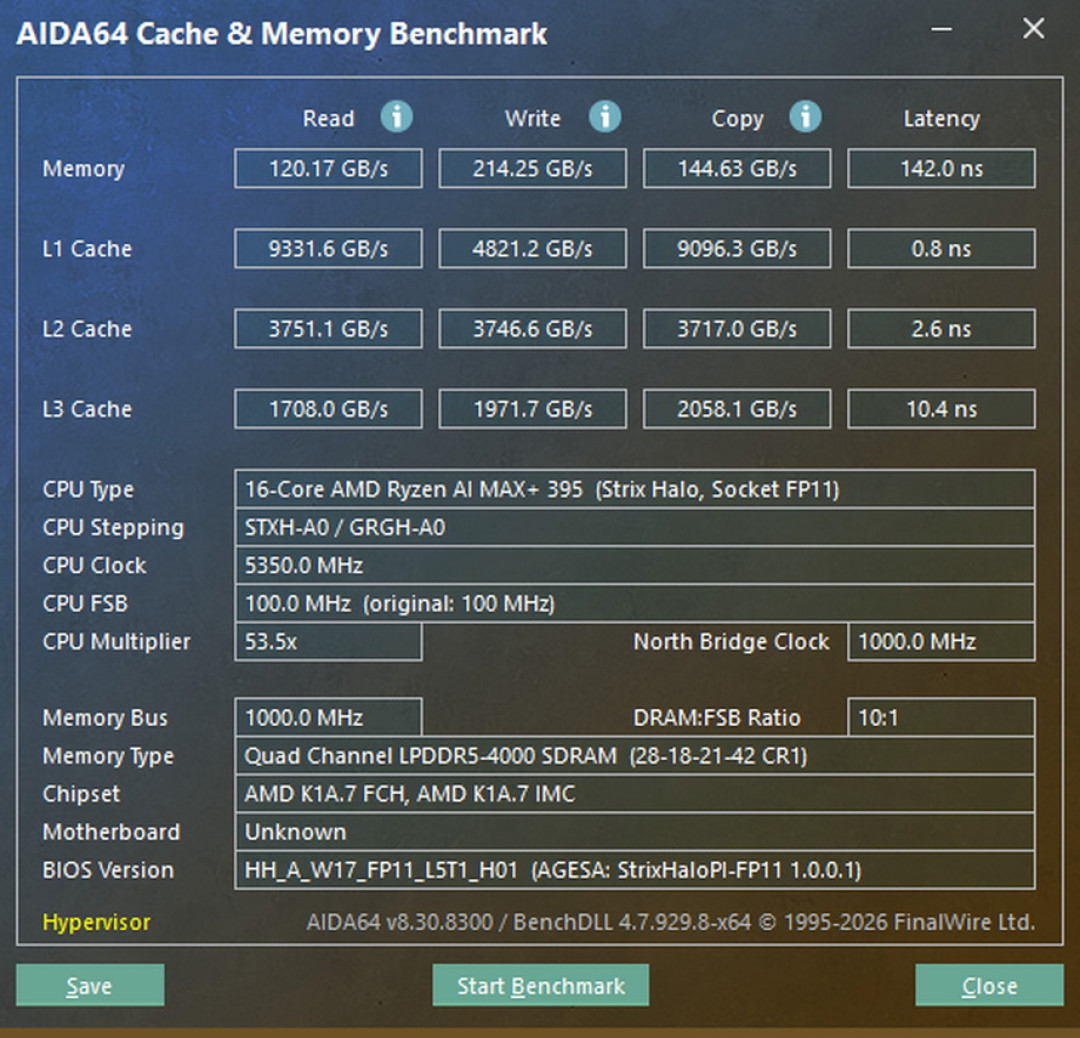
内存这块用AIDA64的Cache & Memory Benchmark来测。AIDA64是老牌的硬件检测与基准测试套件,这个子项专门测量内存子系统的读写、复制带宽和访问延迟。Strix Halo这种CPU和GPU共用一块内存的架构,最吃的就是这条带宽。实测读取120.17GB/s、写入214.25GB/s、复制144.63GB/s,延迟142.0ns——写入比读取还高,是四通道LPDDR5X分配了大内存后的正常表现。
 屏幕截图 2026-08-28 160513.JPG
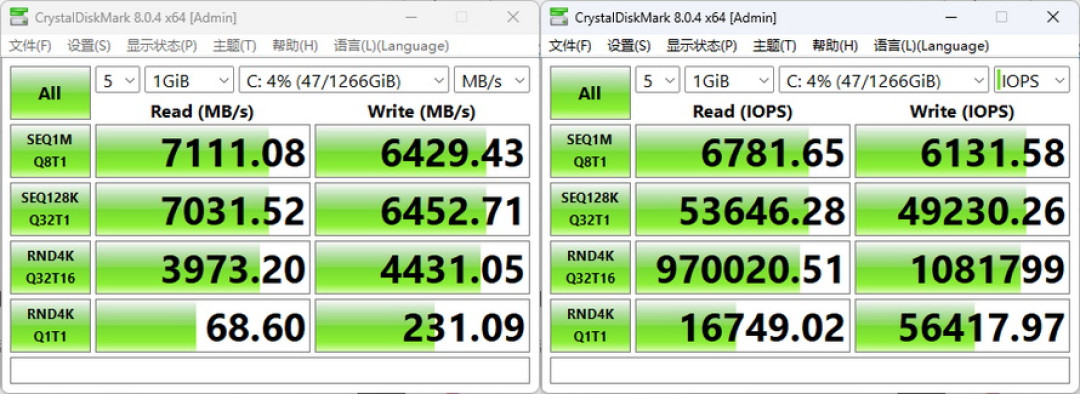
雷神水冷迷你AI工作站使用的长江存储PCIe4.0的SSD,实测顺序读取7111.08MB/s、顺序写入6429.43MB/s;4K随机读取970020 IOPS,4K随机写入1081799 IOPS。
 CDM.JPG
看过CPU、内存、SSD几大件的性能后,我们看看其AI性能表现。
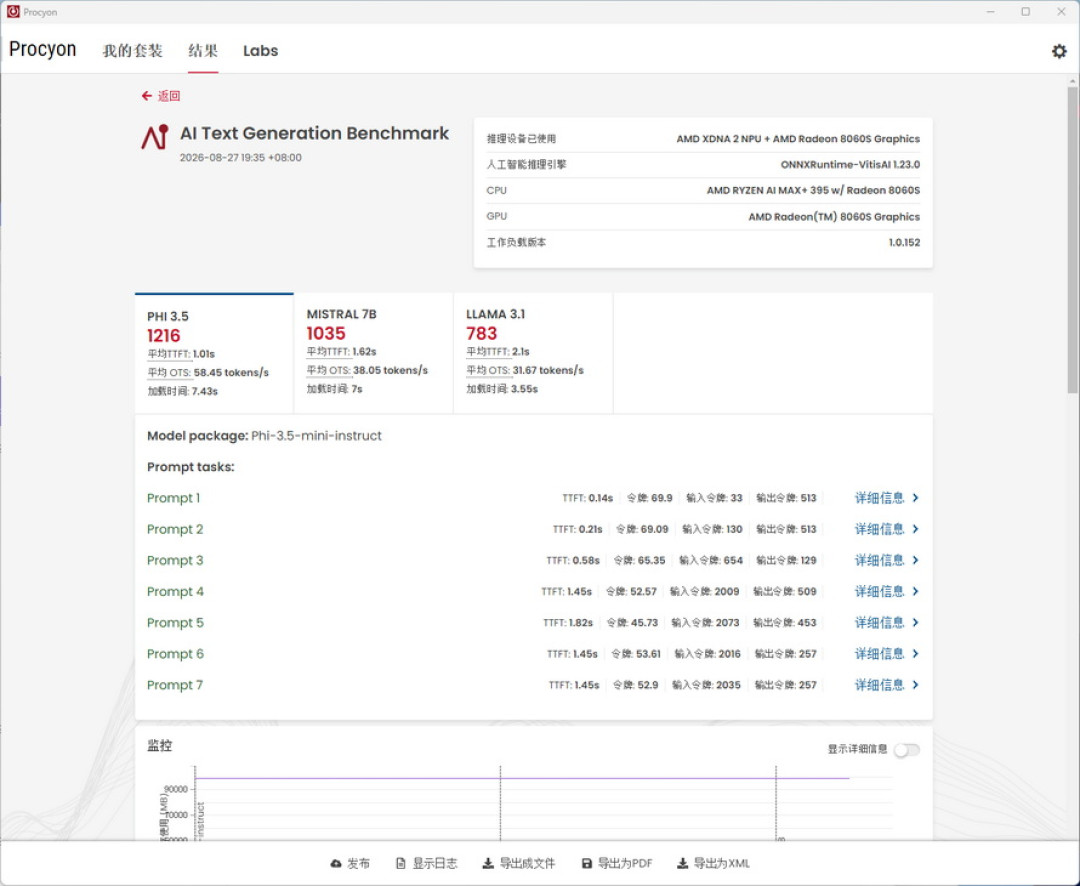
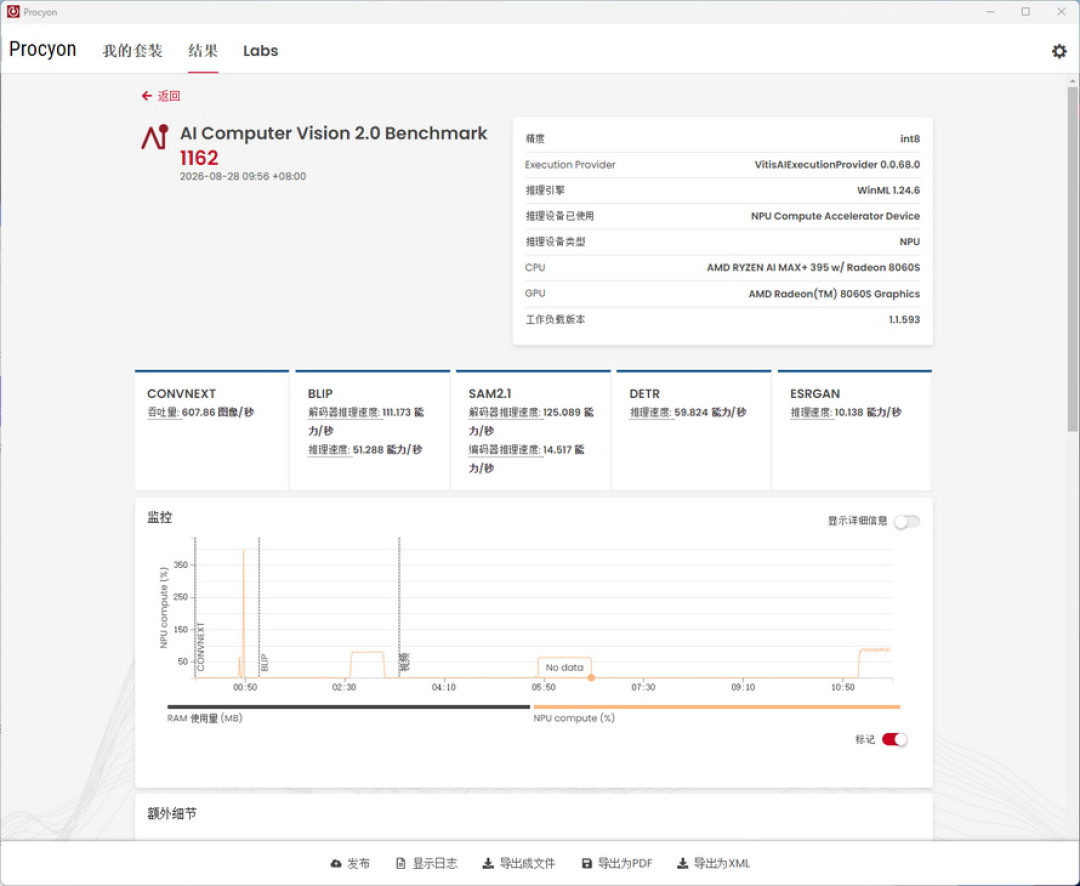
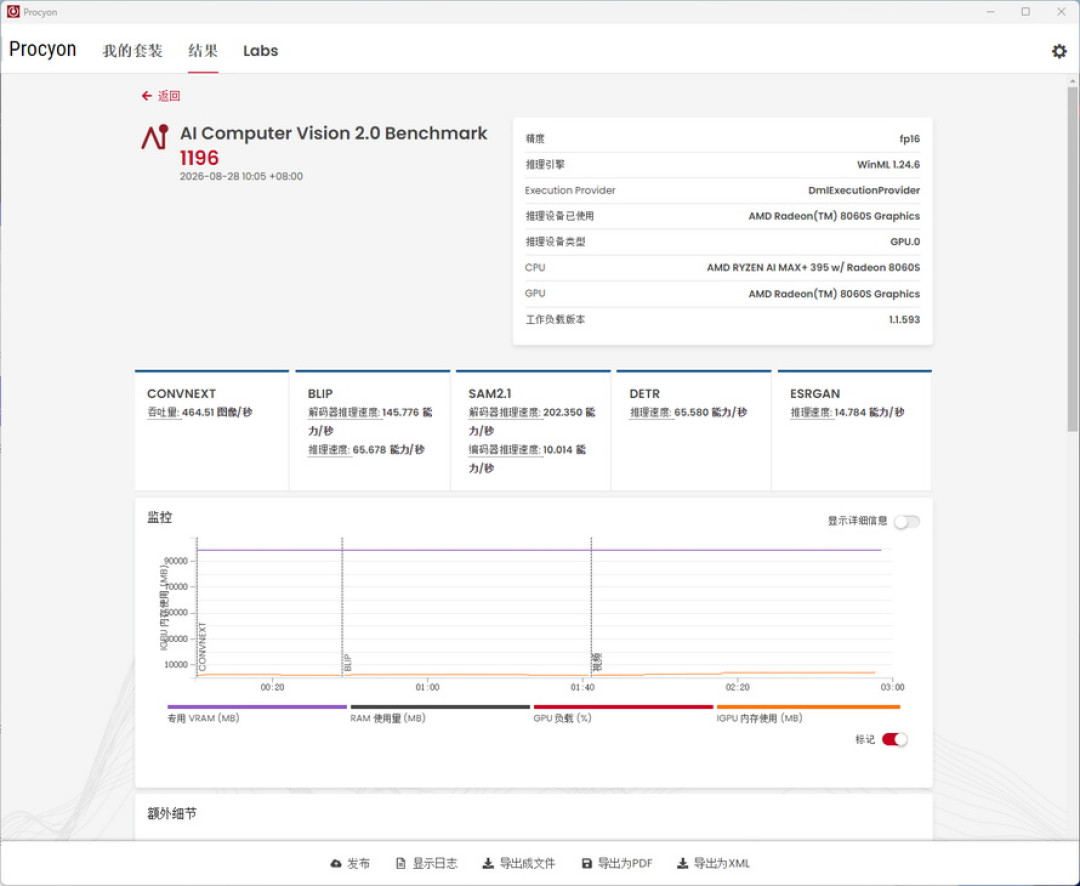
测试软件是UL Procyon,UL Solutions(原Futuremark)出的专业套件,AI Inference系列直接调本地模型跑推理,文本生成、图像分类、超分这些任务的吞吐和延迟都能测。参数表写得再漂亮,不如让它跑一遍。
这次选了AI Text Generation和AI Computer Vision 2.0两项。Text Generation这里拿了Phi 3.5、Mistral 7B、Llama 3.1三个常见模型跑,总分1216、1035、783,折算成生成速度是58.45、38.05、31.67 tokens/s。
 屏幕截图 2026-08-28 094413.JPG
7B-8B这个量级的模型,本地跑起来和云端小模型对话没多大差别。70B的也能塞进去,但那个速度适合后台慢慢处理。
Computer Vision 2.0则分别跑了int8精度NPU和fp16精度GPU两种后端,得分1162和1196,说明NPU在量化视觉任务里已经和GPU浮点性能相当接近,做本地图像识别、超分、分割都有实用价值。
 屏幕截图 2026-08-28 100209.JPG
 屏幕截图 2026-08-28 102133.JPG
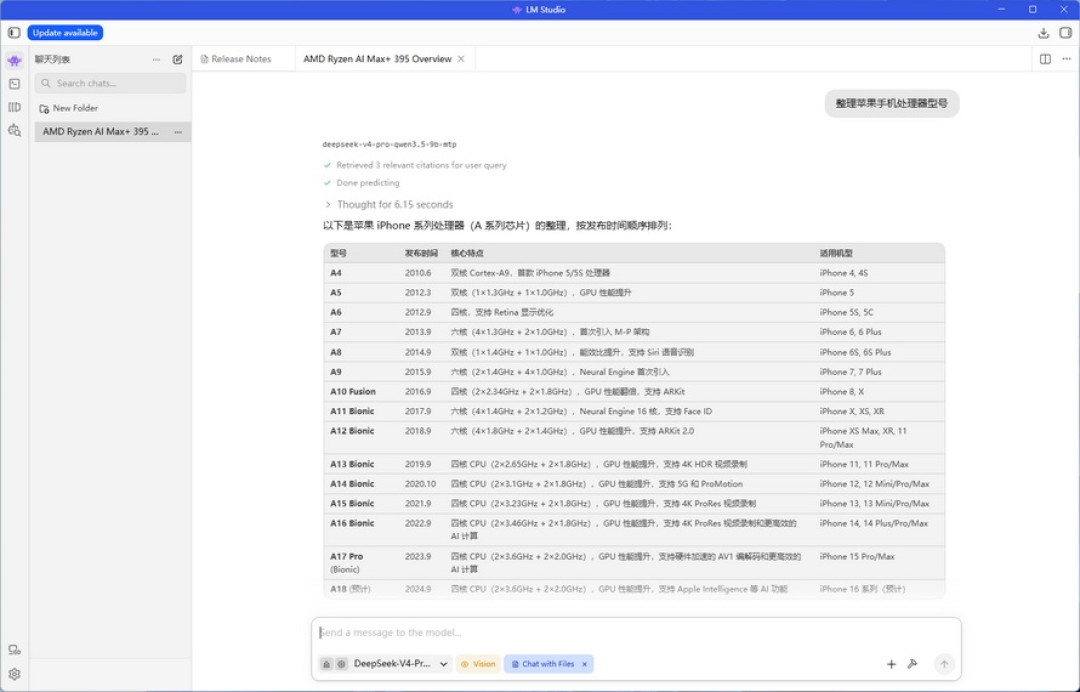
AI当然不能停留在跑分之上,我们还采用LM Studio部署了本地大模型进行测试。
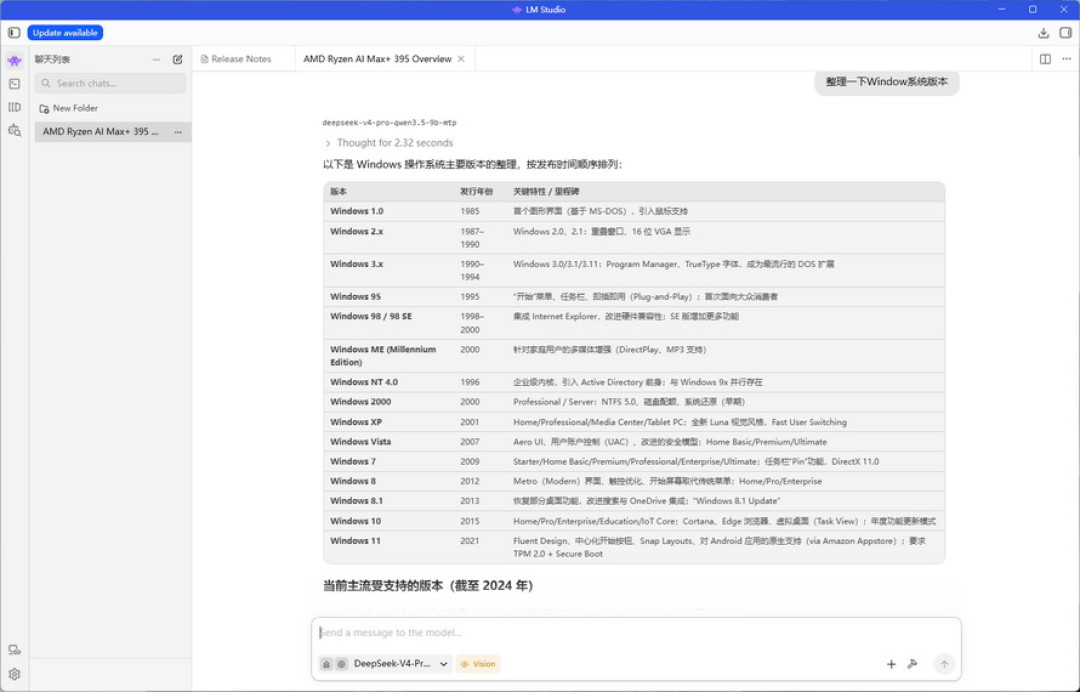
我装了两档模型。轻量的是DeepSeek v4 Pro Qwen3.5 9B MTP,日常问题随手就能问:让它整理苹果手机的处理器型号,6.15秒答完;整理Windows系统版本号,2.32秒就答上来了。
 屏幕截图 2026-08-31 113033.JPG屏幕截图 2026-08-31 113033.JPG
 屏幕截图 2026-08-31 110923.JPG
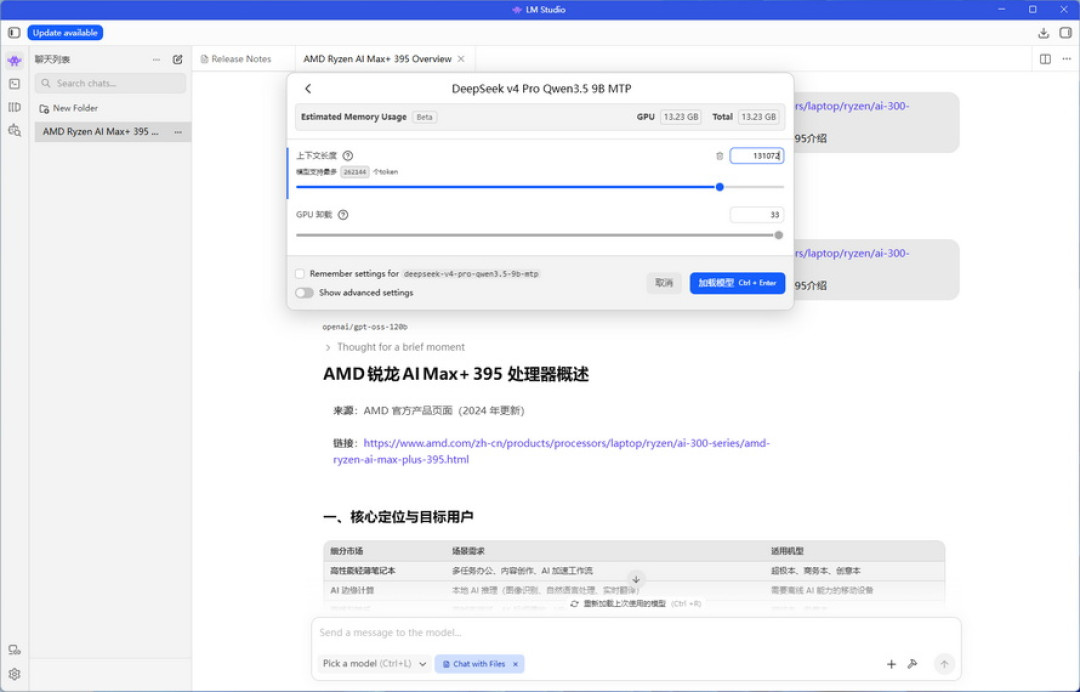
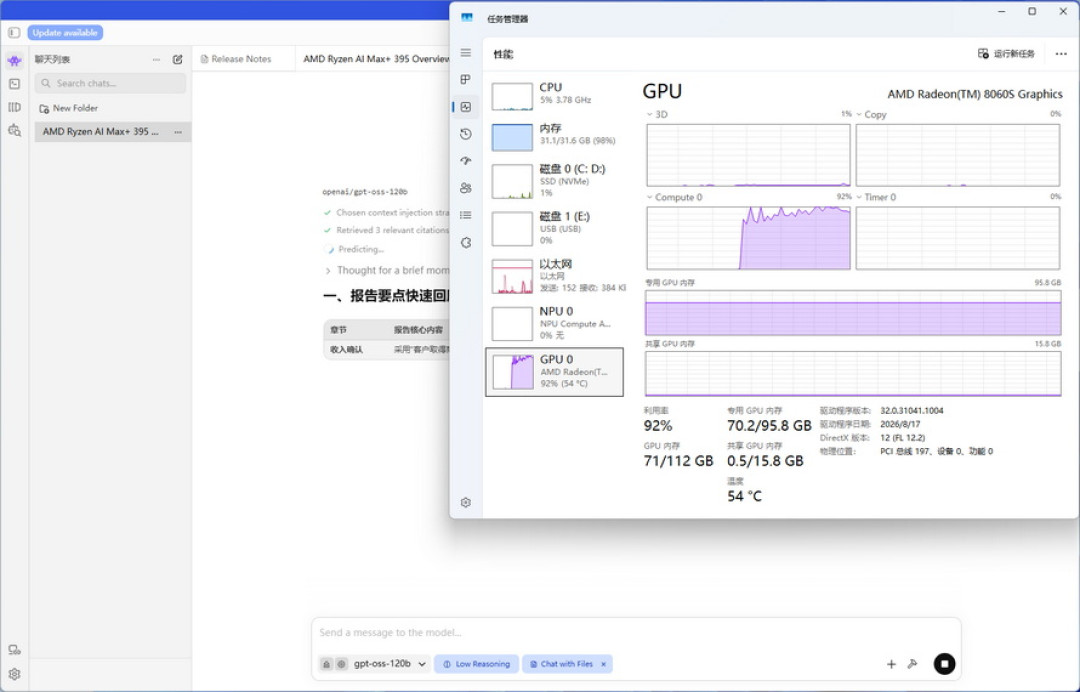
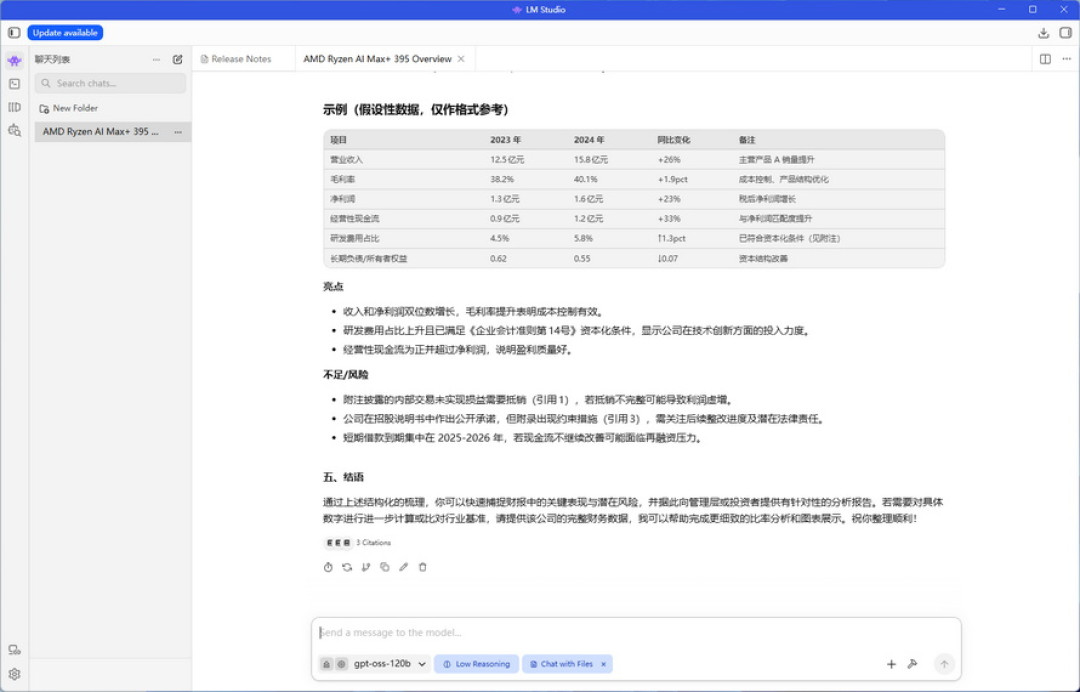
想体验128GB内存的价值,还得靠GPT-OSS-120B这种大模型。我丢了一份218页的Word版2026年半年度报告进去,上下文开到131072,跑起来内存吃掉31.1GB,集成显卡那边又占70.2GB,加起来过100GB,结论照样很快给出来。这活要是换常规的消费级独立显卡,甚至低一点的计算卡,显存根本装不下。
 屏幕截图 2026-08-31 144443.JPG
 屏幕截图 2026-08-31 113908.JPG
 屏幕截图 2026-08-31 112257.JPG
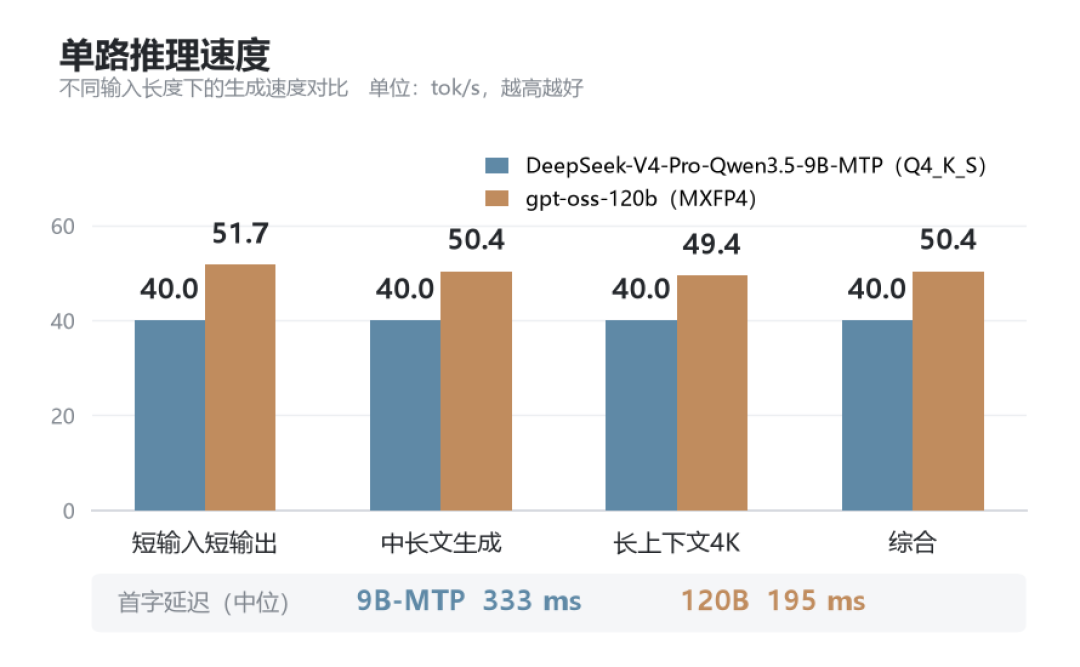
除了对话之外,我们还测试了主机在LM Studio下的算力。单路推理下,DeepSeek-V4-Pro-Qwen3.5-9B-MTP在短输入、中长文生成、4K长上下文三种场景全都是40.0 tok/s,稳得像一条直线,首字延迟中位333ms。GPT-OSS-120B表现更好:短输入51.7 tok/s、中长文50.4 tok/s、4K长上下文49.4 tok/s,综合50.4 tok/s,首字延迟中位只有195ms。
 lmstudio-single.png
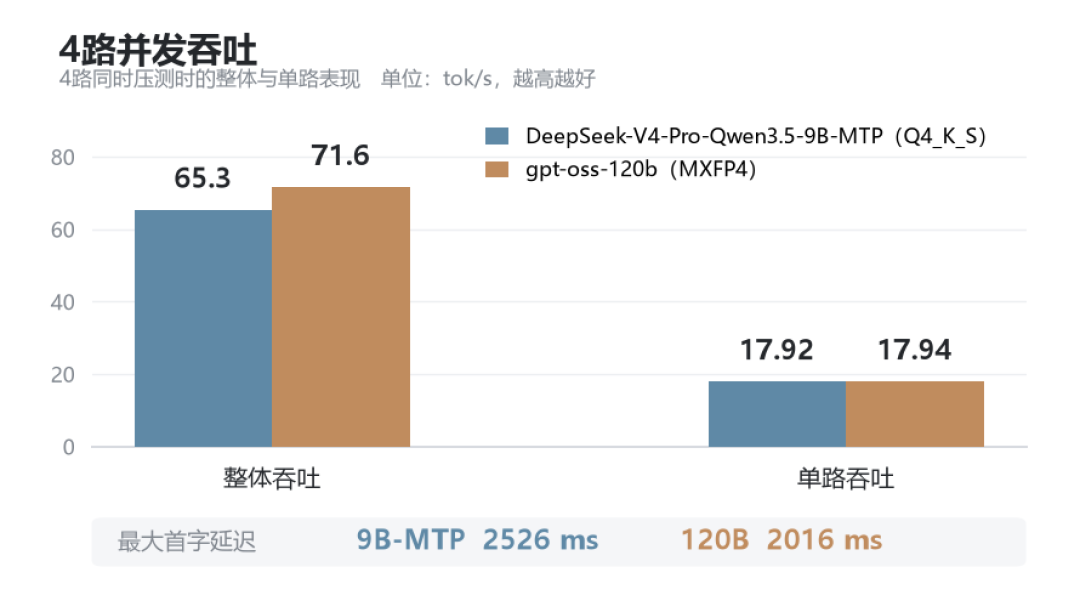
并发也没放过,4路同时压:DeepSeek-V4-Pro-Qwen3.5-9B-MTP模型整体吞吐65.33 tok/s,摊到每路17.92 tok/s,最大首字延迟2526ms;GPT-OSS-120B整体吞吐反而冲到71.60 tok/s,单路17.94 tok/s,最大首字延迟2016ms比9B还低。多人同时用,120B不但没被拖垮,单路体验跟9B基本一个水平,这机器的算力和内存带宽是真的富裕。
 lmstudio-concurrent.png
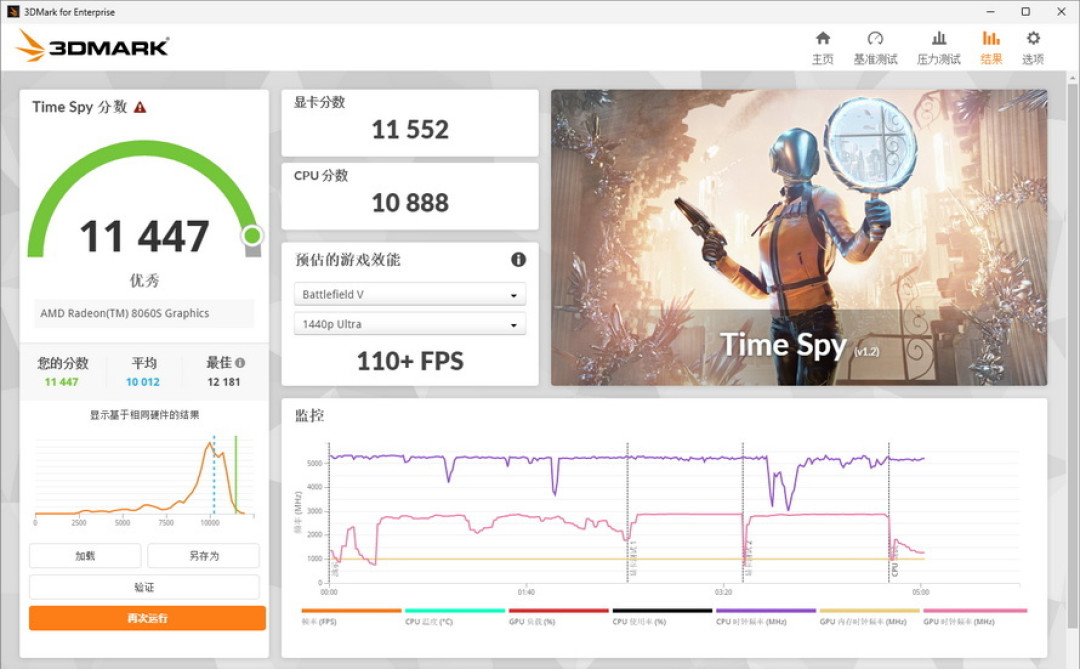
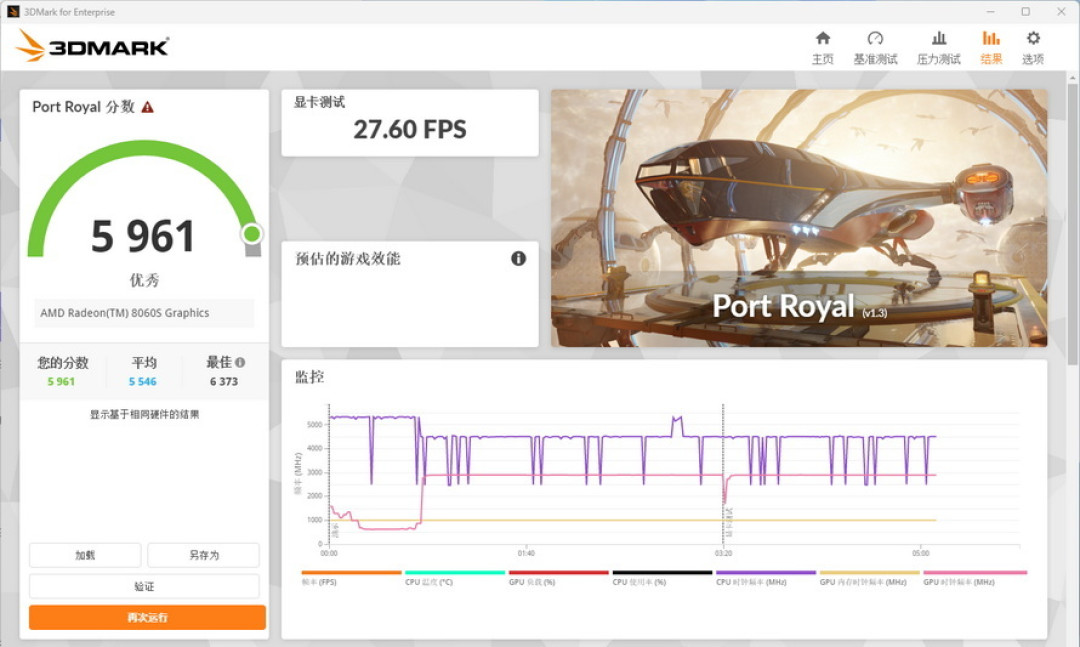
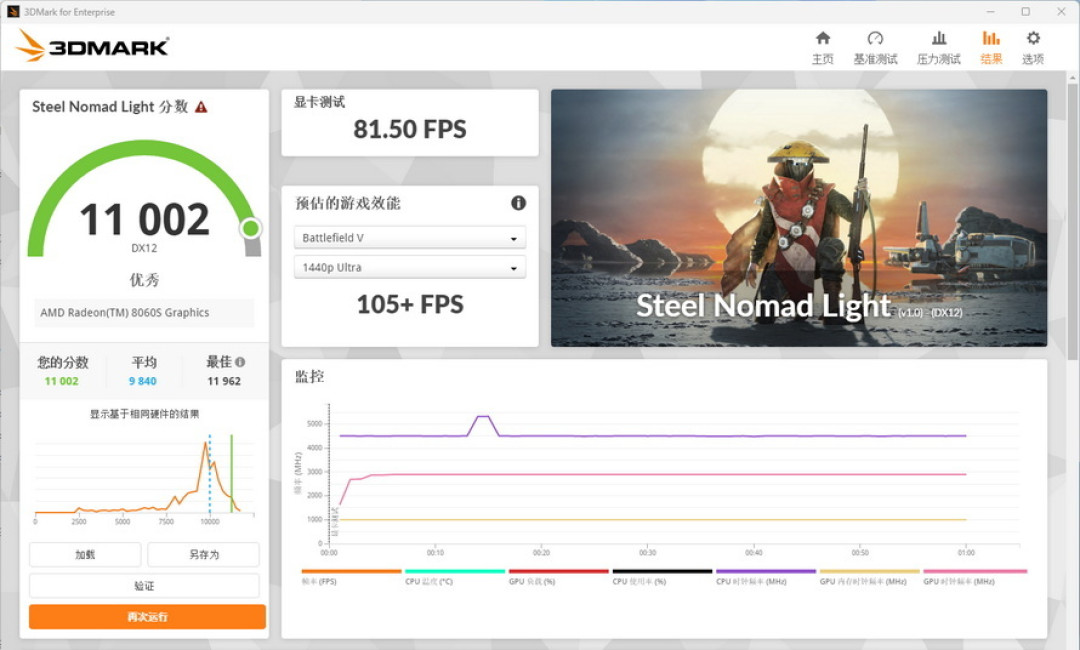
雷神水冷迷你AI工作站的价值当然不止是人工智能应用,游戏、日常办公它也是能胜任的。先来一个大家熟悉的3DMark摸底,跑了Time Spy、Port Royal、Steel Nomad Light三项。Time Spy总分11447,显卡分11552、CPU分10888,预估2K Ultra画质下《战地V》能到110+ FPS;Port Royal光追专项5961分,显卡测试27.60FPS,说明Radeon 8060S应对光追压力还是比较吃力;Steel Nomad Light这种跨平台轻负载测试拿到11002分、81.50FPS,接近集显能稳定输出的上限。
 屏幕截图 2026-08-27 130348.JPG
 屏幕截图 2026-08-27 133108.JPG
 屏幕截图 2026-08-27 113404.JPG
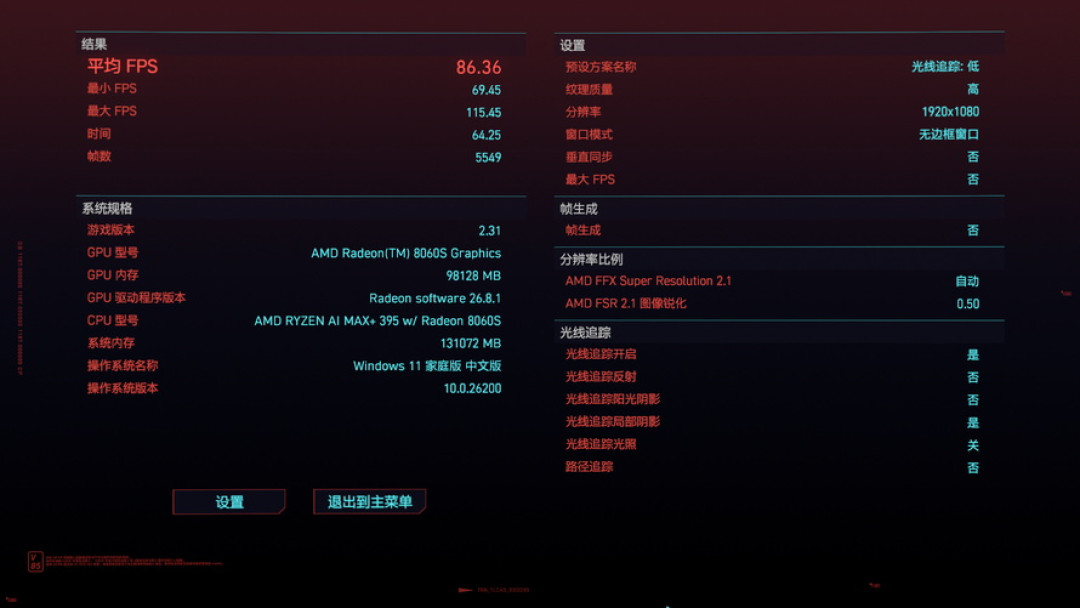
游戏实测选了3A和网游各一款。先看《赛博朋克2077》,1080P、光追低、纹理高、FSR 2.1自动、关帧生成,平均86.36FPS,最低69.45FPS、最高115.45FPS。集显能在这套设定下跑八十多帧,已经非常流畅。
 屏幕截图 2026-08-27 150551.JPG
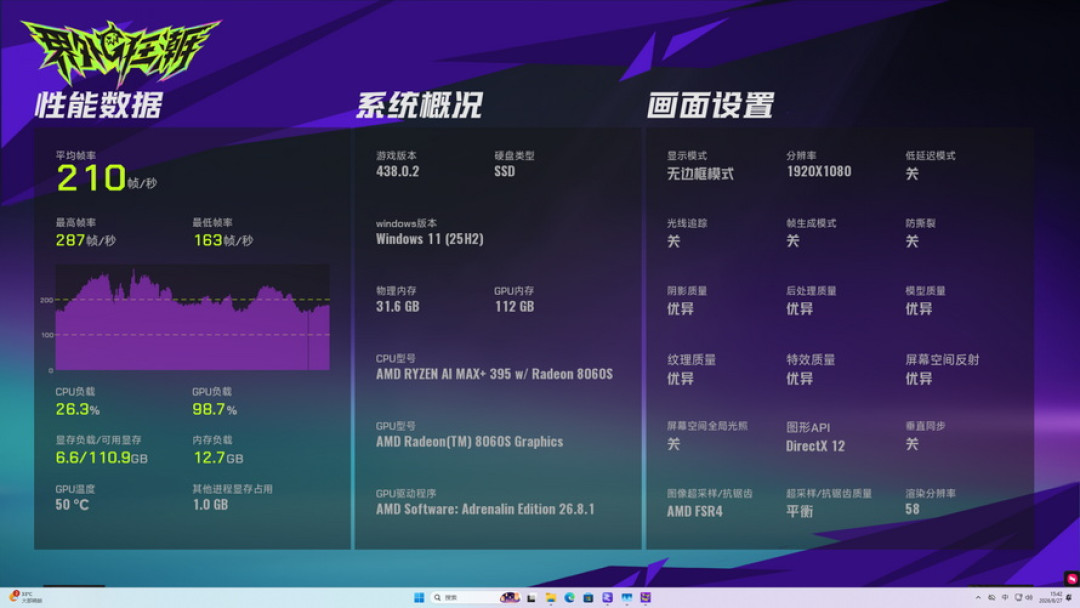
再看《界外狂潮》,1080P无边框、画质“优异”、FSR4平衡、渲染分辨率58、关光追、关帧生成,平均直接到210FPS,最高287FPS、最低163FPS。网游吃帧率,这成绩对玩家来说绰绰有余。
 屏幕截图 2026-08-27 154241.JPG
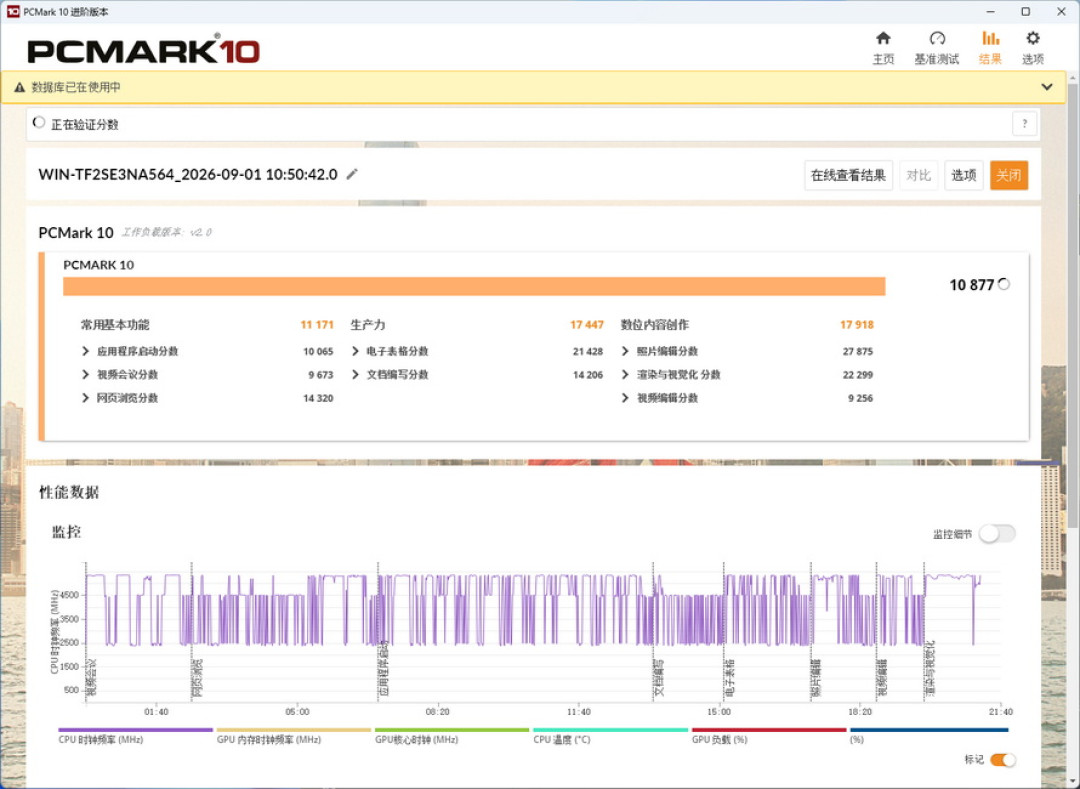
接着看整机日常办公和生产力表现,用PCMark 10来看。PCMark 10也是UL Solutions的基准,模拟网页浏览、视频会议、文档表格、图片视频编辑这些日常任务,看一台机器在真实生产力场景下到底什么水平。
在PCMARK 10中,雷神水冷迷你AI工作站是总分10877。常用基本功能11171——应用程序启动10065、视频会议9673、网页浏览14320,开浏览器、写文档、开会都顺手。生产力17447——电子表格21428、文档编写14206,Office那套活儿很能打。数位内容创作17918——照片编辑27875、渲染与视觉22299,PS修图、轻度3D都能顶;视频编辑9256,日常Vlog剪辑够用。这些才是桌上工作站天天要干的活儿。
 屏幕截图 2026-09-01 111258.JPG
最后我们看看这台迷你主机烤机下温度、噪音表现。
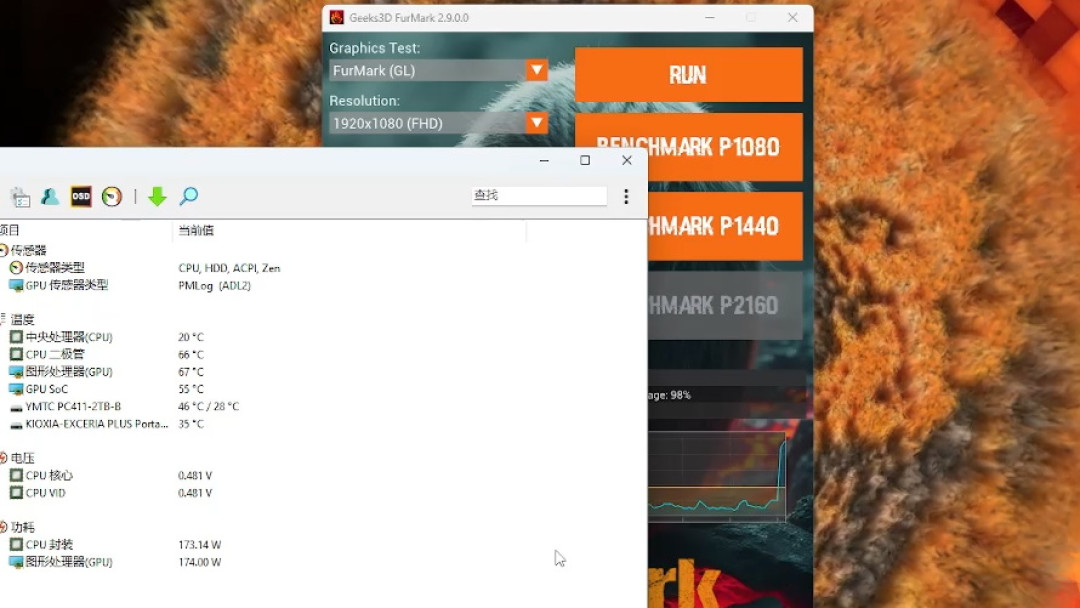
FurMark单烤的时候,CPU封装瞬时功耗冲到173.14W,GPU能到174.00W,都过了170W。
 furmark.jpg
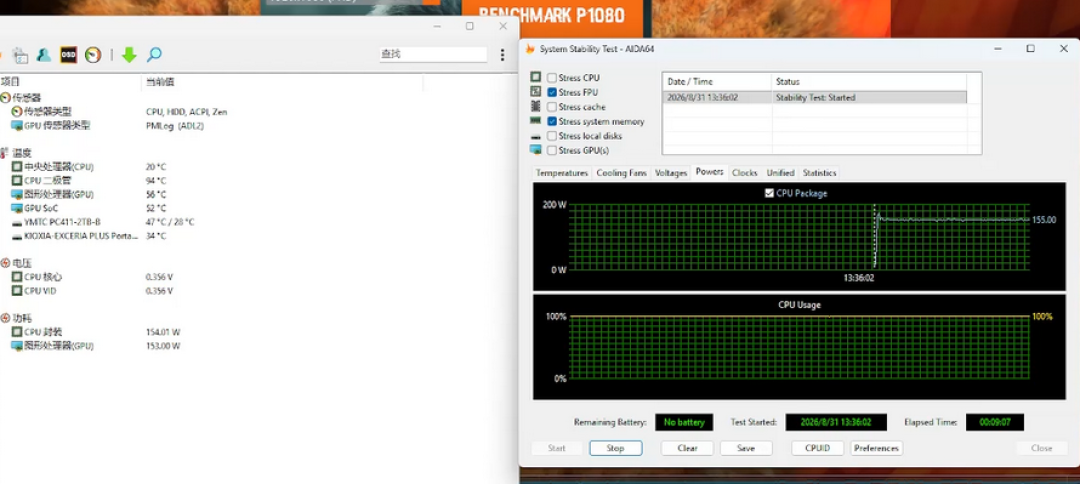
FurMark和AIDA64一起双烤,头9分钟功耗一直顶在154W,之后降到134W稳住。能在极限负载下坚持这么久不掉速,水冷这套确实压得住。这里要说明的是,AMD使用STAPM Limit/PPT Limit来管理其持续和短时功耗。在烤机开始时处于PPT Limit的fPPT阶段,此时锐龙AI Max + 395的功耗为174W,短时峰值得以确保处理器发挥最强性能。随后进入PPT Limit的sPPT阶段,此时功耗为154W,对于特定的复杂任务也能提供充分的保障。最后进入STAPM Limit 134W的稳定状态。
 dual.png
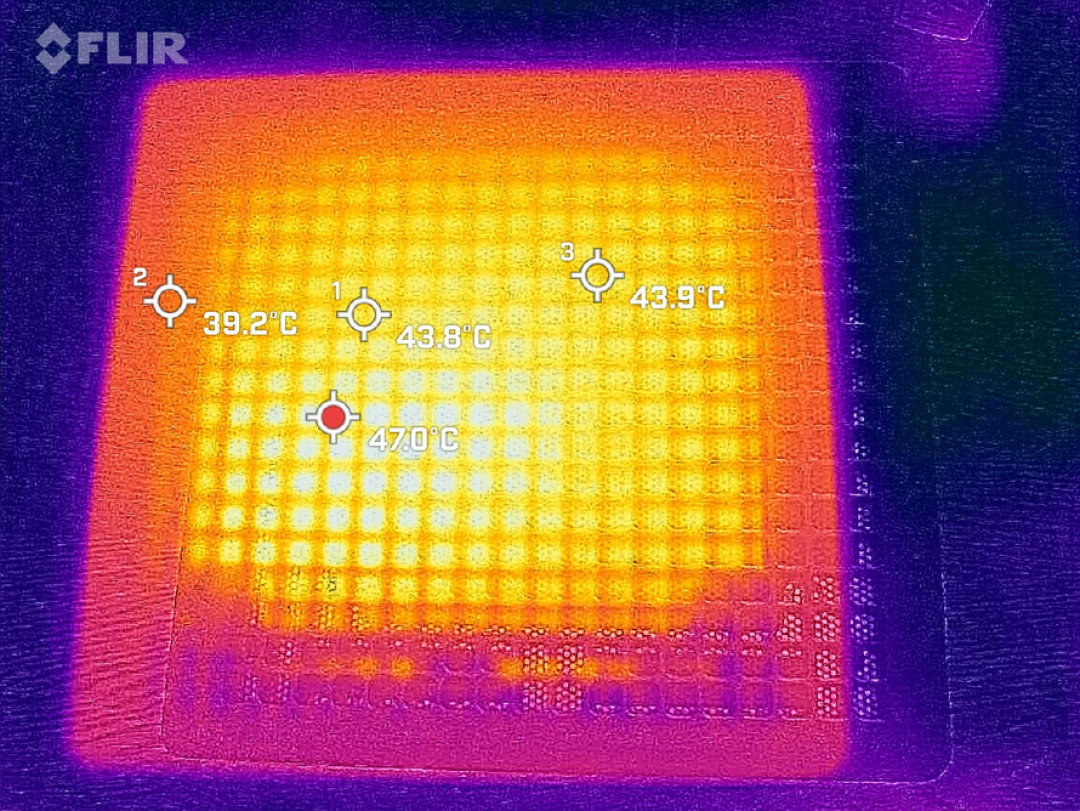
在温度方面,9分钟时AIDA64检测CPU二极管温度94℃,机器顶部出风口通过红外测温仪检测,最高为47℃。
 FLIR_20260831_014606_804.jpg
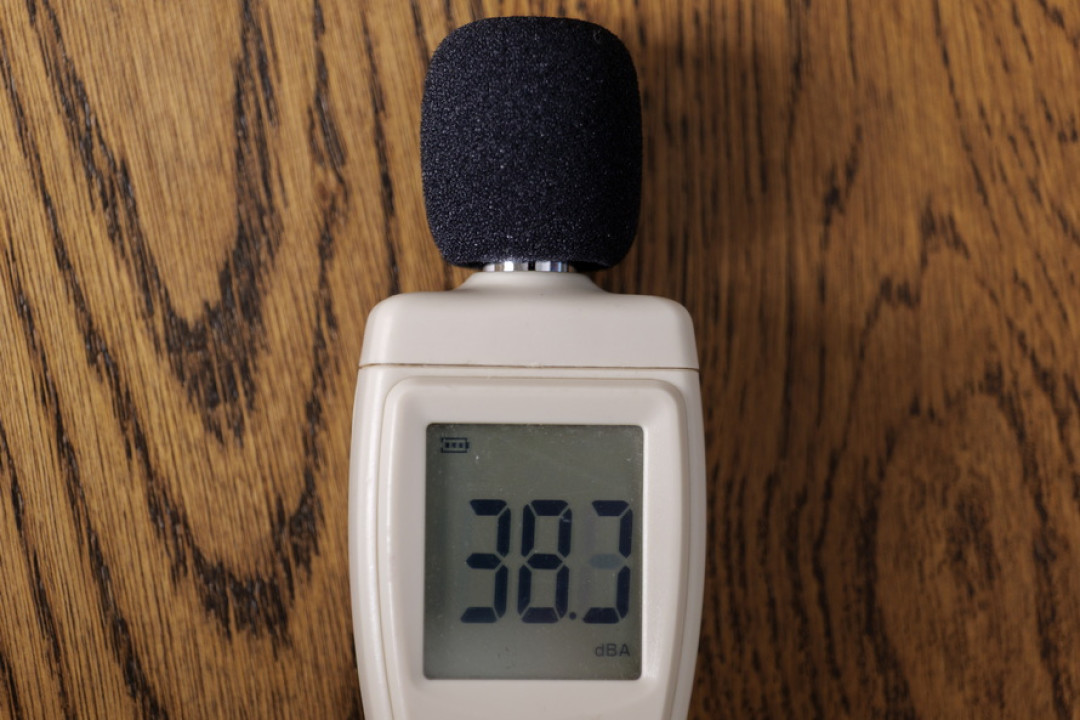
噪音也在双烤维持154W期间测了,距离0.5米实测38.3dBA,白天放桌上基本听不见噪音。
 P1325673.JPG
结语
把一套能压住176W的定制水冷、128GB统一内存和96GB可分配显存、还有内置400W电源全塞进7.9升的立方体里,雷神这台水冷迷你AI工作站走的不是堆料炫技的路子,而是真把“本地跑大模型”这件麻烦事做成了桌上的一件普通“家具”。对开发者和小团队来说,数据不出内网、一次投入长期可用,它解决的是实打实的痛点。
 P1325633.JPG
当然,叠加国补后到手26499不算便宜,但这套AMD锐龙AI Max+ 395把CPU、大内存和集显都揉进一颗芯片里,再加上水冷换来的安静和低温,值不值这个价,前面那些测试已经摆出来了。如果你正需要一台能年复一年蹲在桌角跑模型的机器,它确实非常值得选择。
作者:Napoleon Chan