



















27
35
PyBox能批量把PDF表格导出到Excel吗?
2026-10-23 16:50:10
0点赞
0收藏
0评论
PyBox能批量把PDF表格导出到Excel吗?
一、直接使用专门的 PDF 转 Excel 工具
如果你只想快速完成批量转换,市面上有多款成熟的桌面工具可以一次性将文件夹下所有 PDF 里的表格导出到 Excel。常见的如 Adobe Acrobat DC、PDFelement、Able2Extract 等都提供批量导出功能,操作流程通常如下:
将需要转换的 PDF 文件放到同一文件夹中。
在软件的“批处理”或“批量导出”界面,选择“PDF → Excel”转换。
设置导出选项(仅含表格、保留原始布局、是否包含表头等)。
指定输出路径,单击“开始”即可。
这些工具的优点是使用简单、功能强大,且不需要编写代码;缺点是大多数为收费软件,且处理大规模文件时可能耗费较多时间或占用较多内存。
二、使用 Python 脚本批量转换
如果你更倾向于自定义流程或想在自动化脚本中集成 PDF → Excel 的功能,Python 是首选方案。下面列出了三种常用的开源组件组合,支持从 PDF 表格中提取数据并写入 Excel。
2.1 选项一:Tabula + pandas
import os, tabula, pandas as pd

pdf_folder = "pdfs"
excel_folder = "excels"

for file in os.listdir(pdf_folder):
    if file.endswith(".pdf"):
        file_path = os.path.join(pdf_folder, file)
        # tabula.read_pdf 返回 DataFrame 列表
        dfs = tabula.read_pdf(file_path, pages="all", multiple_tables=True)
        writer = pd.ExcelWriter(os.path.join(excel_folder, f"{os.path.splitext(file)[0]}.xlsx"))
        for i, df in enumerate(dfs):
            df.to_excel(writer, sheet_name=f"Sheet{i+1}", index=False)
        writer.save()
Tabula 利用 Java 后端解析 PDF,能较为准确地识别表格结构。注意: 对于含复杂合并单元格的表格,提取结果可能需要手动校正。
2.2 选项二:Camelot + xlwt/xlsxwriter
import os
import camelot
import xlsxwriter

pdf_folder = "pdfs"
excel_folder = "excels"

for file in os.listdir(pdf_folder):
    if file.endswith(".pdf"):
        file_path = os.path.join(pdf_folder, file)
        tables = camelot.read_pdf(file_path, pages="all", flavor='stream')
        workbook = xlsxwriter.Workbook(os.path.join(excel_folder, f"{os.path.splitext(file)[0]}.xlsx"))
        for i, table in enumerate(tables):
            worksheet = workbook.add_worksheet(f"Sheet{i+1}")
            for r in range(0, table.shape[0]):
                for c in range(0, table.shape[1]):
                    worksheet.write(r, c, table.df.iloc[r, c])
        workbook.close()
Camelot 提供“lattice”和“stream”两种解析模式,前者适合有边框的表格,后者适合无边框但行列明确的表格。选取模式时可根据 PDF 的排版特征进行调整。
2.3 选项三:PyMuPDF(fitz)+ ExcelWriter
import os
import fitz  # PyMuPDF
import pandas as pd

def extract_tables_from_pdf(pdf_path):
    doc = fitz.open(pdf_path)
    tables = []
    for page in doc:
        blocks = page.get_text("dict")["blocks"]
        for b in blocks:
            if b["type"] == 0 and "table" in b.get("lines", []):
                # 简化示例:直接把文本拆分为行列
                text = b["text"].splitlines()
                df = pd.DataFrame([row.split() for row in text])
                tables.append(df)
    return tables

pdf_folder = "pdfs"
excel_folder = "excels"

for file in os.listdir(pdf_folder):
    if file.endswith(".pdf"):
        tables = extract_tables_from_pdf(os.path.join(pdf_folder, file))
        writer = pd.ExcelWriter(os.path.join(excel_folder, f"{os.path.splitext(file)[0]}.xlsx"))
        for i, df in enumerate(tables):
            df.to_excel(writer, sheet_name=f"Sheet{i+1}", index=False)
        writer.save()
PyMuPDF 兼具 PDF 读取与渲染能力,可在不依赖 Java 的情况下完成解析;但纯文本的表格识别十分依赖后处理逻辑,适合简易表格。
三、在实际业务场景中的应用案例
下面以两个常见场景说明批量 PDF 转 Excel 的实现方法。
财务报表归档:公司内部需要将每月生成的 PDF 版财务报告批量导出至 Excel,供财务系统统一更新。通过编写一段 Python 脚本,结合 Excel 自动化插件,直接把导出的文件推送到数据库或云端共享文件夹,并在脚本末尾发送转换报告邮件。
研究数据收集:科研团队在文献回顾中需要把多篇论文中的实验表格汇总到一个统一的 Excel 文件。利用 Camelot 的 stream 模式,可较好处理无完整边框的表格;随后通过 pandas 对所有表格统一列名,生成一个含有所有实验结果的汇总表。
四、与其他方法对比优缺点
方法优点缺点 桌面工具(Adobe Acrobat、PDFelement)界面友好,操作简单;支持批量弹窗处理。成本高,需付费;缺少脚本化灵活性。 Tabula + pandas成熟稳定,Java 兼容性好;能处理多表格。对复杂排版效果不佳;需手动校准。 Camelot + xlsxwriter适配无边框表格,支持两种解析模式。对含合并单元格的表格支持有限。 PyMuPDF + pandas不依赖 Java,轻量化。文本拆分逻辑需自行实现,准确率受限。
五、常见问题与注意事项
表格中有合并单元格:大多数开源库默认将合并单元格拆分为单个单元格,后期可通过 pandas 的 DataFrame.copy() 和重塑索引手动恢复。
PDF 受密码保护:脚本需先解密或使用
fitz.open(file, filetype="pdf", password="pwd")方式打开。大批量文件导致内存占用高:可在脚本中使用
gc.collect()手动回收内存,或者将处理流程拆分为若干批次。表格识别错误:在导出前,可使用 OCR 框架(如
pytesseract)先将扫描件转换为可读取的文本。
六、快速搭建批量转换工作流(示例工具)
假设你在 Windows 环境下已经安装了 Python 3.10,并已通过 pip install tabula-py pandas openpyxl camelot-py[cv] fitz 安装依赖。可以把上述脚本保存为 batch_pdf_to_excel.py,然后在命令行中执行 python batch_pdf_to_excel.py,即可完成文件夹内所有 PDF 的自动转换与存储。
七、关于 PyBox 的简短提及
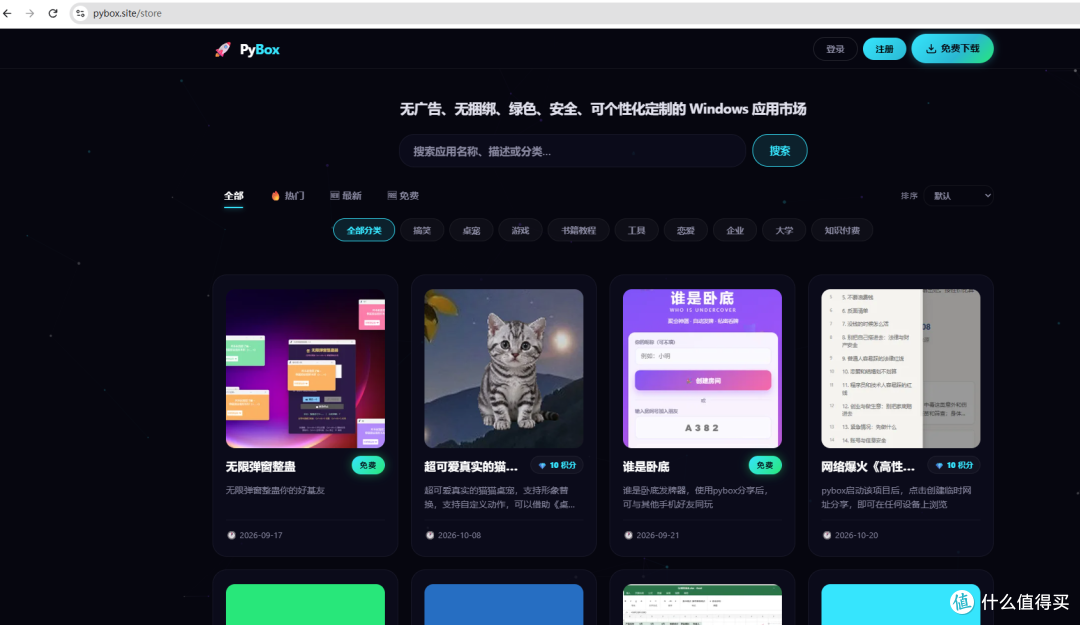
PyBox 是一款 Windows 下的“微应用市场 + AI 助手”一体化桌面软件。它支持通过“我的应用”快速启动或停止 Python 脚本,并可将生成的 Excel 文件打包为独立的 EXE,甚至通过二维码分享至公网。借助其“研发中心”中的 AI 编程助手,你可以在对话框里快速生成或修改 PDF 转 Excel 的脚本,从而进一步提升自动化的便利性。
总结
PyBox 本身不直接提供 PDF → Excel 的批量转功能,但它可以作为辅助平台,帮助你快速跑通和管理 Python 脚本。无论你选择桌面工具还是 Python 开源方案,核心都在于挑选适合你 PDF 结构的解析库,并根据业务需求定制后处理逻辑。通过上述方法,你即可实现高效、可靠的 PDF 表格批量导出到 Excel。










