



















6
5
编程榜65.7%对58.2%,国产模型第一次赢GPT-6
2026-10-24 20:19:42
0点赞
0收藏
1评论
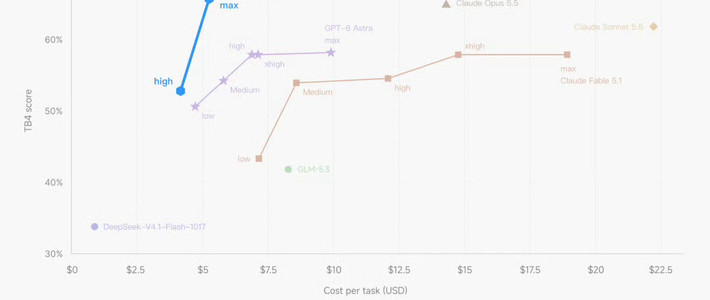
65.7% 对 58.2%。10 月 24 日凌晨,Kimi K3.1 Pro 在 Terminal-Bench 4.0 上反超 GPT-6 Astra,距离 Claude Opus 5.5 的 66.4% 只剩 0.7 个百分点。国产模型第一次在公开的终端任务榜单上,贴到闭源最强那一档。
发布会说了三件事
月之暗面 24 日推出 K3.1 系列首个模型 K3.1 Pro,3 万亿级参数、100 万上下文,同一天在 kimi.com、App、Kimi Work、Kimi Code 和开放平台放开。权重承诺在 11 月 4 日前发布,也就是说现在能用的只有 API 和产品,"开源"还得等二十天。
第三个细节最容易被读漏:同门还有个 Highspeed 版,同等智能、输出快 2~3 倍、价格 2 倍。这三个数字凑在一起,才是这次发布里最值得算的一笔账。
值得看的不是"最强",是那个只差 0.7 分的位次
Terminal-Bench 4.0 考的是真实环境里资源受限的终端任务,每项配一套严格的专项测试,靠背题库拿不到分,考的是模型自己拆步骤、调工具、看报错、再改。
所以 65.7 这个数字比"我们最强"有分量:前面只剩 Opus 5.5 的 66.4%,后面是 GPT-6 Astra 的 58.2%,同一梯队里第一次出现中文模型的名字。
发布里还有两行数据不该被跳过。BenchCAD 上 K3.1 Pro 是 92.7%,Opus 5.5 是 96.2%、GPT-6 是 95.9%,3D 与 CAD 这块还差 3 个多点;Kimi Code Bench 3.0 Long-horizon 的 61.2% 比自家 K3 高 5 个百分点,但那是内部题集,只能看进步幅度、跨公司比不了。
榜外也有参照。第三方评测机构 Artificial Analysis 的榜上,K3.1 拿到 55 分、被放进帕累托前沿那一档,Hacker News 上讨论它的帖子一早上换了三个位置。
3 万亿参数换来的具体东西
kimi.com 和 App 同步上了 3D Make,给一段文字、一张草图或一张参考图,它推断形状、比例与空间关系,重建成可用的 3D 模型,还能下载去打 3D 打印。更硬的一条是不需要 MCP 连接器,它可以直接写并运行 Blender、CAD 这类工具的脚本做参数化建模,改零件、调几何和材质都由它自己动手。
金融线的数字更能说明训练方向。内部三个基准里,财务建模比 K3 高 14%、金融研究高 20%、商业运营得分约为 K3 的 4.2 倍,外部 OfficeQA Pro v2 拿到 64.4,官方称是当前最优。幻觉那组对照也得跟注释一起读,Kimi Hallu Bench Hard 上单项事实陈述错误率从 23.4% 降到 8.3%,含至少一处事实错误的回答只有前代约 42.4%,官方自己注明样本刻意挑了易错情形、不代表日常水平。
价签里的算术,比榜单更该琢磨
API 定价是这样:每百万 token 输入 1.3 元(缓存命中)、13 元(未命中),输出 68 元。
拿一个典型 Agent 任务算一遍。输入 100 万 token、九成命中缓存,花费 0.9×1.3+0.1×13=2.47 元;输出 10 万 token,花费 6.8 元;合计 9.3 元,输出这一项占了七成三。
输出单价是缓存输入的 52 倍,这个价签在讲一件事:上下文尽量复用、让它少自由生成,成本才压得住。长会话 Agent 这两年能跑起来,靠的不是模型便宜,是缓存命中率高。
再回头看 Highspeed。价格 2 倍、速度 2~3 倍,折算成等它写完的时间成本大约是 0.8 倍,坐在屏幕前等结果的交互式编码,贵的那版反而更省;批量离线任务还是普通版划算。
别急着迁移,先做一件事
0.7 个百分点是单基准上的小分差,换套题可能就翻面;3D 那项还落后 3 个多点;权重 11 月 4 日才发,"开源"要等权重真的落地才算数。榜单告诉你它到了哪一档,不会告诉你它到你手上是什么样。
真要用,最省事的验证是把项目里最脏的活各跑一遍:翻出三年前的老代码改一个 bug、跨四个文件做一次重构、在没有文档的仓库里让它自己找入口。跑完再决定要不要搬工作流,比看十个榜单都直接。
模型换代快到榜单追不上,真正稀缺的是你清楚自己哪一步值得交出去。找一件最烦的活,今天晚上丢进去跑一遍,答案自己会出来。
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~











校验提示文案
校验提示文案