















65
62
豆豆谈AI系列:本地 AI 折腾一个月-显卡第一,其他都是配角
2026-09-14 13:55:51
0点赞
0收藏
0评论
先亮个相:这套“畸形”配置
先亮个相:我是豆豆,豆豆容器市场。今天这篇,不聊容器,聊聊本地 AI。先交代一下背景:我接触 AI 有两年了,从 ChatGPT 4 开始,一路用到 DeepSeek,云端 AI 的便利我很熟悉;但真正一头扎进“本地 AI”,是最近这一个月的事。这一个月,我把前面两年攒下的疑问,全在本地重跑了一遍。
按惯例,先报配置。不是凡尔赛,是“反面教材”:
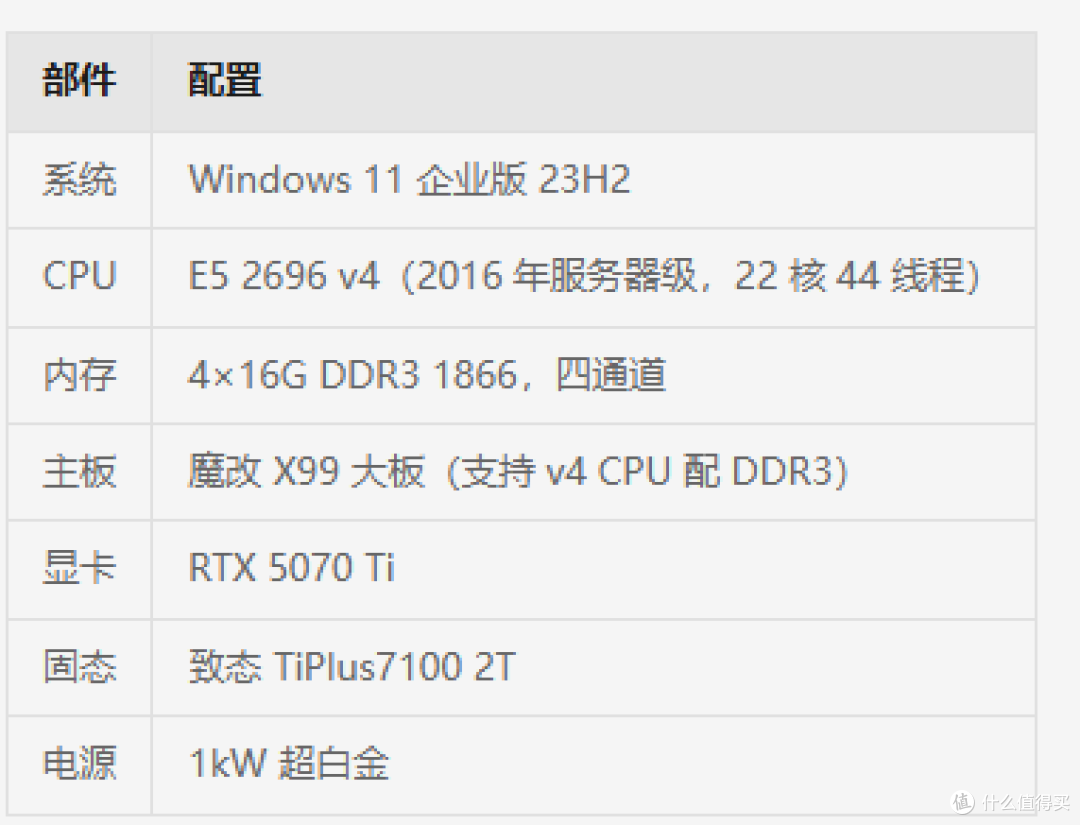
看懂了吗?这套配置一半是十年前的老平台,一半是最新的 50 系显卡,整个一“畸形组合”。但就是这套机器,跑本地大模型、跑本地 AI 应用,稳得很,也快得很。
我为什么敢用这么一套“过气”配置玩本地 AI?因为这一个月扎进去之后,我想明白了一件事:本地 AI 这事,宣传资料里教的“配置越高越好”“CPU 要最新”“内存要高频大牌”,大部分都是在教你多花钱。
这篇我就把这两年用 AI、这一个月扎进本地踩过的坑、想通的道理,全倒给你。不推荐型号、不列价格——重点只有一件事:打破你对 AI 硬件的刻板认知。
01 AI 前景很广,但落地其实只有两条路
先聊前景。AI 这两年已经渗透到几乎所有场景:写作、画图、做视频、写代码、做客服、翻译、数据分析……你可能没主动用它,但它一定在某个角落替你干活。这不是炒作,是正在发生的现实。
但“前景广”和“普通人怎么用上”是两回事。真正落地,其实只有两条路。
第一条,算力型——你自己提供算力。要么在本地跑推理框架,比如 llama.cpp 这类工具,把开源模型下载到自己电脑上跑;要么买云厂商的 API key,按量付费,把算力外包给云。
第二条,应用型——你直接使用成品。本地有 ComfyUI 这种工具,装好模型就能出图、出视频;云端有 Seedance 2.5 这类服务,一句话、一张图就能生成一段视频,什么都不用装。
看出差别了吗?算力型是“我出算力”,应用型是“我用成品”。这两条路不是对立的,而是互补的。分清它们,后面聊硬件才有意义——因为“要不要配电脑”,只在第一条路里才是个真问题。
给你几个身边的例子。你刷到的好多短视频文案、商品详情页、自动回复,背后可能都是 AI 在跑;办公软件里帮你拟周报的助手、翻译软件里越来越像人话的译文,也是。区别只在于:这些能力,你是想每次按量付费买,还是想在自己机器上随便跑。想明白这个,再看下面的硬件话题,你就有坐标了。
02 AI 会像流量一样,成为日常必需品
我对 AI 有个核心判断:它会像流量一样,变成日常必需品。
回想流量怎么改变我们的:一开始是“能省则省”,后来是“套餐里必须有”,再后来是“没有流量简直没法活”。AI 正在走同一条路——今天你可能只是偶尔用一下,用不了多久,它就会变成每天打开电脑的第一件事。
既然是必需品,问题就来了:全靠买云 key,行不行?
行,但不够。云 key 的优势很明显:开箱即用、不占本地资源、模型够新。短板同样明显:按量付费,用得越多越贵,长期是一笔持续支出;断网、高峰期排队的时候,说没就没;更关键的是,数据要上传云端,隐私和安全总有顾虑——很多内容,真的不适合交给第三方算力。
打个最朴素的比方:就像很多人不愿意把私人照片传到云盘一样,工作文档、项目代码、未公开的思路,你真的放心让它们躺在别人的服务器上吗?这不是矫情,是实打实的风险。就在这几天,就有数学家公开指控某 AI 厂商:他把大量未公开的解题草稿和推导思路传进了对方的云工具里,结果不久后对方就宣布了同一道题的证明,走的还是他研究许久的那条冷门路线(该厂商已公开否认)。连顶尖学者都要为自己的想法捏一把汗,普通人手里的方案、代码、客户资料,就更没有理由随便交给云端。而本地 AI 的好处正在这里:数据从头到尾不出你的电脑,没有上传,就没有泄露和剽窃的可能。
这时候,本地 AI 的价值就出来了:一次性投入,之后随便用;数据不出本地,隐私可控;离线可用,不看网络脸色;还能随心所欲地调参、换模型、折腾。
打个比方:云 AI 是自来水,拧开就有,方便,但按表收费、水质不由你;本地 AI 是自家井,挖的时候费点功夫,但从此取用自由。过日子的人都知道:自来水要有,井也不能少。
举几个我自己的真实场景。写代码的时候,我本地跑一个小模型帮我补注释、review 代码,私有仓库的代码一个字都不用传出去;翻译资料的时候,本地模型随叫随到,断网也照翻;出图出视频,ComfyUI 在本地跑,改参数改到手软也不花一分钱。这些事云服务也能做,但做到“天天用”的频率,云 key 的成本和顾虑就会把你劝退。本地 AI 的意义,恰恰在于它让 AI 从“偶尔尝鲜”变成了“随手就用”。
所以我的结论是:AI 是日后的日常必需品。云 key 管日常,本地 AI 管底气和自由。两者互补,本地 AI 绝不是可有可无的补充,而是必不可少的另一半。
03 干货一:四种算力平台,普通人只选一种
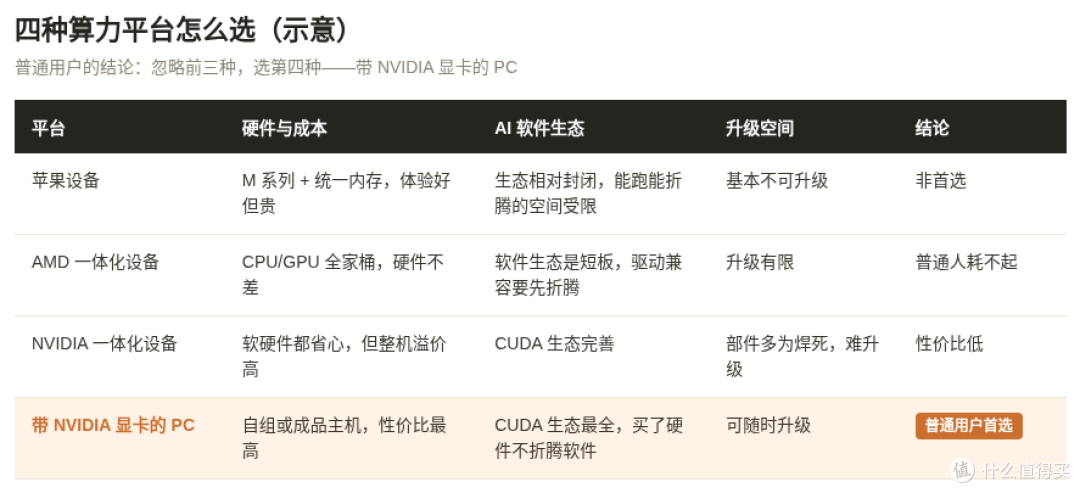
想玩本地 AI,先过第一关:买什么平台?市面上大致有四类。
第一类,苹果设备。M 系列芯片加统一内存,跑大模型的体验确实不错,不少 AI 玩家爱用。但代价是贵,生态相对封闭,能跑的东西、能折腾的空间都受限。对追求性价比的普通人来说,不是首选。
第二类,AMD 的一体化设备。CPU GPU 全家桶,硬件本身不差,但 AI 的软件生态是 AMD 的短板——很多框架和工具在 AMD 平台上,要先折腾半天驱动和兼容性。普通用户耗不起这个时间。
第三类,NVIDIA 的一体化设备。硬件、软件都到位,体验省心,但整机溢价高,后期想升级很麻烦,很多部件是焊死的。
第四类,带 NVIDIA 显卡的 PC。自己组装,或买一台带 NVIDIA 显卡的成品主机。
顺便说个我见过的现象:不少人冲着苹果的体验买了 Mac,跑了几天发现想跑的模型装不上、想用的工具没有适配,最后要么吃灰,要么又组了一台 PC。不是说苹果不好,而是“普通人的第一台本地 AI 机器”,容错率必须高——买错了能换、能升级、能折腾,这才是 PC 最大的价值。
答案很明显:普通用户,忽略前面三种,选第四种。
原因一句话就能说清:AI 这个东西,硬件只占一半,软件占另一半。NVIDIA 的 AI 软件生态(CUDA 那一整套)最丰富,买了它的硬件,剩下的就是直接用、随便折腾;其他平台正好反过来——硬件买了,软件开始折腾你。
四种平台看着热闹,普通人其实只有一个答案。
04 干货二:钱的分配顺序
平台定了,第二关更难:机器怎么配?这是今天最核心的干货。
先破除一个刻板印象:不是配置越高,本地 AI 就越强。在有限的成本里,把钱花在最需要的地方,才是正解。
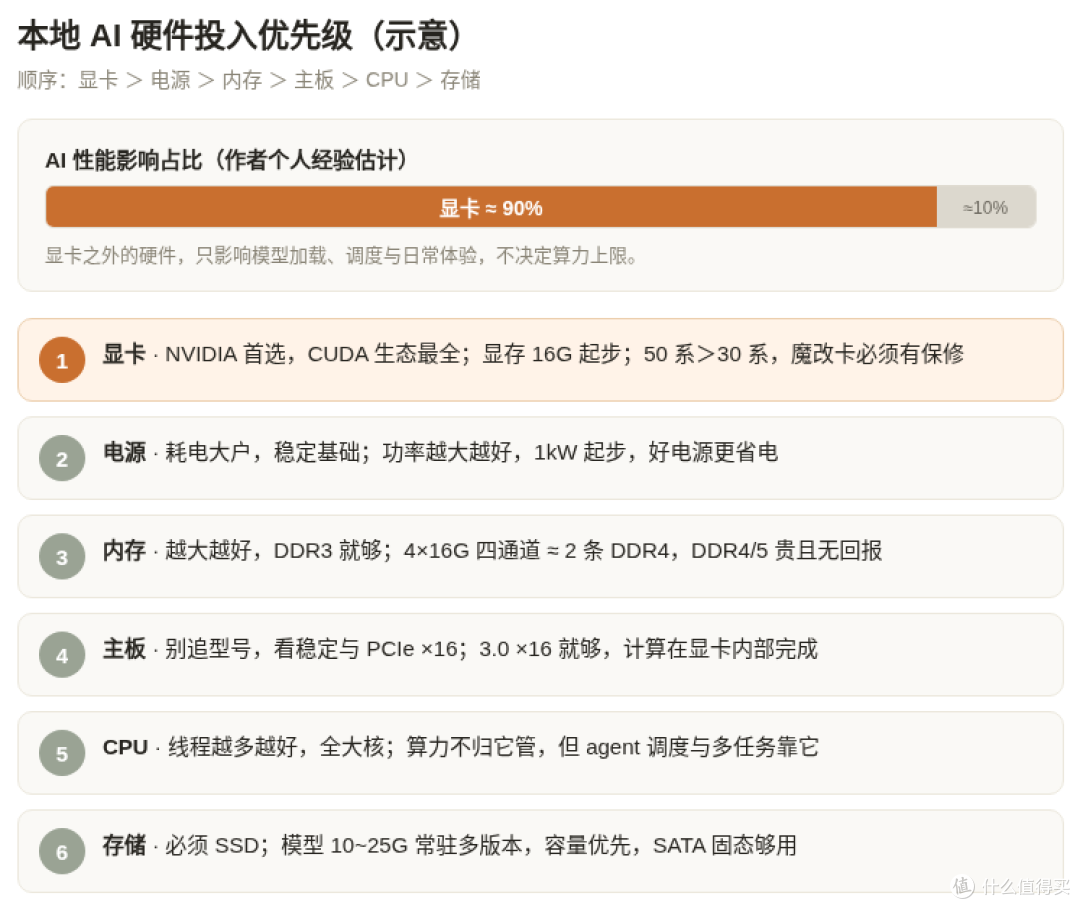
记住这个顺序:显卡 > 电源 > 内存 > 主板 > CPU > 存储。
再记住一个比例:AI 性能大概 90% 由显卡决定。这不是精确测量,是我两年用 AI、这一个月扎进本地跑下来的体感——同样的模型,换一张好显卡立竿见影;把 CPU、内存、主板全升级一遍,跑分是涨了,AI 该多慢还是多慢。其他硬件的投入,对 AI 算力基本没有意义——它们只影响模型加载的速度、任务调度的效率、日常使用的体验,不决定你“算得快不快”。
4.1 显卡:唯一的主角
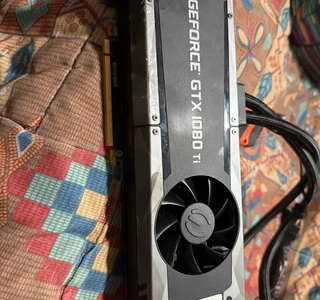
显卡是整套配置的绝对核心,值得花掉预算的大头。
为什么首选 NVIDIA?因为 AI 拼的不只是硬件,还有软件。NVIDIA 的 CUDA 生态是全世界最丰富的,主流 AI 框架、工具、模型,全都优先适配它。买了它的硬件,就不用折腾软件;买了别家的硬件,就得开始折腾软件——这条经验,我替各位交过学费。
拿我自己说吧,当年为了在非 NVIDIA 平台上把 AI 那套环境跑通,装驱动、配环境、换版本,折腾了整整一个周末,最后还是一堆报错。换成 NVIDIA 之后,官方文档、社区教程、现成镜像,要什么有什么,半天就全跑起来了。你花在硬件上的每一分钱,其实都在买“软件少折腾”。
显存是显卡上最重要的参数。16G 是起步线:只有到了 16G,才能比较从容地完成常规的 AI 功能,不用老想着“这个模型塞不塞得下”。显存不够,不是慢的问题,是很多事直接干不了。
显卡怎么选?有条件优先 50 系,新架构对 AI 的支持更好;预算不够,30 系及以上也完全够用——30 系以上的卡,在 AI 相关的硬件基础上(Tensor Core、指令集、量化加速这些)有了本质提升,和更老的卡完全是两个世界。
再提一句魔改卡。显存当然是越大越好,但记住一个前提:必须有保修。魔改卡水深,没有保修就是裸奔,翻车了没人管。有保修的魔改卡,才值得放进考虑范围。
4.2 电源:稳定的基础
第二重要的是电源。为什么?因为 AI 是真的耗电。
显卡满载时,整机功耗相当可观,不是普通办公机能比的。这时候电源的稳定性就是一切的基础——供电不稳,轻则降频卡顿,重则蓝屏死机,甚至伤硬件。
好电源还有一个隐藏好处:省电。转换效率高的电源,同样的输出,从插座上多取的电更少,长期下来是一笔不小的数。
所以电源的功率越大越好。我自己用的是 1kW,也推荐至少从这个起步。电源是整套配置里最值得“一次到位”的部件——它不会过时,换平台还能接着用。
4.3 为什么其他硬件不重要
讲完显卡和电源,剩下四个,很多人的误区是:觉得它们也很重要。实际上,对 AI 算力来说,它们真的不重要。讲两个底层原因。
第一,别指望 CPU 参与计算。AI 的核心是向量计算,向量计算需要专门的指令集支持,CPU 天生不是干这个的料。让它去算,等于让食堂大厨去开战斗机——不是不行,是不专业。
第二,内存干不过显存。随便一块显卡的显存带宽,都能秒杀最好的 DDR5 内存。模型真正干活的时候,数据都在显存里跑,内存只是“搬运工”。所以内存的档次,对 AI 算力意义不大。
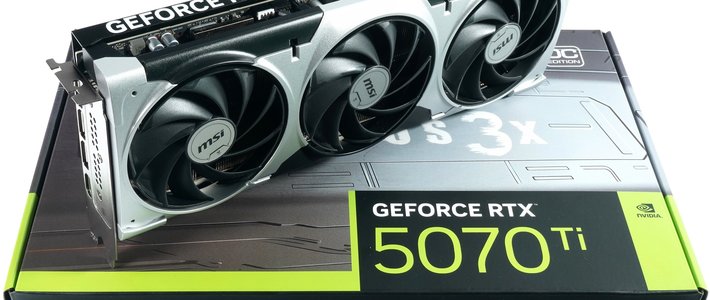
给你一组数字感受一下:RTX 5070 Ti 的显存带宽是 896GB/s;而最好的 DDR5 内存,双通道也就一百来 GB/s,差了一个数量级。模型真正跑起来,数据全在显存里以每秒近千 GB 的速度流转,内存那点带宽,连当“搬运工”都排不上号。
这两条理解透了,你就知道省下来的钱该往哪儿砸了。
把钱花在刀刃上,顺序比价格重要。
4.4 内存:越大越好,DDR3 就够
内存这条,我最有发言权——因为我用的还是 DDR3。
先说结论:内存越大越好,但档次不重要,DDR3 就够用了。
为什么越大越好?因为模型要加载、多任务要调度、agent 要常驻,这些都吃内存。内存不够,体验直接打折。
为什么档次不重要?我自己就是 4 条 16G 的 DDR3 1866,组了四通道,带宽约等于 2 条 DDR4 内存。日常跑本地 AI,一点不觉得是瓶颈。
反观 DDR4、DDR5,价格高出一大截,把经费砸进去,AI 性能一点回报都没有。省下这笔钱加到显卡上,那才是看得见的提升。
4.5 主板:别追型号
主板这个坑,坑了不少人。很多人一上来就追“高端型号”,其实完全没必要。
这里说的不是品牌,而是两个实打实的东西:稳定,和 PCIe 通道速率。
显卡插槽一定要 x16,这是底线。至于速率,PCIe 3.0 x16 就够了。为什么?因为 AI 的计算都是在显卡内部完成的,主板只是负责把数据送进去、把结果拿出来。PCIe 3.0 x16 的带宽完全够用,4.0、5.0 带来的提升,在本地 AI 场景下基本感知不到。
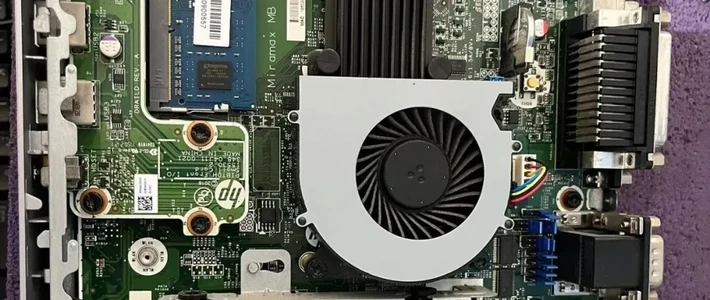
我自己用的就是 X99 大板。相信各位读者手里的主板,肯定比我这块好。
4.6 CPU:线程越多越好
CPU 这条,记住一句话:线程越多越好,方便多任务。
推荐全大核的 CPU,AMD 和 Intel 都可以。为什么强调全大核?因为 AI 场景下,真正的重活在显卡,CPU 的职责是“调度”:启动 agent、管理多任务、处理输入输出。线程越多,越能同时应付一堆任务,体验越从容。
我用的 E5 2696v4 就是 22 核 44 线程,跑起来很轻松。你弄个 8 核 16 线程的家用 CPU,其实也够,只是多任务多了会挤一点。
4.7 存储:SSD,容量优先
最后是存储。第一条铁律:必须固态硬盘,机械硬盘在 AI 场景下就是灾难。
模型文件有多大?一般能用得上的模型,都是 10G 起步、25G 以下。太大了显存放不下,太小了智力不够用——主流区间就在这。
拿常见的开源模型说吧,一个 7B 参数的量化模型,几个 G 起步;14B 往上的,基本都是 10G 以上。你迟早会发现,硬盘里躺着的不只是一个模型文件,而是同一个模型的五六个版本:原版、量化版、微调版、实验版……
而且你会发现,同一个模型经常要存好几个调优版本:base、量化版、微调版……所以存储容量越大越好。
速度反而不重要。SATA 固态就够——因为平时用的时候,也就是加载模型的那一下;真正跑起来,数据都在显存里。为旗舰固态多花的那笔钱,AI 一点都感受不到。
05 写在最后:把钱花在刀刃上
写到这里,核心的东西都讲完了。总结一下:
本地 AI 配机,没那么玄。显卡第一,电源兜底,内存、主板、CPU、存储按需就好。别被宣传带偏,别为参数焦虑,把每一分钱花在刀刃上——这就是我这套“畸形配置”能跑得很舒服的全部秘密。
也说一下边界:以上是豆豆两年 AI 使用、最近一个月扎进本地测试攒出来的经验,以个人使用和推理场景为主。训练模型、企业级部署是另一个世界,不适用这套思路;硬件价格一直在变,所以这篇里我刻意不给具体型号和价格——重点是认知,不是购物车。
如果你正打算配一台本地 AI 机器,记住一句话:预算的大头留给显卡,其余够用就好。
这套配置能跑得很舒服,你的,也能。
有什么想聊的,评论区见。豆豆在这里等你。
封面图
封面图与头图同源(AI 生成示意图),可直接复用。