










9
7
豆豆谈AI系列.2|AI短剧行业要黄了?本地跑AI才是主要原因
2026-09-17 11:11:59
0点赞
0收藏
0评论
01 字节的"AI印钞机",开始漏水了
先说个反差。
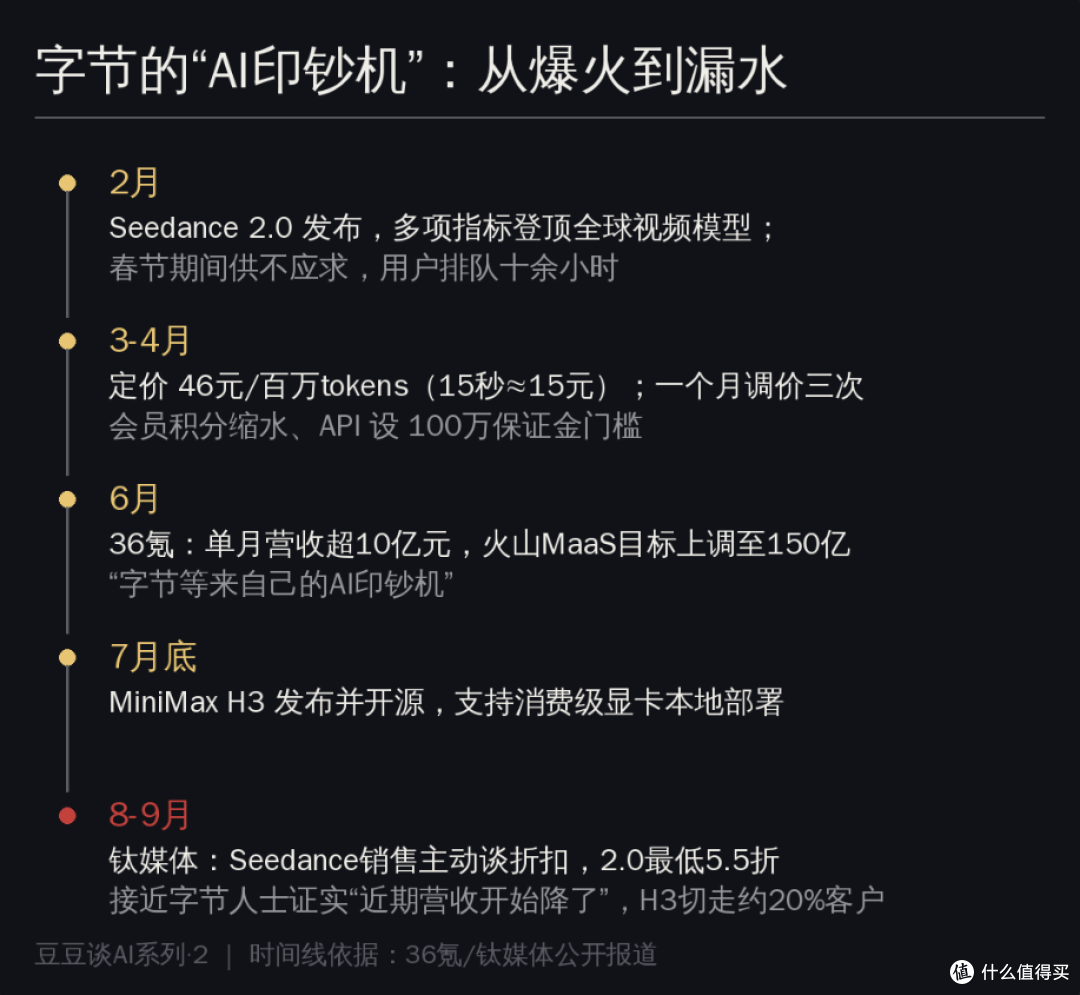
今年2月,Seedance 2.0发布那天,整个AI视频圈跟过年一样。多项指标登顶全球视频模型榜单,春节期间算力供不应求,用户排队十几小时是常态——做短剧的团队最怕的就是这个:片子排期卡着,平台那边按秒计费的时间窗口可不等人。
36氪后来的报道更直接:这个模型单月能给火山引擎带来超10亿元收入,"字节终于等来自己的AI印钞机"。火山MaaS全年营收目标一路上调到150亿——去年实际才15亿,一年要干10倍。媒体标题一个比一个振奋。
我当时看完就一个感觉:这帮人排队抽卡排得有多疯,后面就会摔得有多疼。
最直观的变化发生在制作团队那边。我认识几个做短剧的朋友,上半年抢Seedance的算力额度跟抢春运票似的,积分充着、排队等着,一条片子没出先烧掉几百块;到了9月,同样的预算他们开始问一个问题——"这钱是不是可以花在自己机器上?"
疼来得比预想中还快。钛媒体/白鲸实验室9月16日的报道《AI短剧市场见顶,Seedance开始降价》里写得明白:到了8、9月,Seedance的销售开始主动谈折扣了,2.0最低能到5.5折。一位接近字节的人士向媒体证实——"近期Seedance的营收开始降了"。
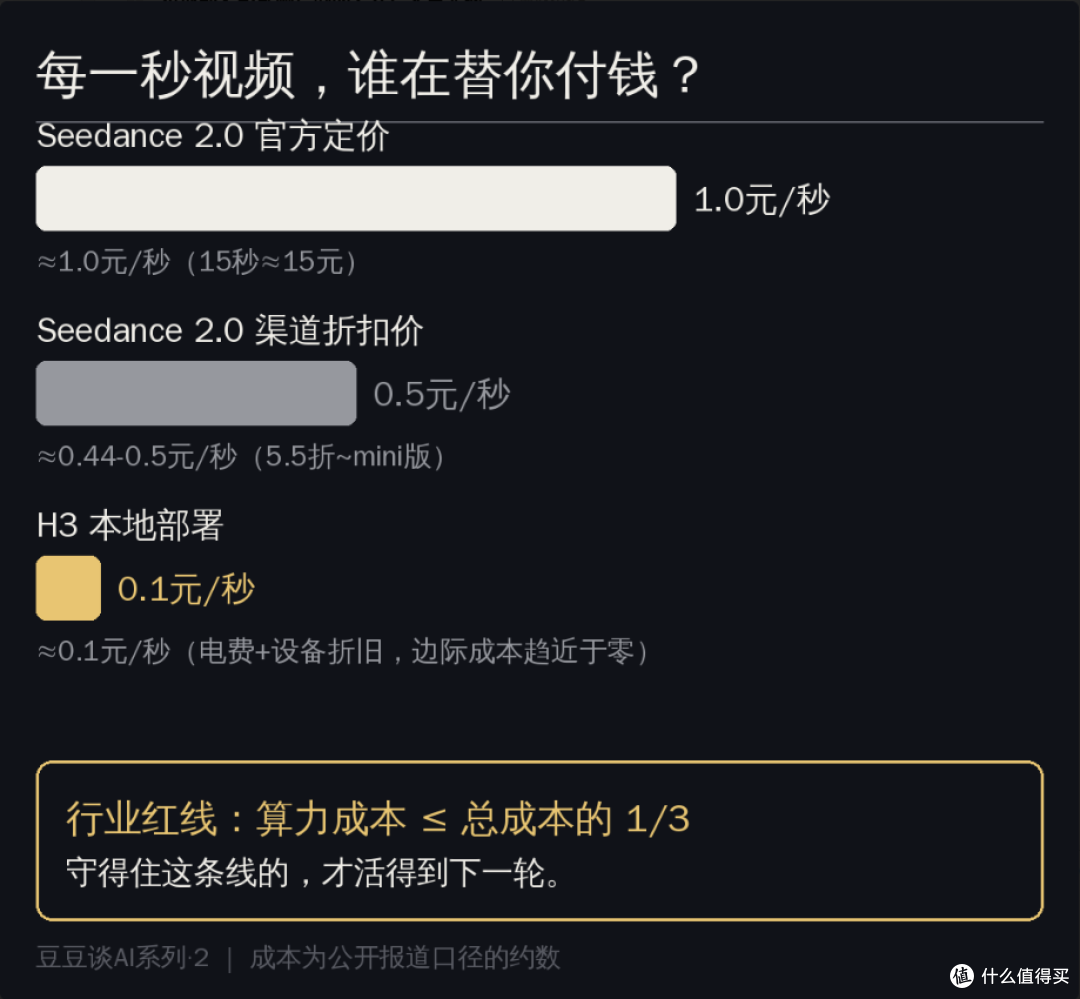
要知道这半年它是怎么涨价的:官方定价46元/百万tokens,折算下来一条15秒的视频差不多15块;三个月里调价三次,会员积分缩水,API侧还加了企业门槛和保证金之类的规矩。卖方市场嘛,爱用不用。
然后7月底,MiniMax H3发布并开源,支持消费级显卡本地部署,切走了大约20%的客户。原因就这么不复杂:你按秒收我的钱的时候,我嫌贵忍着;哪天我自己桌上就能出片了,你的折扣谈得再漂亮,也只是"从15块降到8块"。
视频生成赛道从"卖方市场"正式进入"降价换调用量"的阶段。而让字节第一次失去议价权的变量,不是又一个更强的模型——是本地部署。
02 从排队抢卡到收缩裁员:AI短剧行业的半年
再看下行业这半年的数字,不煽情,就摆事实。
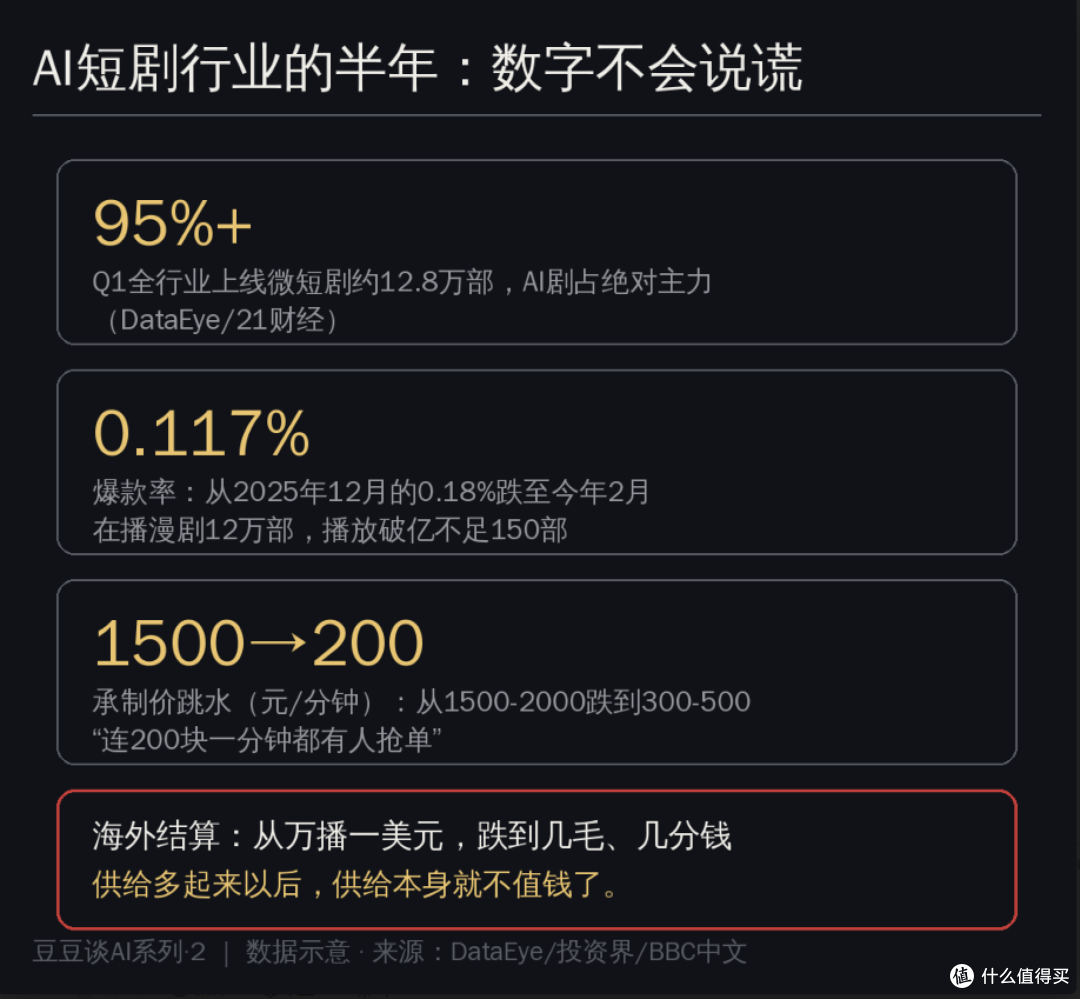
产能这边是爆炸的。DataEye和21财经的数据:今年Q1全行业上线微短剧约12.8万部,其中AI微短剧约12.2万部,占比超过95%。3月单月就有近5万部AI剧传上抖音,一个月几乎追平去年全年;红果那边更夸张,单日上新的漫剧约2000部,是真人剧的二十倍。
为什么所有人都冲了?因为效率太香了。传统短剧一部15到30天,AI短剧1到5天;成本从几十万压到几万甚至更低,一个人一天能产出40分钟合格内容。这种产能诱惑,谁顶得住?
但爆款率是反着走的。DataEye统计,2025年12月AI短剧的播放破亿比例还有0.18%,到今年2月在播漫剧暴涨到12万部的同时,这个数字跌到了0.117%——十二万分之一的头部通缩。在播漫剧十几万部,播放破亿的不足150部。
承制价跳水的速度更吓人:从节前的每分钟1500到2000元,掉到300到500元,投资界采访里有工作室老板说"现在连200块一分钟都有人抢单"。以前挑活干,现在抢着干。
人的部分更直接。BBC中文报道了横店、西安等地剧组解散潮;澎湃和虎嗅的采访里,九州山海裁员收缩、承制公司各自流血,行业普遍在砍真人剧产能、压缩AI团队规模。出海那边也一样:4、5月还能靠转制剧赚点钱,到7月结算已经低到万播一美元,甚至几毛几分——供给多起来以后,供给本身就不值钱了。
有意思的是,这半年最忙的反而是工具链和中间件团队:批量抽卡脚本、自动质检过滤废片、镜头级版本管理……大家都在卷"怎么把同样的钱花出更多可用镜头"。而其中性价比最高的一刀,砍向的就是算力本身。
平台的动作其实早就透出了信号。年初还是各家抢着给流量扶持、抢内容,到了年中,AI内容的推荐权重开始收紧——同质化太严重了,算法也得保用户体验。分账端更直接:单部剧的保底在降,纯靠投流回本的团队现金流绷得最紧。
把所有数字摞在一起看:产能爆炸没有解决"什么会爆"的问题。内容同质化把爆款率打到千分之一以下,承制价腰斩再腰斩,而每一分钟片子里都含着算力成本。成本结构没改的人,最先出局——这不是预测,是正在发生的事。
03 真正的变量:本地部署把边际成本打到零
那为什么是现在?为什么不是去年、也不是明年?
因为H3在7月31日开源之后,第一次让"消费级显卡跑工业级视频生成"这件事成立了。
去年不是没人想过本地部署,是条件不成立:那会儿的视频模型要么闭源只卖API,要么开源的画质拉胯、步数动辄上百,一张4090跑一条15秒片能磨半天,还不敢保证能商用。本地方案一直停留在"玩具"阶段,做内容的人没理由为它改工作流。
H3把这两条线同时跨过去了——质量够商用,速度社区又给卷上来了。模型侧第一次具备了替代API的完整条件:权重公开、显存要求卡在消费级甜点区间(16GB够用)、生态工具一周内跟齐。
算一笔账就明白差距在哪:
口径
每秒成本(约)
Seedance 2.0 官方定价
≈1.0元/秒(15秒≈15元)
Seedance 2.0 渠道折扣价
≈0.44-0.5元/秒
H3 本地部署
≈0.1元量级,且趋近于零
钛媒体9月的报道口径里,官方价折合约1元/秒;而H3本地这一栏,填进去的还是个约数——因为真正的成本是电费加设备折旧。显卡是一次性投入,之后每生成一条片子,你多花的钱基本就是那几度电。社区里有做过完整测算的:一张两三千元级别的卡,大概跑2700条10秒视频就回本,之后的每一秒都是纯利润。
换个团队视角更直观。一个月产8小时正片的工作室,全走API满打满算几千块算力费,这还没算废片——后面第04章细说。换成"关键镜头走Seedance、其余本地H3通宵跑"的混合打法之后,月度算力支出能砍掉大半,省下来的钱干什么?补剧本、加剪辑、买投流测试——这些才是真正决定爆款率的东西。
所以行业里已经形成了新的共识打法:关键的仿真人镜头继续用Seedance——这块它依然是最好的;其余质量要求没那么极致的任务,本地H3慢慢跑。不着急的镜头挂着通宵跑,第二天早上起来收片就行。模型从"入口"降级成了"供应商",谁的工作流先改完,谁的毛利就比同行厚一截。
制作方内部有条红线:算力成本不能超过总成本的三分之一,超过这事就没得干。半年前没人关心这条线,现在它是生死线。守得住的,才活得到下一轮。
04 我的5070 Ti:一条10秒视频只要120秒
说到本地部署,网上最常见的两种声音:一种说"消费级显卡跑短剧是痴心妄想",另一种直接劝你买4090、上服务器。这两种说法有一个共同点——都是拿H3刚开源那两周的状态在吓唬人。
这里得把H3的速度进化史讲清楚,全是社区公开实测的数据:
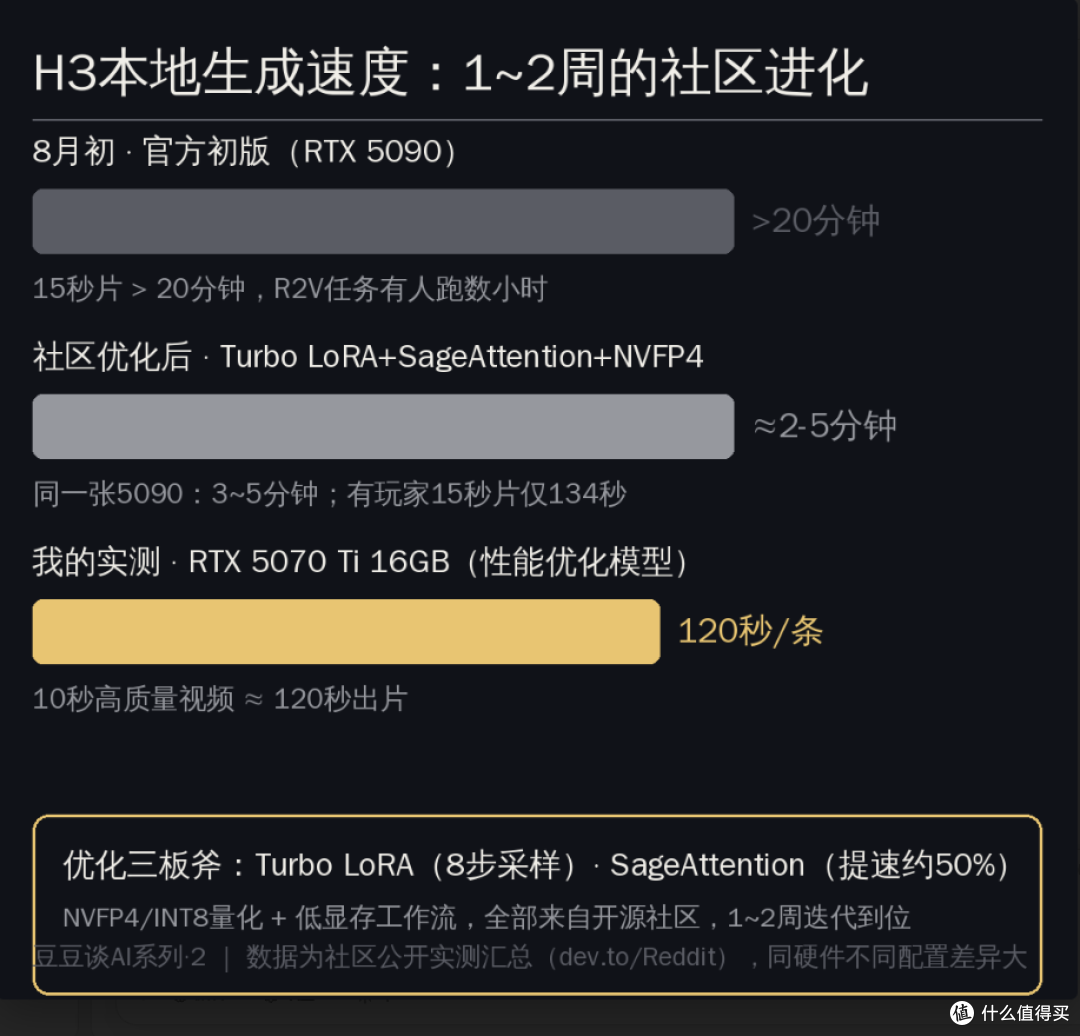
8月初官方刚开源时,默认模板在旗舰RTX 5090上跑一条15秒的片子要20分钟以上,有人的R2V任务一挂就是几个小时。"本地太慢"的骂名就是这么来的;
随后1到2周,社区持续发力:Turbo LoRA(8步采样)、SageAttention注意力加速(时间直接减半、画质无损)、NVFP4/INT8量化权重、低显存工作流,一个接一个落地。同一张5090,从22分钟打到3到5分钟,有玩家15秒片段只用了134秒;
社区汇总里甚至出现了和我同级别的配置:RTX 5070 Ti配64GB内存,小分辨率档冷启动118秒、热跑93秒——和我的实测完全同一量级。
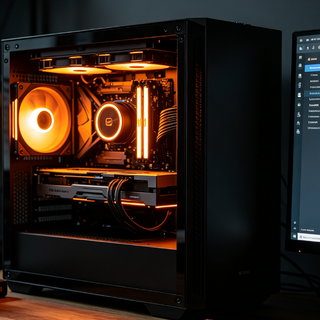
我自己的机器是什么水平?先亮个底,免得有人说我拿新卡吹牛:
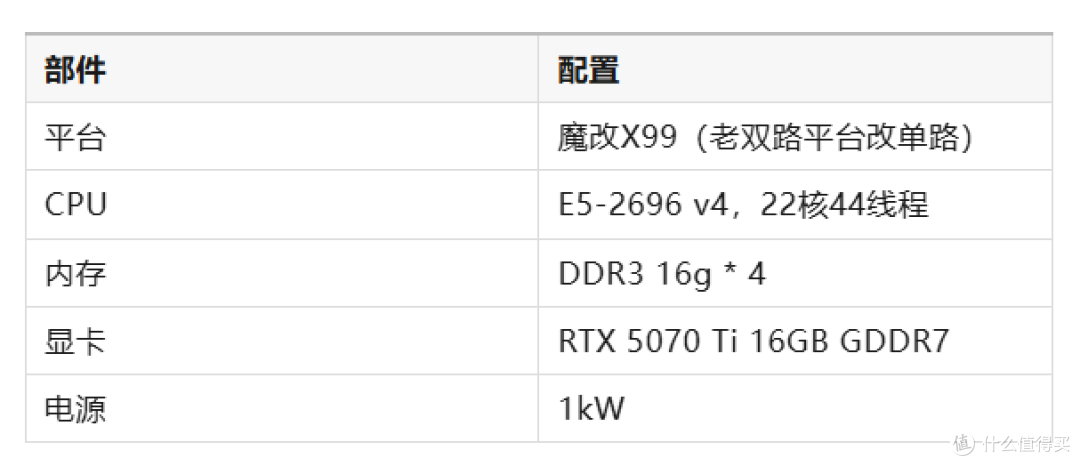
不是凡尔赛,是反面教材:CPU是老古董,内存还是上一代的。老平台插新卡跑在PCIe旧速度的兼容模式下——但视频生成是算力密集型任务,瓶颈在显存和计算单元不在总线带宽,这点速度损失可以忽略。唯一像样的就是这张5070 Ti。
实测结果:用H3的性能优化模型,一条10秒的高质量视频,生成时间120秒。不排队、不限速、不扣积分、没有"向上取整计费"。
有人可能会问:网上那些"消费级显卡跑不动"的帖子怎么解释?我前面把速度进化史摆出来就是这个意思——你看到的那篇帖子,大概率写于8月第一周。开源社区迭代视频模型的速度,和传统软件行业完全不是一个物种:一个加速方案从提出到进主流工作流,平均不到两周。所以评估本地部署别问"现在最快多少秒",要问"这个生态的迭代速度有多快"——答案通常是,你观望的每一天都在错过一版更快的配置。
我现在的日常节奏是:白天写提示词、排镜头表,晚上把一整批任务挂上去,第二天早上起来收片——机器嗡嗡转一宿,电费几块钱。
这就引出了第三方平台最隐蔽的坑——抽卡。行业里视频生成的可用率长期只有两到三成,你付的钱里有7成买的是废镜头:手部畸形、台词口型对不上、动作糊了。而按次按秒收费的平台,废片照收不误。本地跑是什么体验?这条不满意,改个提示词再抽一次,成本是几度电。同样一笔预算,本地能多抽2到3倍的卡;同样的时间窗口,别人在等算力排队,我在等咖啡凉。
一部剧按100个镜头算,走API满打满算上千块纯算力费,还没算废片重抽和排队的时间成本。这笔钱归零之后,短剧这门生意才真正剩下了"内容"本身该花的东西。
05 Win11装ComfyUI:别被网上的安装包带跑偏
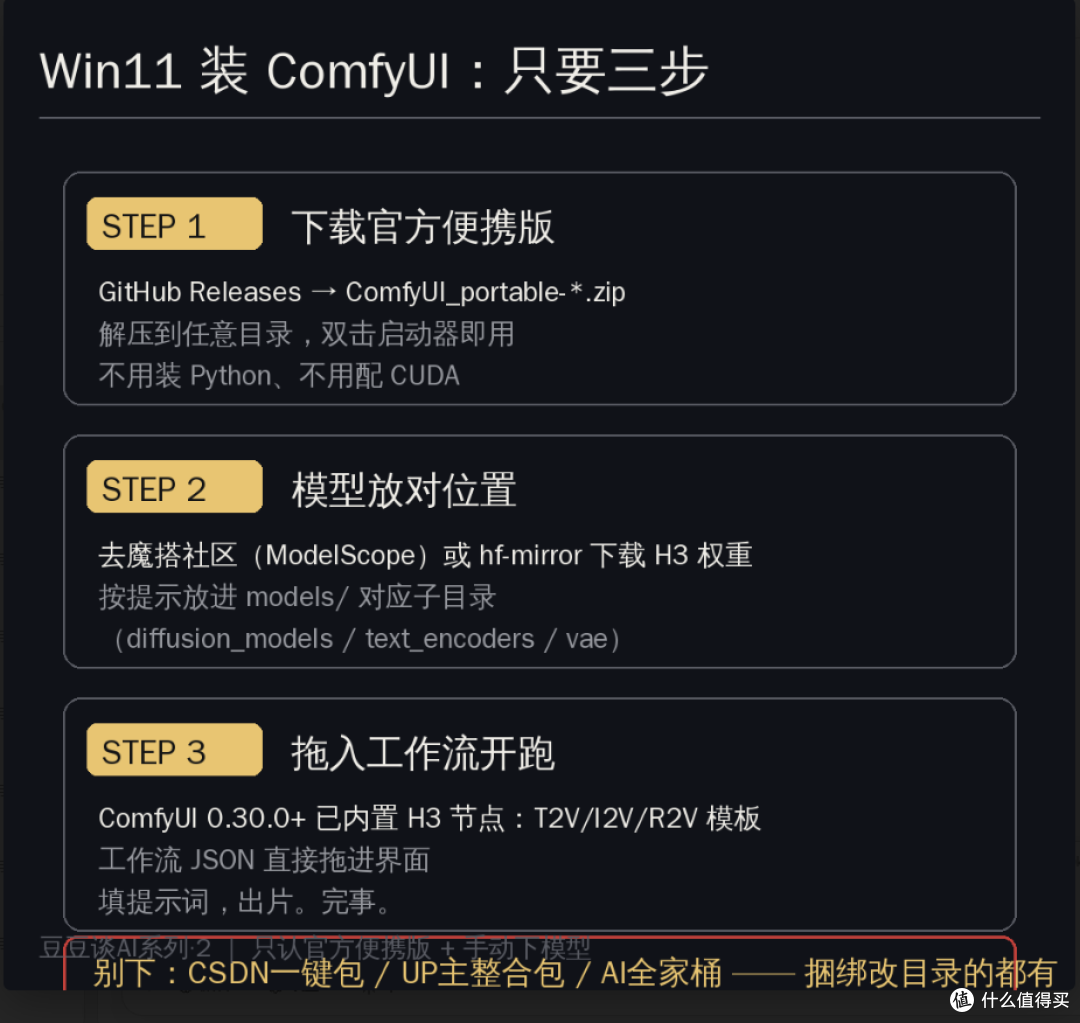
最后说点纯干货:环境怎么搭。误解一:"ComfyUI要配Python、装CUDA、下十几个依赖,劝退90%的人。"——不用。官方便携版(GitHub Releases里的ComfyUI_portable压缩包),解压到任意目录,双击启动器,完事。Win11上没有任何额外步骤,显卡驱动是新的就认得它。
误解二:去下载各种"CSDN一键包""B站UP主整合包""AI全家桶"。我见过不少,捆绑改目录结构、塞推广组件的都有,出了问题连哪层套了壳都找不到。我只认官方便携版加手动下模型,干净可控,每一步都知道自己在干什么。
装好之后有个好消息:ComfyUI 0.30.0以上版本已经原生内置了H3节点,文生视频、图生视频、参考生视频的模板都在官方模板库里,按提示下载对应权重放进models目录就行,不需要再装任何第三方"加速套件"当依赖——那些"必装加速插件"多半是旧时代的遗留。
模型去哪下?两个地方:魔搭社区(ModelScope)和hf-mirror(HuggingFace的国内镜像),H3的开源权重直接拉,工作流JSON拖进界面就能跑,改个提示词就是下一条片。
两个提醒。第一,磁盘别省:模型本体加量化版、LoRA加起来轻松几十GB起步,建议单独划一个500GB以上的盘放models目录,SSD比HDD快不止一点——权重加载慢的时候你会怀念机械硬盘的转速。第二,版本选择:16GB显存的卡直接用性能优化档的工作流和量化版权重就行,别执着于满血版;画质差距在短剧镜头尺度上几乎看不出来,速度差一倍多才是真的疼。
三个最常见的坑,提前说:一是启动器认不到显卡,九成是NVIDIA驱动太老,去官网更新就行;二是显存不够报OOM,换低显存工作流或者量化版权重,16GB的卡正常用不会碰壁;三是模型下好了没反应,检查是不是放错了子目录——diffusion_models、text_encoders、vae各归各位。
06 收尾
把今天这堆数字收拢成一句话:AI短剧不是没前景了,是"烧钱抽卡"的玩法没前景了。产能爆炸之后,行业拼的不再是"谁会用Seedance",而是谁的算力成本结构先改完。字节的印钞机漏水漏到今天,本质上是全行业把算力搬回家这件事的镜像——模型厂商失去议价权,制作方拿回定价权,同一件事的两面。
我的5070 Ti还在桌上嗡嗡地转着,120秒一条,不排队不收钱。下一轮门票就发在这种地方。
评论区聊聊:你现在本地跑的是哪个模型?多少秒出一条?咱们对个答案。