















 深耕数码兴趣领域






16
19
阿里突然开源27B,我扒拉出显存账一算,24G卡的兄弟直接好家伙
2026-08-17 14:54:26
5点赞
53收藏
34评论
 图片
昨晚十一点多,胜哥洗完澡躺床上,准备刷两条短视频就睡。
结果手机刚亮,一个叫「捡垃圾致富交流群」的群,消息跟炸了锅似的往上跳。
胜哥点进去,一个群友甩了张截图——二手 RTX 3090 的闲鱼订单,配了一行字:
「就等这一天。」
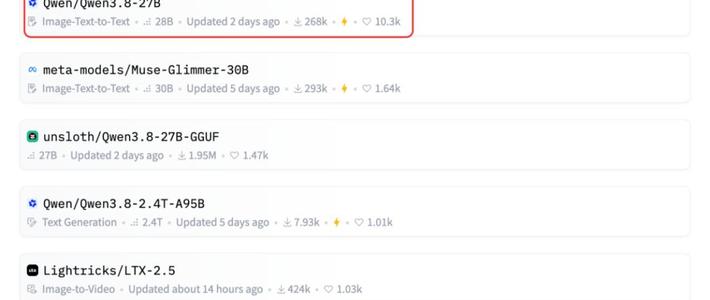
往上翻翻才明白,阿里千问昨晚开源了 Qwen3.8-27B,一个 270 亿参数的模型,官方原话叫「家用显卡也能跑」。
群里瞬间分两拨。
一拨兴奋:「24G 卡春天来了!」另一拨慌:「我 4060Ti 16G 到底能不能跑?在线等,挺急的。」
还有个兄弟,头像是个柯基,ID 叫「穷鬼也要跑 AI」,连发三条:
「我看网上说 17G 就能跑,那我 16G 差一点是不是也能冲?」
胜哥本来都关灯了,被这仨问题吵得睡不着,索性爬起来开了电脑。
把显存这笔账,从头到尾重新算了一遍。
算完,胜哥盯着屏幕,好家伙——这账跟网上传的,压根不是一回事。
先把结论撂这儿,省的你们往下翻
24GB 显卡(二手 3090 / 4090 / 5080):能跑,4-bit 量化权重约 16~17GB,配短上下文,这是甜点位。
16GB 显卡(4060Ti / 4070 / 4080):别硬上。这模型是稠密 27B,16G 是地板以下,硬塞只能上 Q3 或 CPU 卸载,慢得你想砸键盘。
32GB 统一内存的 Mac:最舒服,闭眼冲。
32GB 卡(5090):更从容,长上下文也不虚。
一句话:这模型的真门槛是 24G 起,不是网上喊的 17G。
这模型到底啥来头,值不值得你半夜爬起来
先别急着算卡,搞清楚它是干嘛的。
Qwen3.8 是个系列,8 月 3 号发布,12 号开源了 Max 级的 2.4 万亿参数巨无霸,14 号晚 23 点放出来的这个 27B,是第二档,也是普通玩家唯一摸得着的那档。
几个硬参数,胜哥给你列清楚:
270 亿参数,稠密(Dense)模型——不是那种激活一半的 MoE,是实打实的 27B。
原生多模态:文本、图片、视频都能吃。这点很关键,下面跟 30B 对比时用得上。
262K 原生上下文,靠 YaRN 能外推到 100 万 token。
Apache 2.0 协议:随便下、随便改、商用都行,不锁你脖子。
新加了个 reasoning_effort 开关,能按任务难度控制思考深度,省算力。
官方说它「编程和办公表现超越了 Qwen3.7-Plus」。这话是厂家自己喊的,独立评测还没出来,胜哥先打个问号,别急着信。
顺带说一句,为啥一堆人死盯着 27B 不放?胜哥给你说人话——模型尺寸这条线,7B、14B 太弱,干复杂点的活就露馅;70B、100B 太肥,消费级显卡根本塞不下。27B 正好卡在中间:能力开始摸到旗舰的边,硬件门槛又没高到只能上服务器。所以本地党管它叫「黄金尺寸」。
这次阿里的节奏也耐人寻味:8 月 3 号发预告,12 号先扔个 2.4 万亿的 Max 镇场子,14 号晚再放 27B 安抚普通开发者。秀肌肉归秀肌肉,至少没把咱们这些玩不起服务器的给忘了。
显存这笔账,到底该怎么算
这是今天最值钱的部分,胜哥给你掰开揉碎。
一个 27B 的稠密模型,显存占用主要看量化精度。按公开数据算下来:
BF16 全精度:约 54GB——别想了,那得 H100、H200,或者 96G 的 RTX Pro 6000。
FP8:约 27GB——L40S、32G 的 5090 这个段位。
Q6_K:约 21GB——24G 卡能塞,但吃紧。
Q4_K_M:约 16GB——二手 3090 / 4090 的甜点位。
Q3_K_M:约 13GB——最紧的单卡选择,画质(精度)掉得明显。
Unsloth 动态 4-bit:约 17GB。
注意,上面这些全是权重本身的大小。
真正坑人的,是后面还要加一笔——KV 缓存。
 图片
说白了,模型文件大小只是首付,KV 缓存才是月供。
17G 能跑?这数字骗了多少人
「17G 就能跑」这个说法,源头是 Unsloth 发布的量化版本,说的是权重约 17GB,没毛病。
但权重只是地板,不是全部。你一问一答,模型得把上下文存在显存里,这就是 KV 缓存,它跟着上下文长度涨:
8K 上下文:约 0.5GB
16K:约 1GB
32K:约 2GB
128K:约 8GB
262K 拉满:约 16GB(这数字是按前代 27B 结构估的,官方实测没出)
你算算:17GB 权重 + 128K 上下文 8GB 缓存 = 25GB,已经超过 24G 卡的物理显存了。
写到这里,胜哥停下来想了想。16G 卡到底是不是彻底没戏?
严格说不是。你可以上 Q3_K_M(13GB),再把上下文压到 8K、16K,或者挪几层到 CPU 上(offload)。能跑起来,但那个速度——首 token 等半天,生成起来一个字一个字往外蹦。
胜哥的结论是:能跑 ≠ 能用。16G 硬上,体验跟便秘似的,不如老实跑 14B 或 7B。
所以那个「穷鬼也要跑 AI」的柯基兄弟,胜哥的答复是:别冲,你这 16G 差了临门一脚,不如省下钱吃顿好的。
 图片
跟 8/12 那个 Muse-Glimmer 30B 怎么选
三天前胜哥刚写过 Meta 的 Muse-Glimmer 30B(没看过的去翻历史),今天又来个 27B,有人该纠结了。
两个都是「24G 卡能跑」这一档,但路子不一样:
Muse-Glimmer 30B:多模态 + Agent,偏视觉、偏任务执行,K-Quant 也是约 17GB。
Qwen3.8-27B:中文底子厚(阿里系一贯强项),多模态,编程/办公是主攻,262K 长上下文是杀招。
胜哥的建议不复杂:
你要中文问答、写代码、办公文档,优先试 Qwen3.8-27B。
你要视觉理解、Agent 跑任务,Muse-Glimmer 30B 那套可以继续用。
拿不准?两个都下 4-bit 版,各跑一遍你自己的真实提示词,谁顺留谁。别信评测图,信你手里的活。
 图片
一句话:本地玩模型,别问「能不能跑」,要问「跑起来爽不爽」。
去哪下,怎么跑
地址胜哥给你贴官方原链,别去那些二手搬运站下,免得夹带私货:
HuggingFace:https://huggingface.co/collections/Qwen/qwen38
魔搭社区:https://www.modelscope.cn/collections/Qwen/Qwen38
跑的话,最省事是等 Ollama 收录(ollama pull qwen3.8:27b),几行搞定;想折腾就用 llama.cpp 挂 GGUF 量化版,24G 卡记得上下文先设 16K、32K 起步,测稳了再往上加,别一上来就 128K,容易 OOM。
适合谁,不适合谁
适合:手里有 24G 卡 / 32G Mac 的本地党、想做私密中文助手的、想白嫖 Apache 2.0 商用的。
不适合:16G 卡以下还想强上的、懒得折腾等官方一键包的纯小白、指望 27B 干赢云端大模型的(那不现实,本地图的是私密和免费)。
胜哥昨天夜里爬起来算这笔账,不为别的,就是看不得群里兄弟被「17G 能跑」一句话骗去下单。
记住这句:权重 17G 不等于显存 17G。能跑和能用,中间隔着一整个 KV 缓存。
至于胜哥自己——手里没 24G 卡,最近也在闲鱼蹲二手 3090。昨晚看群里那兄弟晒的订单,胜哥默默点了个收藏。
(胜哥科技数码聊,垃圾堆里捡过宝也翻过车,专治各种硬件选择困难症)
关注胜哥,下期接着聊。懂的都懂,不懂的说了也不懂。











cpz2025
校验提示文案
bigstars
校验提示文案
迎风落泪
校验提示文案
mengtingiii
校验提示文案
无故事的人
校验提示文案
金沙子
校验提示文案
不吃香菜__正
校验提示文案
从容的鱼
校验提示文案
乄十四行诗
校验提示文案
朝别暮还
校验提示文案
Carbondioxide
校验提示文案
麦乐酷的理想生活
校验提示文案
六七是只猫
校验提示文案
值友1220770410
校验提示文案
值友2907264589
校验提示文案
值友9171706906
校验提示文案
久一点吧
校验提示文案
六七是只猫
校验提示文案
cpz2025
校验提示文案
久一点吧
校验提示文案
值友9171706906
校验提示文案
麦乐酷的理想生活
校验提示文案
Carbondioxide
校验提示文案
朝别暮还
校验提示文案
乄十四行诗
校验提示文案
值友2907264589
校验提示文案
值友1220770410
校验提示文案
从容的鱼
校验提示文案
不吃香菜__正
校验提示文案
金沙子
校验提示文案
无故事的人
校验提示文案
mengtingiii
校验提示文案
迎风落泪
校验提示文案
bigstars
校验提示文案