

AI记忆最大的误区,是记得越多越好。
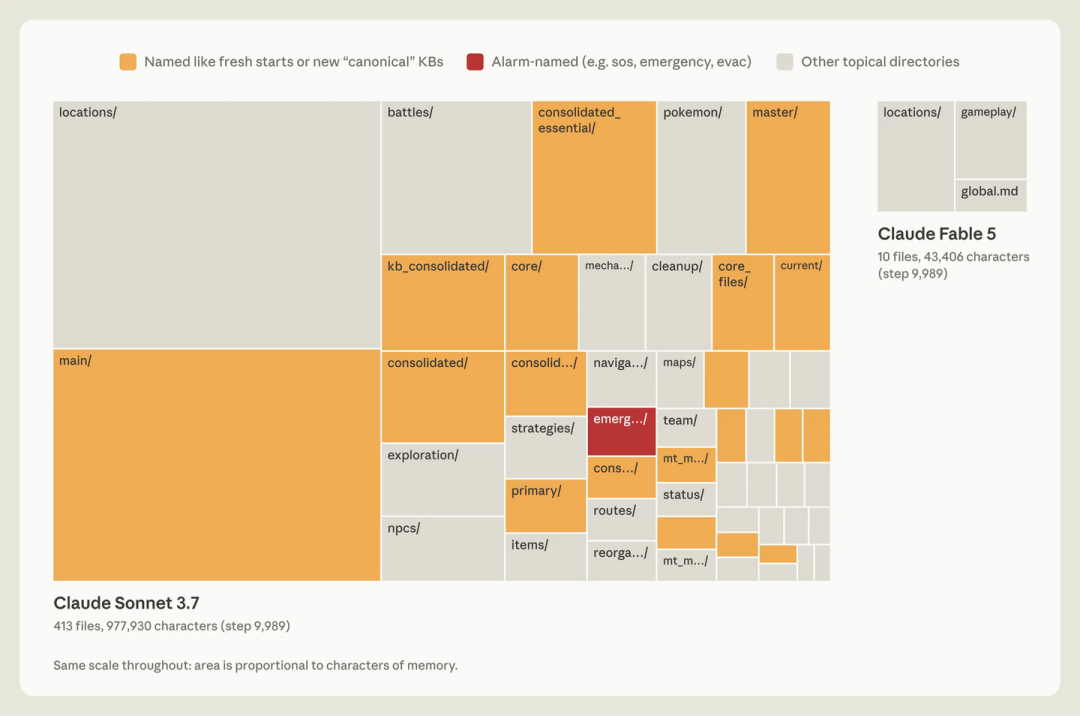
Anthropic让Claude玩《宝可梦红》:Sonnet 3.7写了413个记忆文件、225个文件夹,只拿到1枚徽章;Fable 5只写9个文件、2个文件夹,加一个global.md,拿到4枚徽章;Opus 5.5用一小份“当前目标+下一步”笔记,通关了。
 Notes
差别不在记性,在判断什么值得记。
每回合都能从屏幕读到的游戏过程记录,存下来是冗余;真正该写的是策略、计划、验证过的规则。连续7个精灵球抓鲤鱼王失败后,Claude写下:“连续失败3次就改变时机,在菜单步骤间多按等待。”
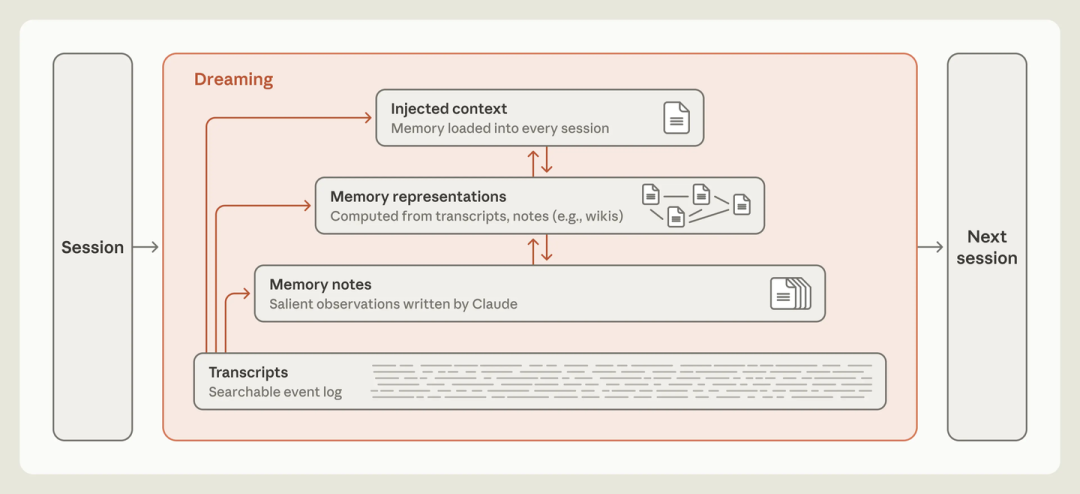
Anthropic把这种跨会话保留、以文件或存储形式存在的外部知识叫“agent memory”。这个记忆不是改权重、不是单次对话里的上下文学习(In-Context Learning),也不是压缩摘要。它应该是一个多层的外部存储体系:
在CL-Bench 1.0里,Claude答错后要记录失败、提出理论、测试理论、写成规则。在这批模型里,Opus 5首次跑通闭环;Opus 5.5和Sonnet 5.5也能做到。但给死规则会帮倒忙:规定“只记录失败”后,Opus 5和Opus 4.7从记忆里获得的提升反而大幅缩水。更好的做法是告诉它记忆是用来干什么的,把“什么值得记”的判断留给模型。
We've found that it helps to tell Claude what memory is for, but not how to use it.但这个规则仅适用于高智能的前沿模型。对老模型还是需要加强引导,比如:对 Sonnet 4.6,只加一句“先读记忆、再测试你的理论”,基准分数几乎翻倍。
DreamingKierkegaard说,人生只能回首理解,但必须向前生活。Agent记忆也一样:工作时捕获记录,空闲时“dreaming”回看日志、纠错、重组、建索引。
https://research.google/blog/the-sleep-framework-a-new-way-for-llms-to-retain-knowledge-in-continual-learning/Claude 曾把宝可梦中心的方位记错,导致三次掉下单向悬崖;dreaming 拿记录对照原始会话,改掉错误笔记后,它到了华蓝市。
Dreaming 也能把记忆组织成 wiki:在Stainless约35万文件、4.2亿token的语料上,dreaming从2个会话开始,最终整理了128个。使用Wiki,25个问题的评分从13%升到48%;搜索+wiki从54%升到61%,每题还省约2万token。但是,使用Wiki是否有用取决于具体问题,如果答案只在单文档里,或wiki膨胀到和源文件一样大时,收益就没了。想象一下博尔赫斯的小说里,那张和帝国一样大的地图。
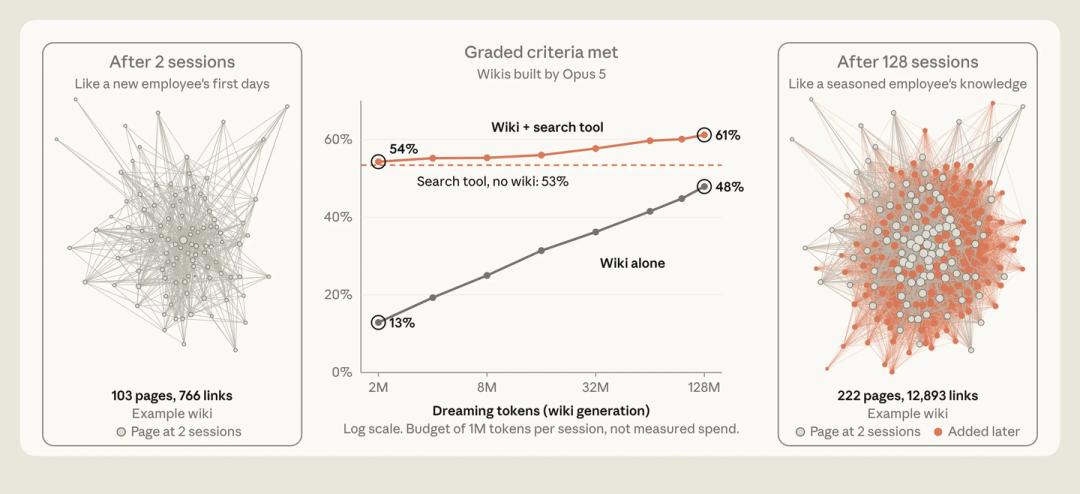
用Agent建立Wiki的做法,很像是Karpathy的个人知识库:
如何评价Karpathy提出的个人知识库的架构?Injected Context记忆要发挥作用,还是要放到Context里面。Context空间非常宝贵,所以放入的内容要精挑细选,要克制:正确的、最新的、和任务相关的。对大部分内容,用索引和指针来实现渐进式展开。
所以,agent记忆的关键不是事实,是判断力。先决定什么值得预测,再决定什么值得记住。
链接:
https://www.anthropic.com/research/components-of-agent-memory
https://platform.claude.com/cookbook/managed-agents-cma-dreaming-with-a-dynamic-workflow
当前文章无评论,是时候发表评论了