










12
11
AI时代存储革命:HBM4、HBF登场,存储不再是算力配角
2026-09-18 22:18:23
0点赞
0收藏
0评论
导语
AI大模型爆发之后,行业发现真正的瓶颈不是GPU算力,而是数据搬运速度。大模型训练、推理需要海量数据实时读写,传统内存与硬盘之间的巨大鸿沟,正在催生全新存储架构。2026年,HBM4量产、HBF高带宽闪存方案亮相,存储芯片从硬件配件升级为AI系统的核心一环,同时存储芯片涨价,也会传导到手机、电脑、服务器的终端售价。
一、HBM4:高端AI算力的刚需内存
HBM高带宽内存,是AI显卡/AI芯片配套的专用堆叠内存,它把多层DRAM垂直封装在一起,带宽远超普通DDR内存。
2026年HBM4正式量产,相比上代HBM3E,带宽提升约2.3倍,能效优化20%以上,堆叠层数最高到16层,单颗最大容量48GB。
1. 核心价值:大模型训练时,GPU需要频繁读取权重参数,HBM超高带宽,减少数据等待,释放GPU算力。微软测试显示,很多AI服务器因为存储瓶颈,GPU只能发挥20%的理论性能。
2. 供需现状:HBM产能极度紧张,三星、SK海力士、美光的2026全年HBM产能,几乎被头部云厂商、AI芯片企业长期订单锁定。
3. 迭代路线:HBM4E已经进入样品阶段,预计2027年落地,会引入EUV工艺与混合键合技术,进一步提升堆叠密度。
通俗比喻:GPU是计算的大脑,HBM就是放在大脑手边的超级记事本,读取速度极快,但容量有限、价格昂贵。
二、HBF高带宽闪存,填补HBM和SSD之间的空白
HBM很贵,容量有限;普通SSD容量大,但带宽不足。SK海力士联合闪迪推出HBF高带宽闪存,专门填补两者中间的存储缺口,计划2026下半年出样品,2027年商用落地。
HBF借鉴HBM的堆叠封装思路,把NAND闪存多层堆叠,主打超高读取带宽,成本远低于HBM,容量是HBM的8~16倍。
- 适用场景:AI推理场景里的KV缓存、RAG检索知识库。这类场景读取多、写入少,不需要HBM极致低延迟,但需要巨大容量。
- 三层存储架构成型:
1. HBM:存放实时计算参数,超低延迟,价格最贵
2. HBF:存放大模型知识库、KV缓存,大容量高读取带宽
3. 普通SSD:存放冷数据、原始素材,成本最低
三、QLC闪存逆袭,企业级SSD迎来新定位
过去大家对QLC的印象是寿命短、性能弱,只适合消费级大容量仓库盘。2026年行业风向反转,QLC SSD大规模进入AI推理服务器。
TrendForce预测,2026年企业级QLC SSD渗透率达到30%。
优势:存储密度高,单位GB成本更低,读取性能优秀,功耗更低,非常适合AI检索、向量数据库这类读多写少场景。
局限:写入耐久度依旧不如TLC,不适合频繁大量写入的业务,所以不会完全替代TLC。
消费端影响:PC、笔记本大容量SSD会越来越多用QLC,价格继续下探;但重度写入用户,依旧优先TLC。
四、存储涨价,终端设备价格承压
AI服务器疯狂采购存储芯片,挤压消费级DRAM、NAND产能。2026年Q3,DRAM合约价环比上涨13%-18%,NAND闪存环比上涨10%-15%。
存储涨价会层层传导:
1. 云厂商:服务器成本上升,算力租赁价格上调。
2. PC、Mac、手机:内存、闪存采购成本上涨,未来新品定价面临上调压力。苹果已经和三星重新谈判2027年内存闪存采购价格,采购价明显上涨。
五、普通人怎么看懂变化,选购设备避坑
1. 消费电脑:普通办公、影音,QLC大容量SSD够用;剪辑、本地跑大模型,优先TLC固态。
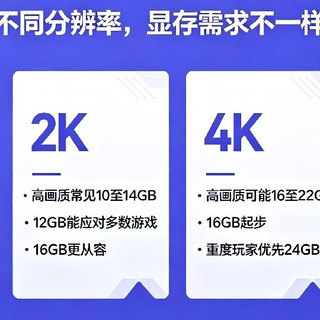
2. 内存:跑本地端侧AI大模型,优先更大容量内存,内存带宽直接影响模型加载速度。
3. 不要盲目追求HBM:HBM只在AI服务器、高端专业算力卡上使用,普通家用电脑不会搭载HBM。
六、未来趋势总结
AI重构存储的底层逻辑,不再简单追求单颗芯片速度,而是分层存储架构,不同数据放在不同层级存储硬件。
HBM负责高速计算,HBF承接大容量知识库,QLC SSD承载海量冷数据。存储芯片已经成为AI算力的核心瓶颈,未来几年,存储技术迭代速度,甚至会决定大模型落地的上限。
同时存储涨价周期持续,手机、电脑的大容量版本,未来很难再持续降价。










