











8
5
RTX 3060 6GB 跑 Qwen-Image 2.1:40 步等了 40 分钟
2026-10-03 17:41:22
0点赞
1收藏
0评论
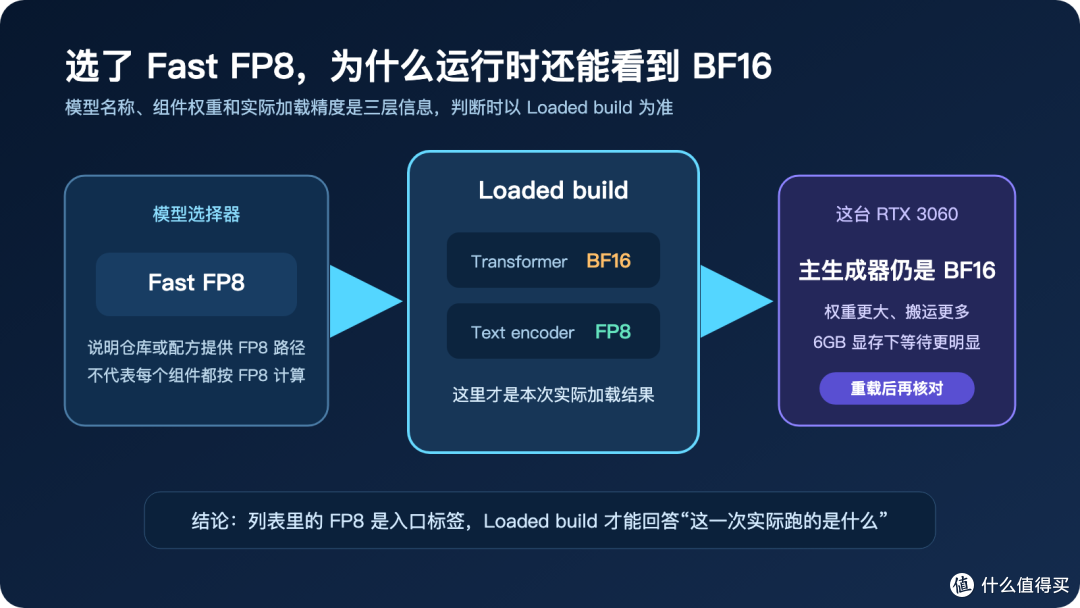
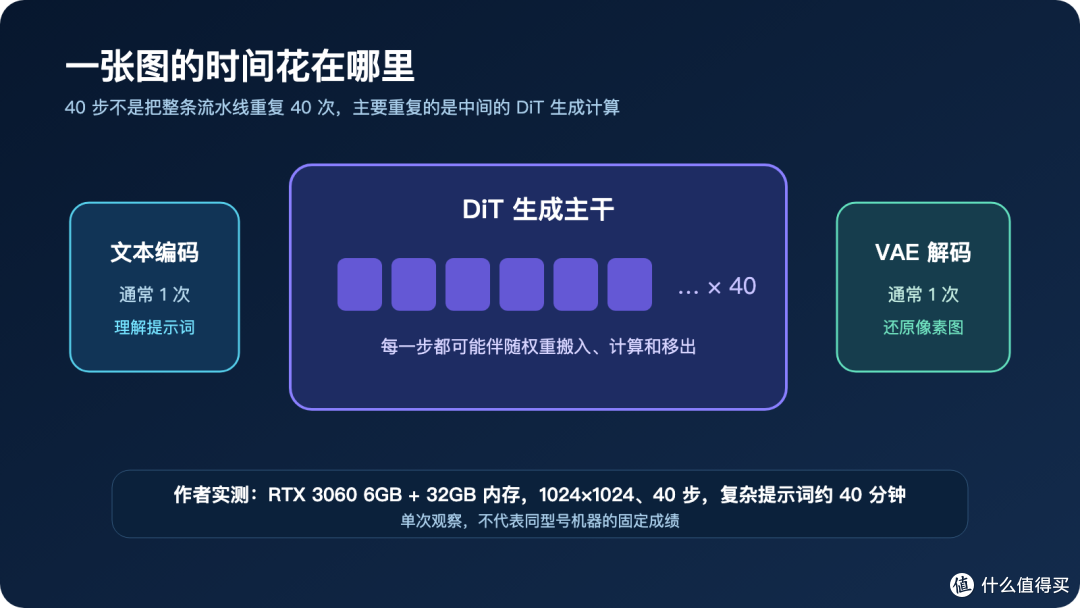
如果你看到模型列表里的 “Qwen-Image 2.1 Fast FP8”,很容易产生一个直接判断:FP8 体积更小,RTX 3060 6GB 应该也能比较轻松地跑。我的实际结果要复杂一些。 我用 Unsloth Desktop 在 RTX 3060 6GB、32GB 系统内存的电脑上完成了生成。分辨率是 1024×1024,Steps 设为 40,Guidance、Batch size 和 Runs 都是 1。复杂提示词生成一张图大约用了 40 分钟。它确实能跑,等待时间也确实很长。 再看高级设置里的 Loaded build,主生成器显示 BF16,文本编码器显示 FP8。也就是说,模型入口带着 FP8 标签,这次真正反复计算的 Transformer 仍按 BF16 加载。这个细节既解释了等待时间,也决定了这套配置适合谁。
先说结论:旧显卡能体验,高频出图别高估它 如果手里已经有 RTX 3060 6GB 和 32GB 内存,想学习本地图片模型、偶尔生成封面或验证提示词,Qwen-Image 2.1 值得尝试。模型下载后可以留在本机,工作流、版本和素材处理方式也能自己控制。 如果每天需要反复修改几十张图,40 分钟一张显然不够实用。此时优先考虑更大显存、确认量化真正生效,或者继续用云端服务。低显存方案解决的是“装得下”,速度还受 GPU 算力、系统内存、PCIe 搬运、Attention 后端和客户端版本影响。 这篇文章只把我实际跑到的配置和官方资料放在一起分析。没有做 BF16、INT8、FP8 的同种子完整横评,也不会给出固定加速倍数。 为什么一个 7B 图片模型还要三个组件 Qwen-Image 2.1 的视觉生成主干是 7B,但生成一张图还需要文本编码器和 VAE。它们可以理解成一条三人流水线。 • Qwen3-VL 8B 编码器负责读懂提示词和参考图,整理主体、颜色、位置等条件; • 7B DiT 负责反复修改潜变量,主要的绘图计算发生在这里; • RGBA VAE 负责把压缩状态还原成可以打开的像素图片,并支持透明通道。
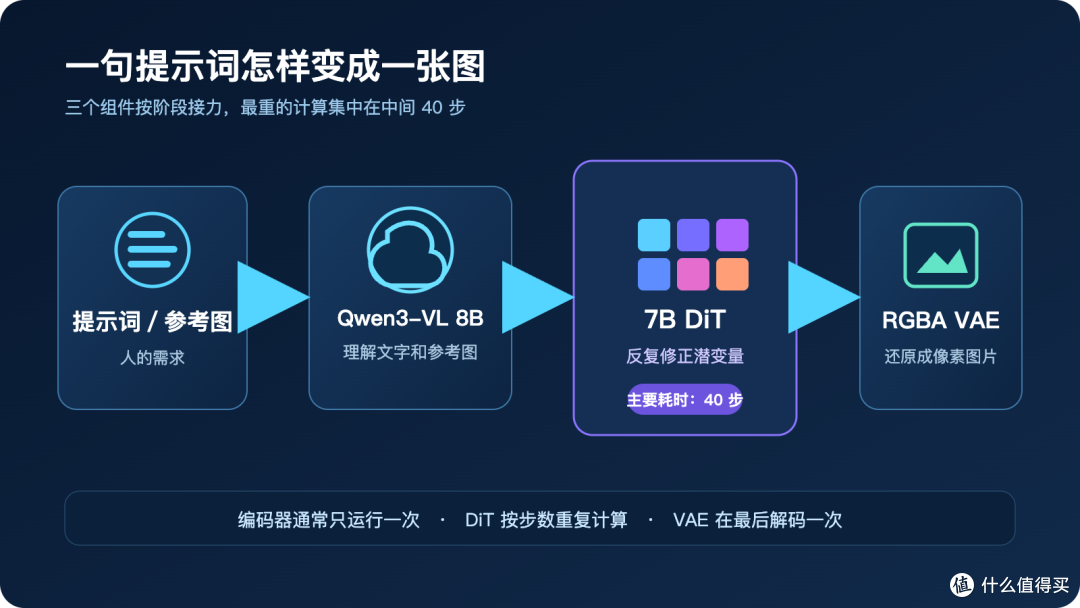
文本编码器通常在前面工作一次,VAE 在结尾解码一次。中间的 DiT 会跟着 Steps 重复计算。40 步意味着最重的一段大约执行 40 轮,所以把 Steps 从 20 增加到 40,等待时间通常也会明显增加。
官方还提供提示词重写模型,可以把短提示扩写成更完整的构图和光线说明。它属于可选前处理,低配机器没必要一开始就把所有可选组件都装上。先让基础三段式流程稳定完成,更容易定位问题。 6GB 显存怎样放下十几 GB 的权重 7B 表示大约 70 亿个参数,不等于文件只有 7GB。BF16 每个参数大致占 2 字节,70 亿参数仅权重就接近 14GB。Unsloth 公布的兼容权重中,DiT 的 BF16 版约 14.23GB,INT8 版约 7.26GB;Qwen3-VL 文本编码器的 BF16 版约 17.5GB,FP8 版约 9.39GB。 6GB 显存无法把整套管线一次放进去。Streaming Offload 和 CPU Offload 会把暂时不用的权重留在系统内存,只将当前计算所需部分搬进显存。
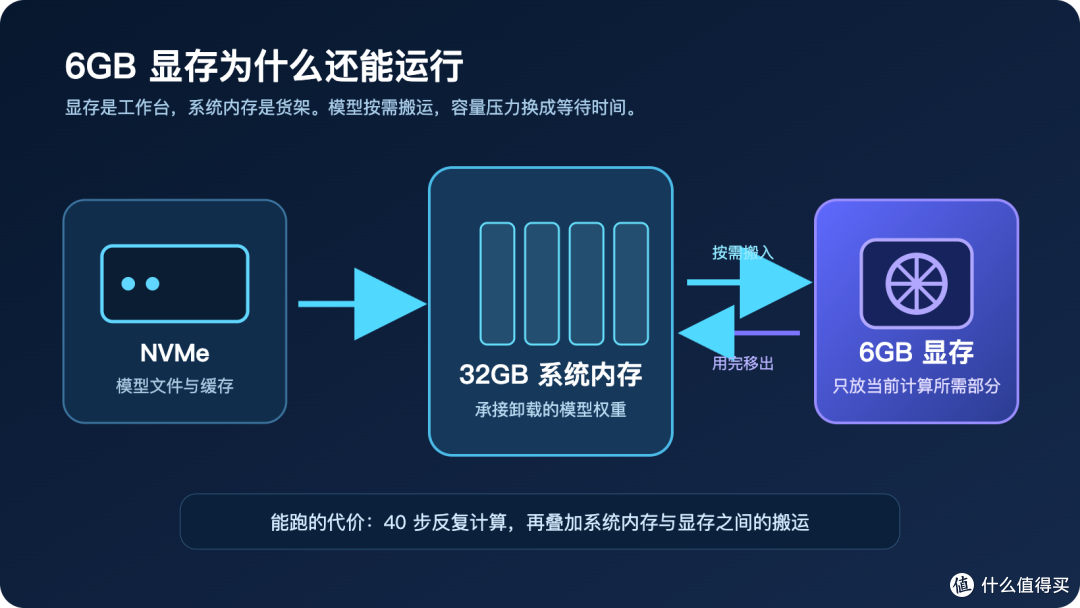
把显存看成工作台,32GB 内存看成旁边的货架,就容易理解了。工作台小,可以分批完成任务;每画一段就要搬一次工具,传输带来的等待也会累积。我的 40 分钟同时包含 40 步计算和低显存环境下的搬运开销。 Unsloth 官方文档目前明确写到,FP8 可以借助 Offload 在 6GB 显存上运行,同时提醒用户准备足够的系统内存。文档里的内存数字是估算起点,并非所有机器都能达到的最低值。我的单次结果也不能替代官方测试或其他用户的成绩。 Fast FP8 与 Loaded build 为什么会对不上 模型列表里的 Fast FP8 表示仓库或配方提供 FP8 相关权重。实际管线由多个组件组成,客户端还会按显卡能力和自动策略决定如何加载。某个组件可以是 FP8,另一个组件仍然可能是 BF16。 RTX 3060 的 Compute Capability 是 8.6。NVIDIA 的官方计算能力表可以确认它属于 Ampere;原生 FP8 Tensor Core 出现在更新的架构上。对于这张卡,看到 FP8 模型名称时,不应直接把它理解为整条推理链都会获得原生 FP8 加速。 更可靠的检查方法是:修改 Precision 或 Memory 设置后重新加载模型,再看 Loaded build。如果 Transformer 仍显示 BF16,主生成器权重和搬运压力就没有按预期降到 INT8 或 FP8。我的界面正是这种情况。 Unsloth 公布的同种子量化对照里,INT8 的 DiT 文件约 7.26GB,FP8 约 7.12GB;该测试中 INT8 的 LPIPS 均值更低。它说明 INT8 是这条官方兼容路径里值得优先验证的选项,无法证明每个提示词下 INT8 都更好。 6GB 显存从这组参数开始更稳妥 Unsloth 针对 GPU / Diffusers 路径给出的基线是 40 步、Guidance 1、1024×1024、Batch size 1,并建议首次使用固定 Seed 做对照。结合我的等待时间,我会按下面顺序调整。
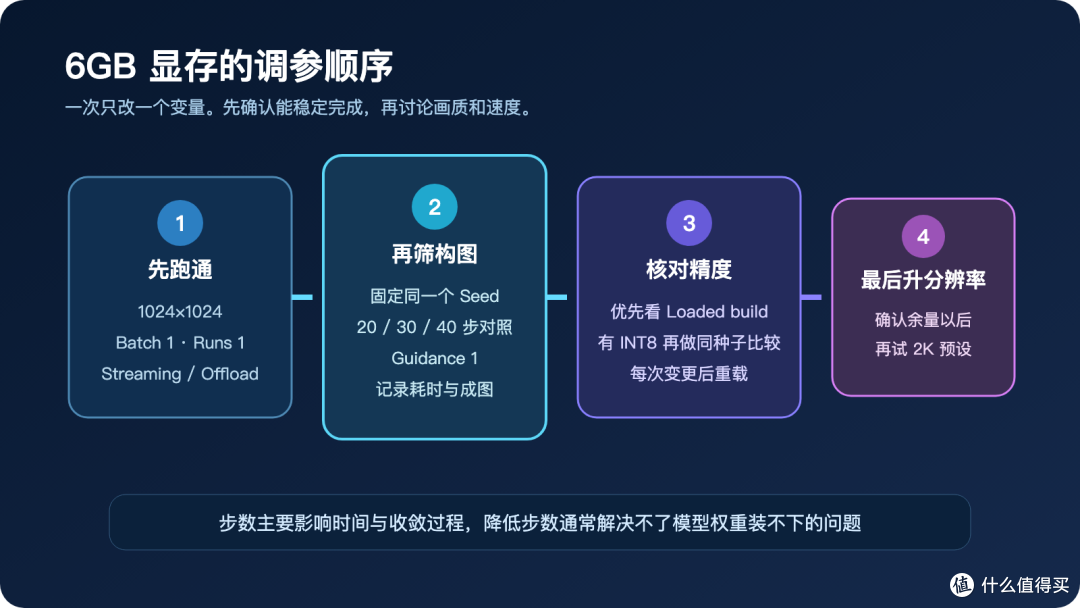
1. 分辨率先保持 1024×1024,Batch size 和 Runs 都设为 1; 2. Memory 使用 Low VRAM 或 Streaming,CPU Offload 保持启用; 3. 固定同一个 Seed,分别跑 20、30、40 步,比较耗时和细节; 4. 重载后检查 Loaded build,界面提供 INT8 时优先验证 INT8; 5. 只有 1024×1024 稳定以后,再尝试 2K 预设。 减少 Steps 主要缩短 DiT 重复计算的次数。它可能让细节还没充分收敛,也通常不能解决模型权重装不下的问题。显存不足时,应优先处理分辨率、Batch size、量化和 Offload;想加快草稿筛选时,再降低步数。 参数比较时固定 Seed 很重要。随机种子每次都变,画面构图也会跟着变,很难判断差异到底来自步数、精度,还是随机性。我的 40 分钟数据没有完成整套对照,所以只记录为一次真实观察。 Qwen-Image 2.1 值得折腾的地方 Qwen 官方列出的改进包括:原生 2K、透明 RGBA、最多 10 张参考图、局部编辑,以及对图片文字、人物光线和纹理的增强。开放权重让它可以进入本地固定工作流,这也是它与只能通过在线服务使用的图片模型之间最直观的差别。 本地部署同样有成本。官方完整 BF16 仓库约 33GB,量化包还会带来额外下载和缓存;低显存需要系统内存与硬盘配合;模型许可证也要单独阅读。Qwen-Image 2.1 使用 Qwen Research License,准备商业使用时应先核对授权条件。 我的判断很明确:已有 RTX 3060 6GB 和 32GB 内存,可以把 Qwen-Image 2.1 当作学习、测试和低频出图工具,不必为了“能不能启动”立刻换显卡。要把它当高频生产工具,就应先确认 Transformer 的量化实际生效,再看等待时间能否接受。若每天都要大量迭代,更大显存或云端服务会省下很多时间。 你如果也在低显存机器上运行,建议一起记录 Loaded build、分辨率、Steps、Seed 和单张耗时。只写“FP8 模型很快”或“6GB 可以跑”,都不足以让不同机器的结果真正可比。 资料说明:产品能力、推荐参数、权重大小与硬件架构于 2026 年 10 月 3 日按 Qwen、Unsloth、Hugging Face 和 NVIDIA 官方资料复核。文中本机体验只包含作者明确确认的配置与耗时。五张正文图为自制原理图,未使用客户端私人截图。原博客已经公开,不申报全网首发或独家。 参考资料:Qwen-Image 2.1 官方介绍、Unsloth 本地运行指南、Unsloth FP8 / INT8 权重说明、NVIDIA CUDA GPU 计算能力表。
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~





