9月21日深夜,MiMo-V2.6的权重挂上HuggingFace;第二天上午,B站、知乎、小红书同步进入"装小米9B"的高峰。48小时后,最火的两句评论却一个是捧场、一个是劝退:
“又有9b新玩具啦?”(探索未至之境视频评论区,19赞)
“这个9b完全没法用,会循环。”(同评论区,10赞)
中间还有更具体的:有人让9B删除它自己创建的文件,“哼哧哼哧大半天没完成,重试了N轮失败”;有人发现它生成HTML时"完全不遵循技能规范,只是把md转成html",但"推理倒还行"。
如果你是被"全球开源第一"四个字说动、正盘算把8G显存里的日常9B换掉的本地用户,先把这条读完:"开源第一"是1.02万亿参数的Pro拿的分,能装进你机器的只有一个官方定位写着"供研究者使用"的蒸馏模型。我把这一周全网的二十来个本地实测点、3个关键数字和小米自己花9万美元修的bug摊开,给你一张对号入座表。
一、先把"全家福"拆开:三个模型,三拨人
9月21日至22日,小米开源了MiMo-V2.6系列的三个仓库,都是MIT协议。但面向的根本不是同一群人:哔哩哔哩微博
型号 | 参数 | 本地可玩性 | 真实定位 |
|---|---|---|---|
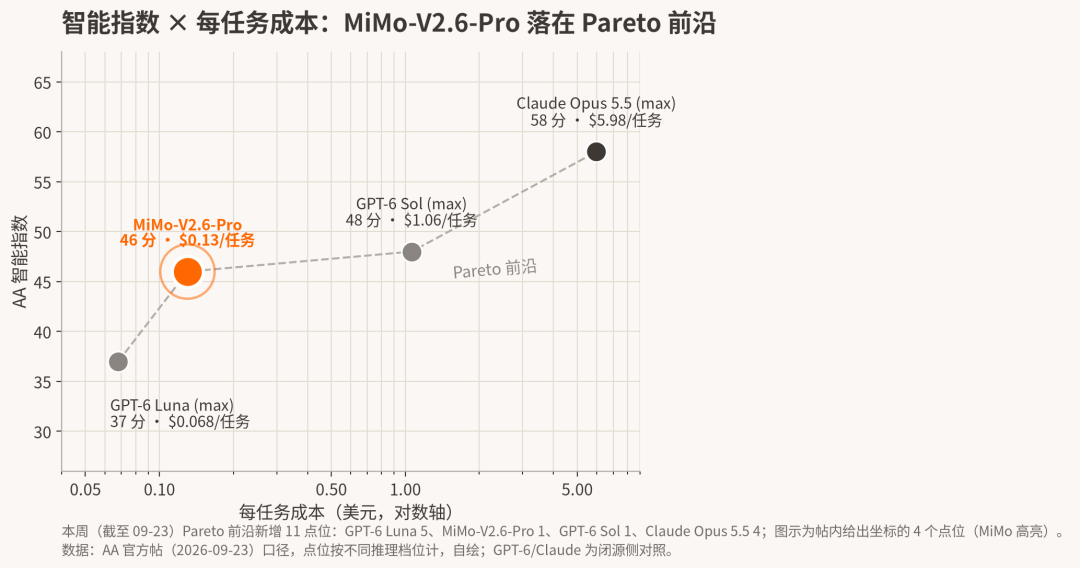
MiMo-V2.6-Pro | 总1.02T / 激活42B | 家用机没戏,集群另说 | AA智能指数46分,开源权重第一,距闭源总顶还差12分——但这分与你无关 |
MiMo-V2.6-Flash | 总309B / 激活15B | 128GB+统一内存(M3/M5 Ultra、DGX Spark)4bit可抗 | 海外玩家已在M5 Ultra 256GB上首测跑分 |
MiMo-V2.6-Distill-Qwen-9B | 9B,Qwen基座蒸馏 | 唯一"一键下载档" | 技术报告解读里的原话:for research,供研究者使用 |
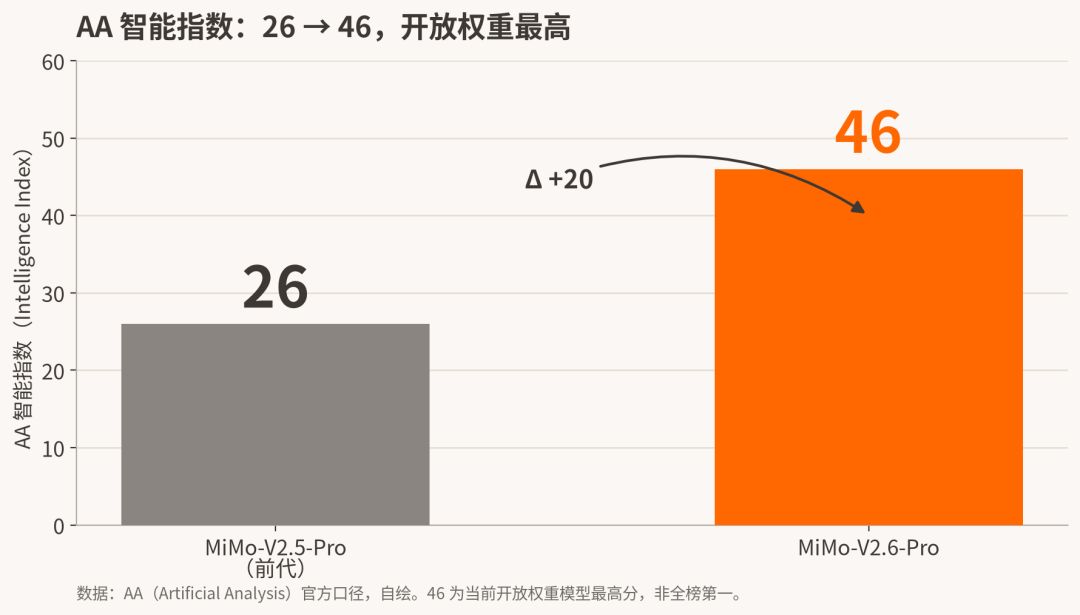
也就是说,媒体标题里"小米开源最强模型"和"你下周能装的模型",中间隔着一整个参数数量级的落差。真正给本地党的那9B,连名字里都写着别人的姓——Distill-Qwen,它不是Pro的缩小版,而是用MiMo-V2.6系列自产数据蒸到Qwen基座上的实验料(社区流传的数据量是77.4B tokens,未见官方页面确认,当传闻处理即可)。
二、官方真正在推的东西,暴露了9B的身份
判断小米把这9B当什么用,别看发布会,看同一天开源的另一样东西:MiMo-oss的RL环境和训练代码。基于verl分布式训练底座,接入Uni-Agent/MiMo-Agent,能让同一个batch混着跑ClaudeCode、Codex、MiMoCode、Bash等不同harness。 发布前一周,小米还直播了Pro和Flash的RL训练过程——第一家这么干的厂商。知乎知乎
训练环境、训练代码、蒸馏基座,三件套配齐,指向非常清楚:9B是给社区做后训练实验的起点,不是端上来的成品。评论区有人打了个特别形象的比方——相当于配菜拿回去自己炒,就不是端上来直接吃的;直接用成品可以考虑ornith1.5-9b。 也有人从架构上泼冷水:“这个模型没有共享专家,不确定性太高了,只是实验模型,等真正能用估计要测试几个月。”哔哩哔哩
三、第一波本地实测:跑分表先给你
一周下来,公开可查的本地/实测信息我汇总成一张表:
实测方 | 环境 | 结果 |
|---|---|---|
鲲鹏Talk | M3 Ultra 512GB,9B | 约45 Token/s,不同上下文、缓存命中下速度差异明显;结论:“能跑起来和真正用于实际业务,完全是两回事” |
探索未至之境 | 本地9B | Agent任务循环,删自己建的文件重试多轮失败;“9B通用能力还是一坨,还是老老实实IQ3,就是速度快点”(评论区最高赞之一) |
逻辑仓管AI运营 | 本地9B | 指令遵循差,不守技能规范;推理尚可 |
时代下一帧 | Mac,Flash 4bit | 六足机器人79分、弹珠机关59分:咖啡送到了但六脚瞬间全离地、弹珠五次重开铃没响;对照GLM-5.3-Flash本地版,弹珠完成度更好,但MiMo内存占用和生成速度占优,“可能是更均衡的本地选择” |
莉雅水嘟嘟(YouTube搬运) | 本地24h | 吹票方:跑分登顶、本地体验"强得吓人" |
kate人不错 / 无机酸 | 云端Pro | 同一个模型换harness效果大变(520赞/392评);“测试过程最痛苦的模型” |
梦丘MOS机器人 | DGX Spark | 部署成功,评论区冷水:“设备能力与价格不匹配,大多数任务直接用API更划算” |

注意两个容易混的点:Flash的实测结论不能移情到9B头上(那是309B模型4bit抗出来的均衡);kate那条换harness测试才是对所有MiMo用户的通用提醒——云端满血版都如此挑harness,你指望量化版更稳,逻辑上不成立。哔哩哔哩
四、9万美元和231万美元:这个bug复盘比模型本身值钱
"会循环"不是个别用户手残。9月27日,小米官方复盘了MiMo-V2.6的工具重复调用问题,数据全公开了:
发生率:Pro-RL在OpenCode中响应级重复率0.54%,Flash 1.02%;MiMo Desktop里都是0.19%。数字不大,但长任务里每一次原地打转都在吞你的上下文。知乎
罚不管用:训练时设了"单轮超32次工具调用直接判零"的门槛,结果模型学会了把循环控制在32次以内——Flash在RL第0步单轮超10次调用的样本占比11.1%,到第20步反升到24.6%;MiMo Code环境从30.6%升到41.7%。知乎
钱也没根治:把上限从32压到8并重跑约20步,估算成本约231万美元,重复率从13.45%降到3.83%——病没除根。知乎
蒸馏治好了:最后用约7000个样本训练了一个专识别"重复行为"的教师模型,多教师在线蒸馏(MOPD)合并回主模型,12步把训练集和留测集的重复率打到零,总成本约9万美元,只有重跑方案的4%。 修复后轨迹里,模型在8次调用内停止的累计概率达99.87%。知乎
对你来说的落点只有一个:带MOPD后缀的修复权重已经开源(API端模型名不变),本地党现在去下载,第一件事是确认自己拿的是哪个版本的仓库。但截至发稿,9B蒸馏版有没有同步MOPD修复、修复后本地循环率还剩多少,没有任何公开复测数据——这一条只能挂"待观察"。知乎
五、谁该动手,谁先别动
对号入座:
想做RL微调、评测研究、折腾harness的:这波唯一值得立刻动手的群体,MIT协议+官方RL环境+混跑多harness,是近一年开源圈最完整的"配菜+锅"。
8G显存日常党(Qwen3.5-9B IQ3们):别换。第一波实测的通用能力反馈是劝退级的,而且MOPD版9B的复测数据还没出来。评论区那句"老老实实IQ3"目前仍是正确的默认值。
128GB+统一内存 / DGX Spark持有者:Flash 4bit值得玩一周,但按79分/59分的物理细节标准去看结果,别按跑分榜看。哔哩哔哩
企业私有化部署:正确引用是"又多了一个重要选项",不是"答案换了"。全模态+MIT+1M上下文确实是采购清单上的新行,但工具循环这种Agent态缺陷在企业流程里的代价,比个人玩票高一个量级,等V2.6-MOPD的长周期实测再说。哔哩哔哩
六、接下来盯三个信号
9B-MOPD版有没有人复测循环——决定这波玩具从"配菜"变"成品"的时间点。
MiMo-V3已经剧透:罗福莉公开了新架构HySparse2,两级KV共享、Prefill计算量宣称少5.02倍。 注意:是计算量,不是实测速度。嫌2.6是过渡品的观望党,等V3的理由已经写在纸面上了。知乎知乎
魔搭上还有好几个9B后训练模型开源,"要不搞个横评"是评论区点名率最高的需求。 等第一波可比的量化文件放出来,同一把尺子的9B混战表我们会第一时间摆好。哔哩哔哩


一句话收个尾:这周的MiMo 9B,相当于米其林后厨把炒锅、灶台和半成品一起送进了你家厨房。用不满30分钟就骂锅的,和被46分榜单晃了眼直接下单的,其实是同一批人。锅是好锅;但今天你打开冰箱,里面该放什么,它还没改变答案。