

哈喽小伙伴们好,我是Stark-C~
这几天关注AI 领域的应该都知道这个重磅新闻吧:Meta 正式发布了人们等待已久的开源大模型 Llama 3!此次发布的Llama 3 在多个关键的基准测试中性能优于业界先进同类模型,其在代码生成等任务上实现了全面领先,能够进行复杂的推理,可以更遵循指令,能够可视化想法并解决很多微妙的问题。
根据官方的描述,它的亮点包括但不限于以下:
基于超过 15T token 训练,相当于 Llama 2 数据集的 7 倍还多;
支持 8K 长文本,改进的 tokenizer 具有 128K token 的词汇量,可实现更好的性能;
在大量重要基准中均具有最先进性能;
新能力范畴,包括增强的推理和代码能力;
训练效率比 Llama 2 高 3 倍;
带有 Llama Guard 2、Code Shield 和 CyberSec Eval 2 的新版信任和安全工具。
此次新发布的Llama 3模型以开源形式提供,包含 8B 和 70B 两种参数规模,涵盖预训练和指令调优的变体。需要说明的是,Llama的中文本土化使用起来是没有问题的,但是略有水土不服,所以很多技术玩家都会在原Llama的基础上进行针对中文使用环境的微调,从而达到了非常理想的使用效果,比如说LLama3-Chinese项目。
另外一点就是Llama作为大型语言模型,虽说免费开源并且可以部署在本地,并且部署起来还非常的简单,Docker就能搞定,但是对于本地部署环境要求非常高,需要强大的CPU以及GPU支持才可以。
而我不忘“不作死就不会死”的折腾初心,今天闲来无事,硬是在自己的NAS上将Llama 3模型跑起来了。
部署
想要使用Docker的方式在自己的NAS上将Llama 3跑起来需要两个容器的支持:
Ollama:一个开源的大型语言模型服务工具,专门用于部署和本地运行开源大型语言模型,比如今天要说的Llama 3模型。
Open WebUI:一个开源的 Web 用户界面工具,为用户提供了友好的界面来与 Ollama 平台进行交互。
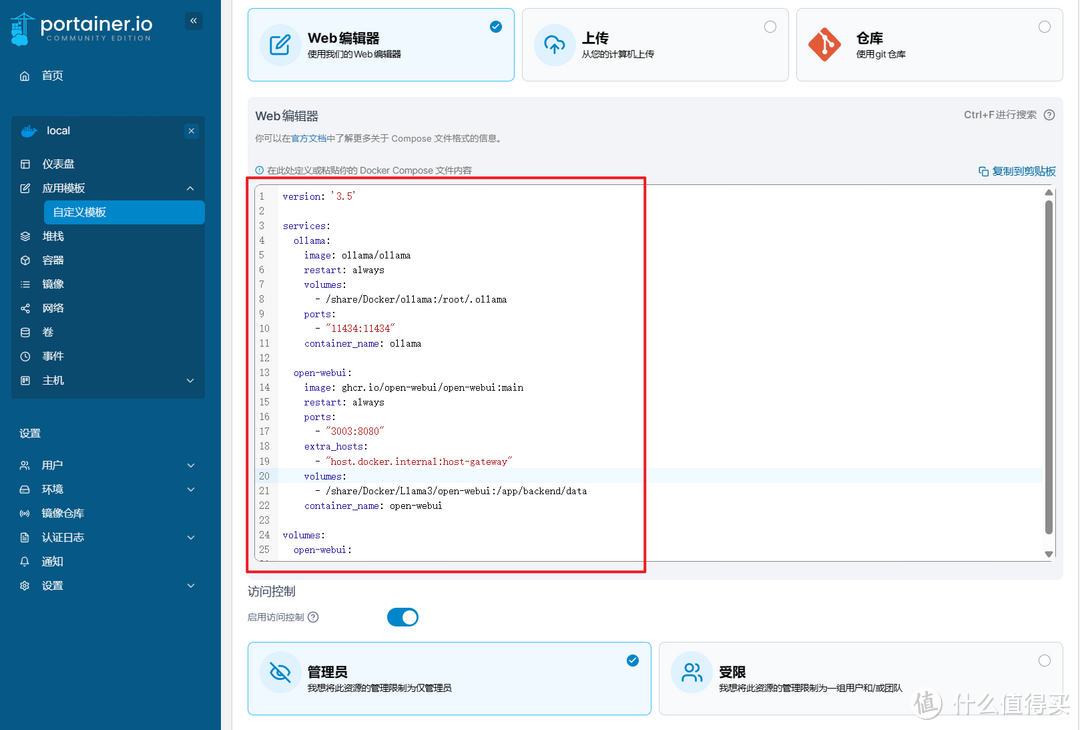
🔺一般遇到一个项目需要多个容器同时运行的时候,很明显Docker compose堆栈部署效率会更高。今天Llama 3部署的Docker Compose 文件代码为:
version: '3.5'
services:
ollama:
image: ollama/ollama
container_name: ollama
restart: always
volumes:
- /share/Docker/ollama:/root/.ollama #提前做好路径映射
ports:
- "11434:11434" #端口本地不冲突
open-webui:
image: ghcr.io/open-webui/open-webui:main
container_name: open-webui
restart: always
ports:
- "3003:8080" #端口本地不冲突
add-host:
- "host.docker.internal:host-gateway"
volumes:
- /share/Docker/Llama3/open-webui:/app/backend/data #提前做好路径映射
volumes:
open-webui:
基本上代码修改的地方不多,做好路径映射与端口映射即可。
体验
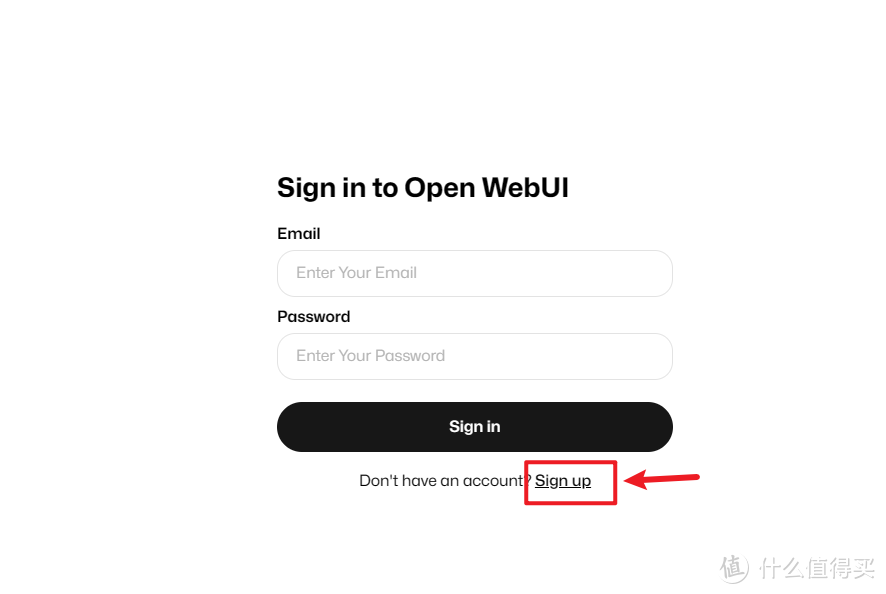
🔺部署成功后我们需要打开Open WebUI容器的WEB页面,也就是【http:// NAS的局域网IP:端口号】 就可以了。首次进入需要点击“Sign up”注册一个账号。
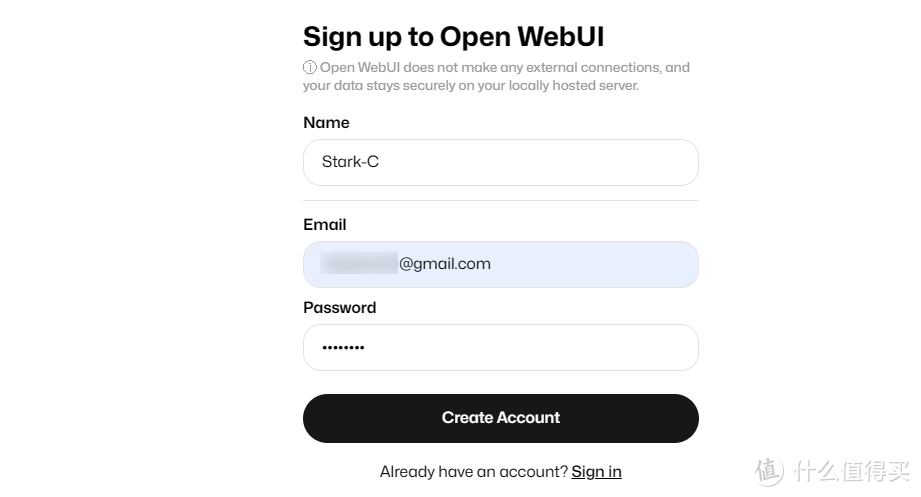
🔺注册很简单,就随意设置名称、邮箱、密码三项即可。
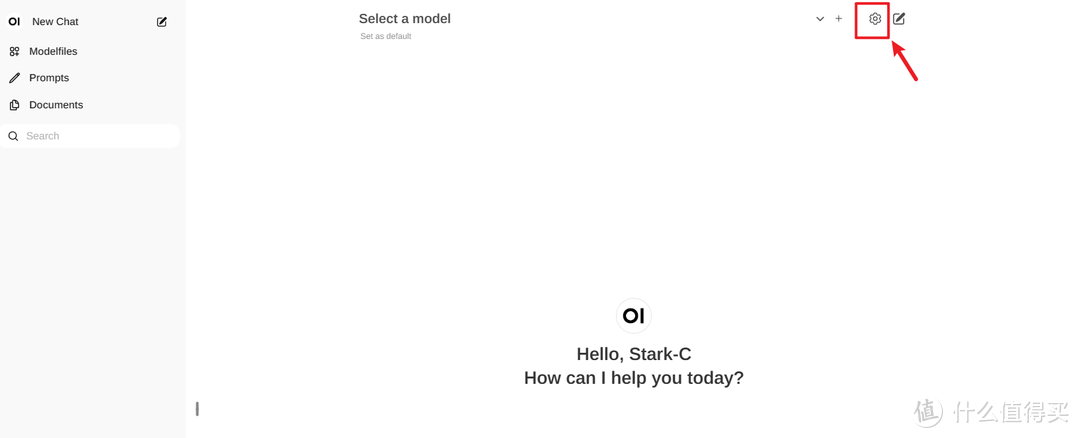
🔺进入Open WebUI后台它默认还是英文主页面,好在它是原生支持中文的。,点击右上角的“设置”按钮。
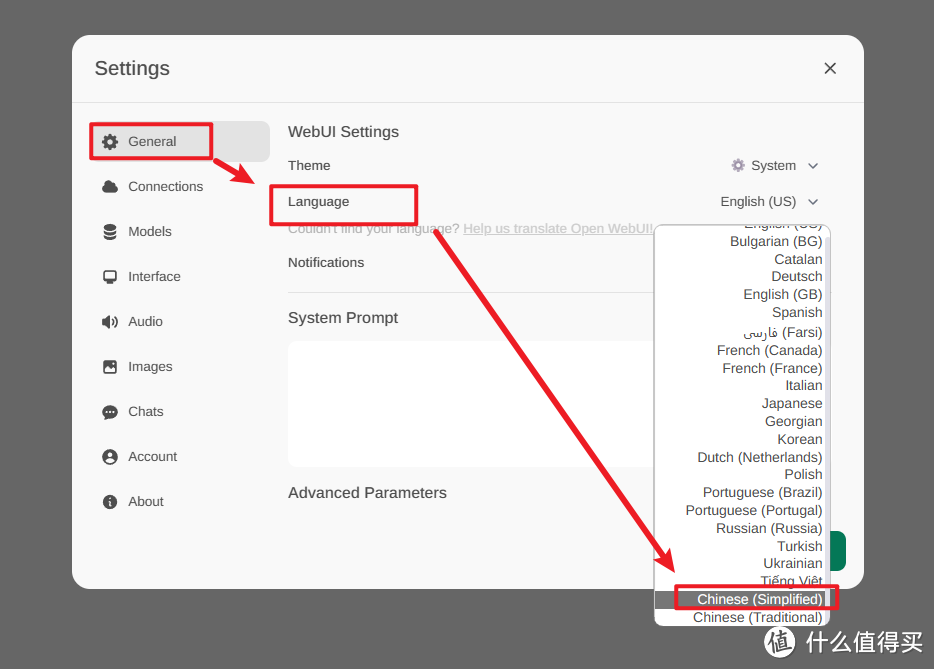
🔺根据上图提示就能轻松设置成简体中文了。
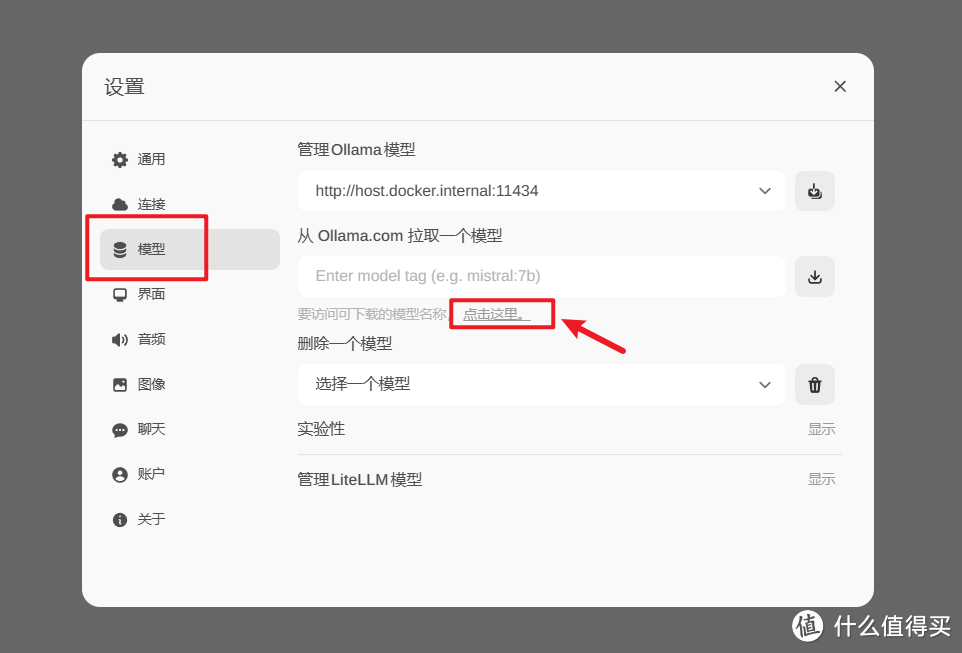
🔺接着我们就可以直接添加Llama 3大语言模型,也是在“设置”页面,选择“模型”。它会提示让你拉取一个模型,但前提是我们需要知道模型的名称。如果你不清楚可以点它给出的提示“点击这里”。
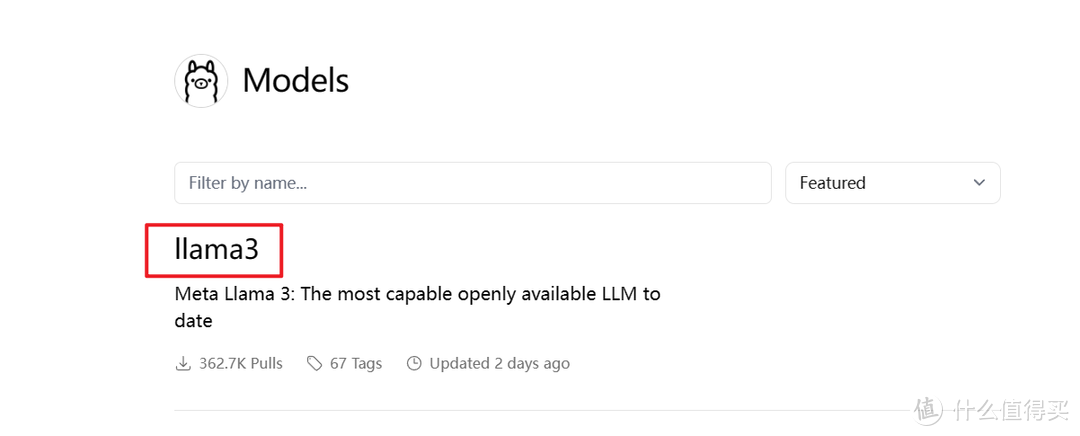
🔺然后会重新打开另一个新的页面,第一个便是Llama 3。
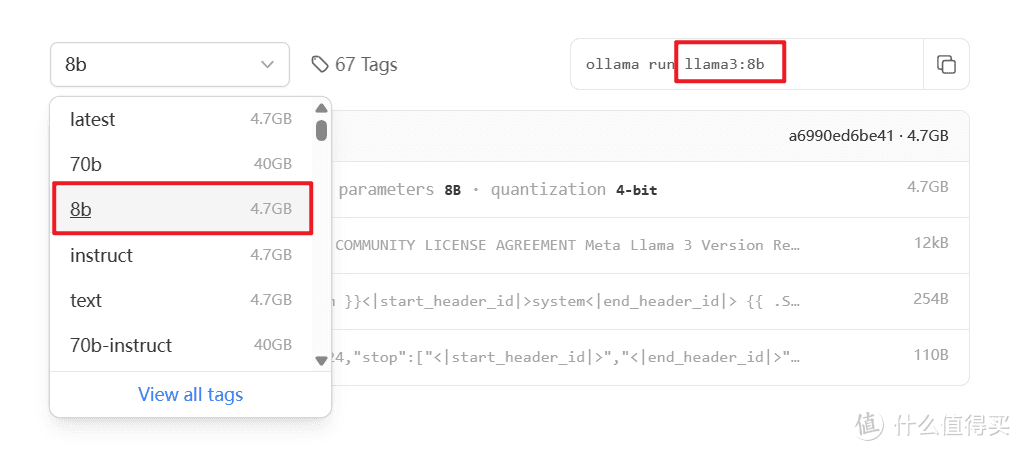
🔺进入Llama 3页面会有版本选择,以及对应的模型容量大小。我选择了容量相对小一点的“8b”,然后它对应的名称就是上图方框所示的“llama 3:8b”,我们将这个名称复制下来。
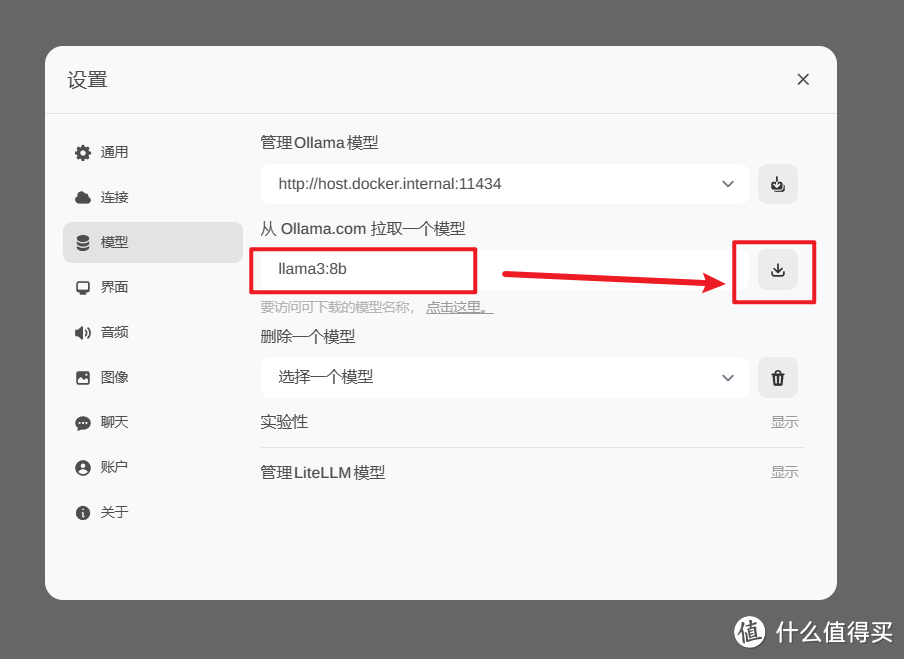
🔺粘贴到Open WebUI“设置”页面的模型这里,点“下载”图标。
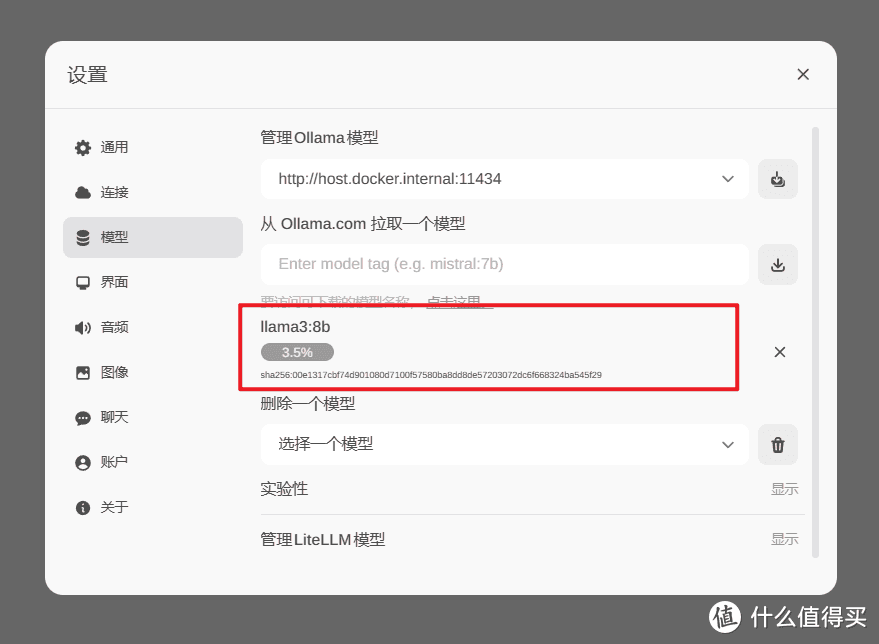
🔺它就会将模型下载到本地了,并且在下方会有一个下载的进度条显示。因为llama 3:8b模型较大,所以下载的时候可能会比较长,咱们耐心等待便是。
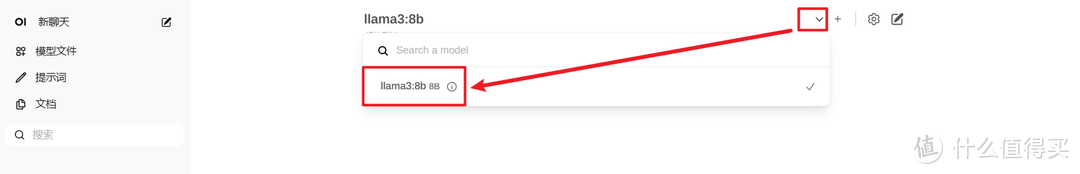
🔺下载完成后回到Open WebUI主页,在顶部位置选中我们下载好的llama 3:8b模型就可以直接使用了。
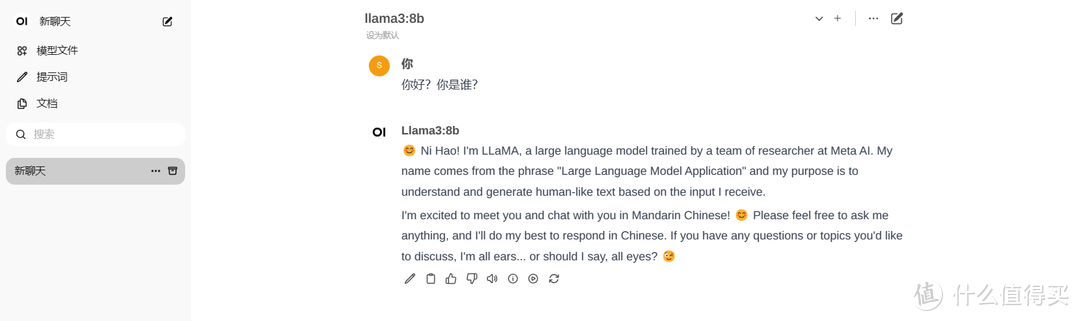
🔺我先用中文问了它是谁,足足等了三分钟它才回答我,并且还是一个单词一个单词的蹦出来,非常慢。等等,它为什么用英文回答我?
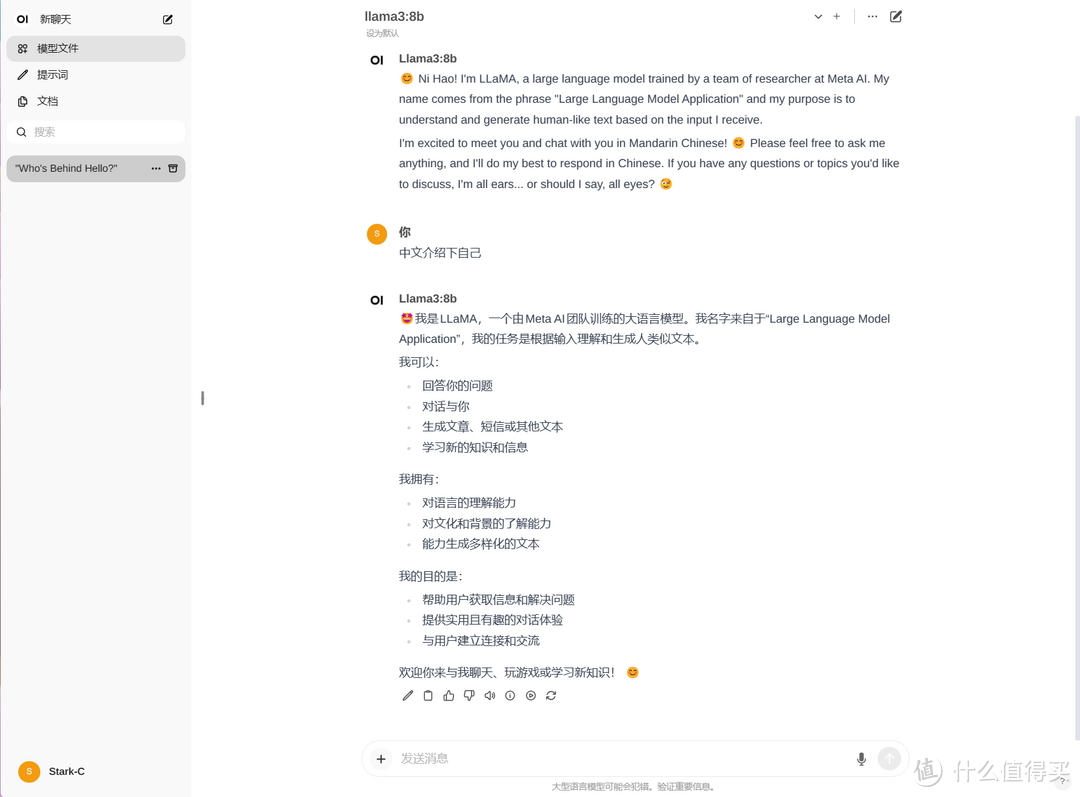
🔺接着我直接让它使用中文介绍下自己,又是等了三分钟,它才一个字一个字的蹦出了如图所示的回答。使用没问题,但是体验真的一言难尽。
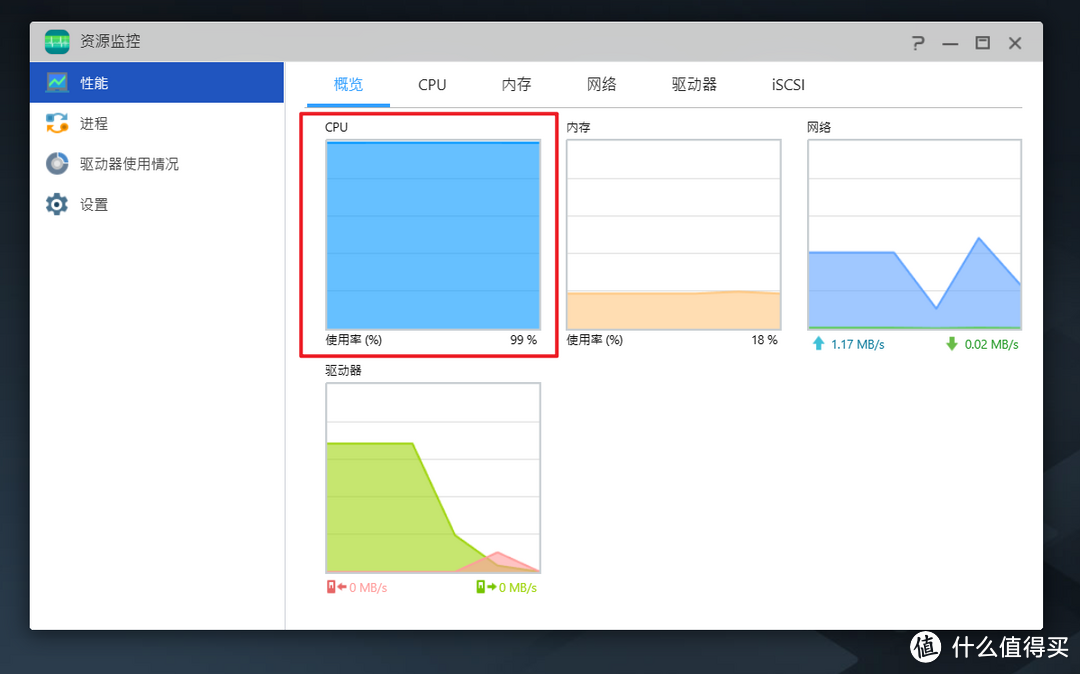
🔺在它运行过程中(也就是搜寻答案的时候),NAS风扇狂啸,CPU直接干到99%,并且还是长时间满负载。很明显是处理器到了瓶颈,影响Llama 3模型发挥了。
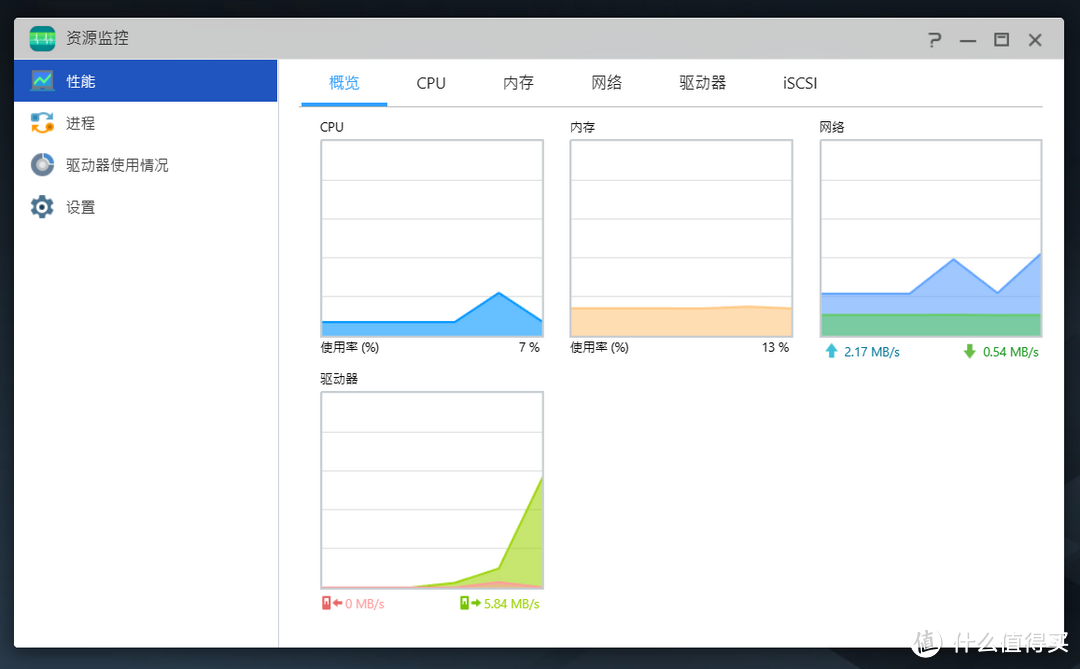
🔺当我们不运行Llama 3模型的时候,NAS处理器运行又恢复正常。
最后
本次我部署的NAS是华硕AS6704T,处理器为Intel N5105 四核心四线程处理器,这配置放在NAS上还是很能打的,不过用它来跑AI模型还是够呛,特别是Llama 3这种大语言模型,完全就不合适,所以很多玩Llama 模型的爱好者一般会将它部署在本地主机电脑上体验。
说到部署到本地电脑最近知名小主机品牌零刻上新了两款性能小主机:零刻SER8、零刻SEi14。我预计会在下周时候为大家分享零刻SEi14的开箱体验,顺便也会正在该小主机跑一下这个Llama 3大语言模型,我想到时候绝对又是另一番体验了,有兴趣的小伙伴可以关注下我最近的动态哈~
好了,以上就是今天给大家分享的内容,我是爱分享的Stark-C,如果今天的内容对你有帮助请记得收藏,顺便点点关注,咱们下期再见!谢谢大家~
这方面的话x86甚至可能不如arm。rk3568已经有个0.8Tops的NPU了,现在手机U全都带神经处理单元,专用芯片效率高。
这cpu承担了他不应承担的负担
我明天用独显试一下
我有3090 不怕
a卡可行?
终于有开源的了,这下可以抄车了
文字都认识,连在一起就看不懂了
会不会硬盘涨价也跟这个有关
没啥乱用,语言的,一大堆,要是图片的做点被禁的事儿自己部署还有意思
我准备好了
我mbp跑8b模型cpu也飙到90%
有没有 win 的攻略来一个学习一下
8b 4g显存就可以了,我用mac玩的
刚好组了个电脑,跑下试试
我在服务器上部署了,根本跑不动
上tpu
已经在威联通用GUI部署,确实很有趣
Intel Xeon D-1527不知道能跑不
相比于现在这些心甘情愿花钱花时间给ai当肥料的,当年挖矿的那些人要靠谱的多。
炸是什么意思?。。。。