



 深耕汽车兴趣领域




96
46
小米MiMo以7B参数颠覆AI推理格局:以小博大,7B参数碾压32B对手
2025-05-01 10:33:33
12点赞
24收藏
41评论
核心突破:7B参数碾压32B对手,推理效率与能耗比双杀行业标杆
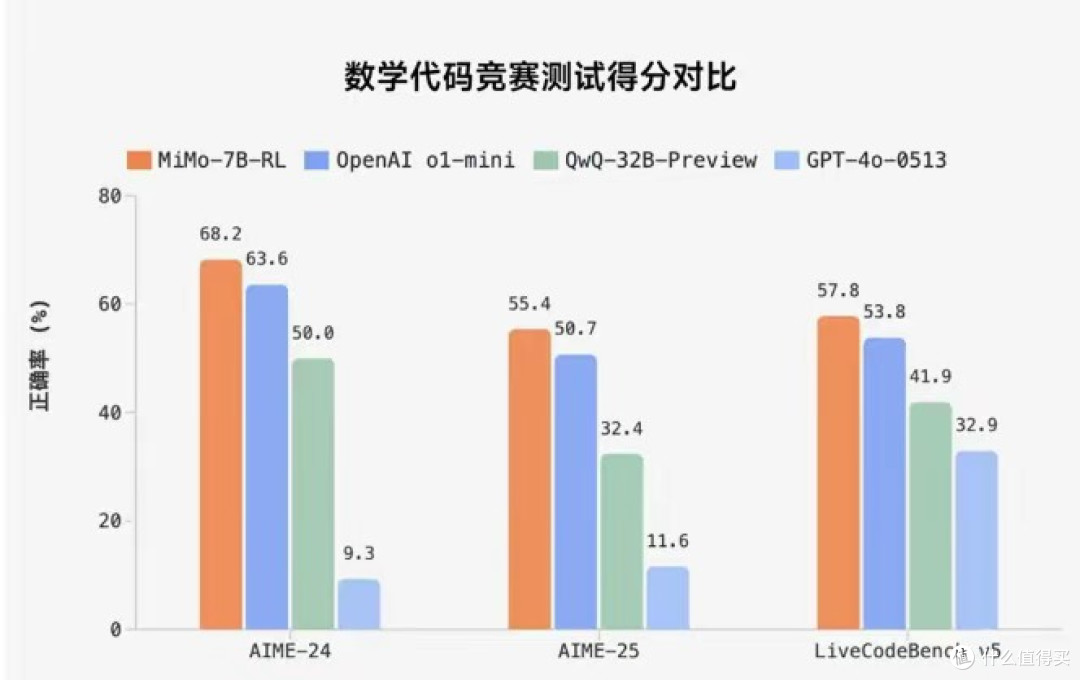
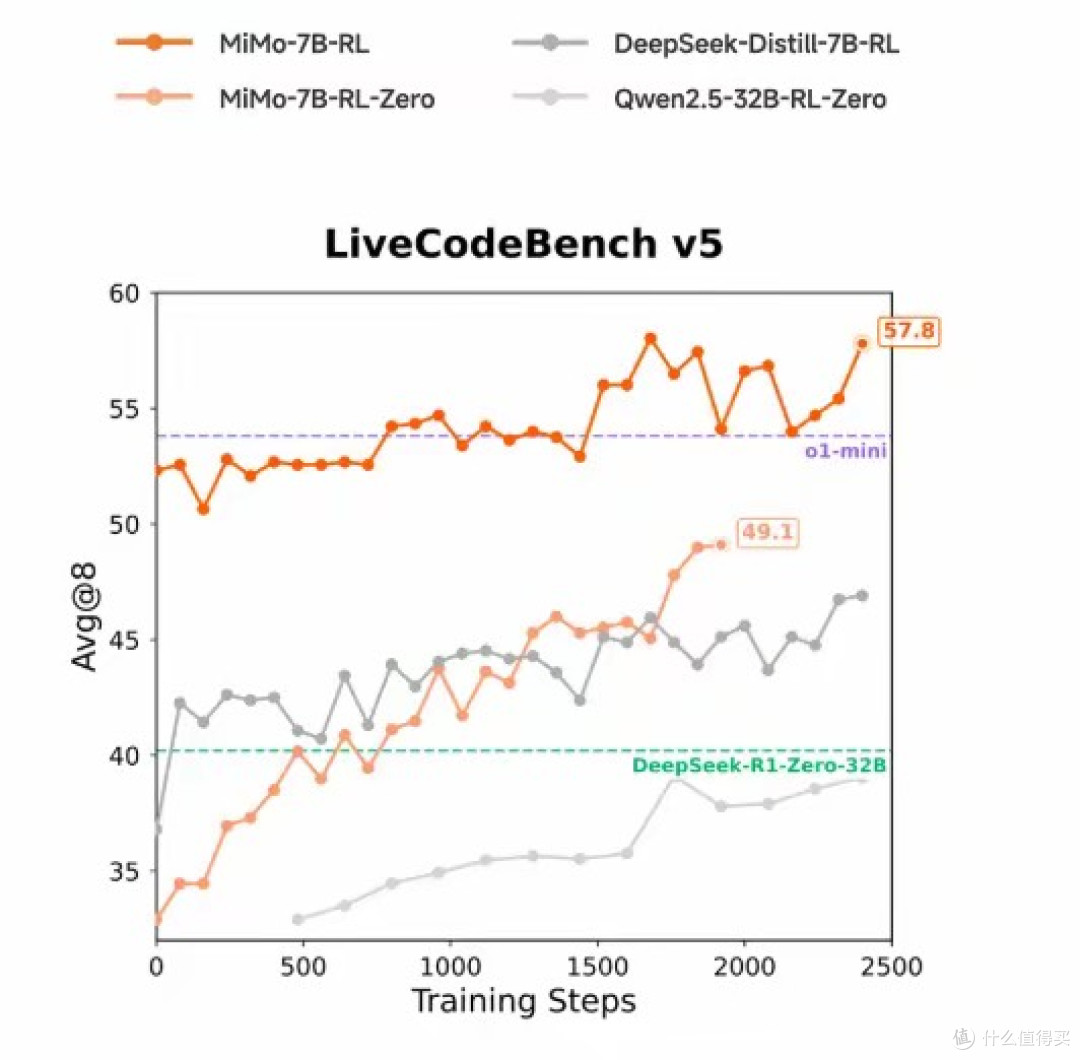
小米MiMo的发布,打破了“参数规模决定性能”的行业铁律。在数学推理权威测评AIME 24-25中,MiMo以68.2%通过率超越OpenAI闭源模型o1-mini(62.1%)和阿里QwQ-32B-Preview(63.7%);代码生成任务LiveCodeBench v5得分57.8分,逼近GPT-4 Turbo(59.3分)。更关键的是,其推理能耗仅为同类模型的1/5,消费级GPU即可部署,为端侧AI落地扫清硬件门槛。
技术密码:从“数据炼金术”到“强化学习范式革命”
MiMo的成功源于预训练与后训练的全链路创新:
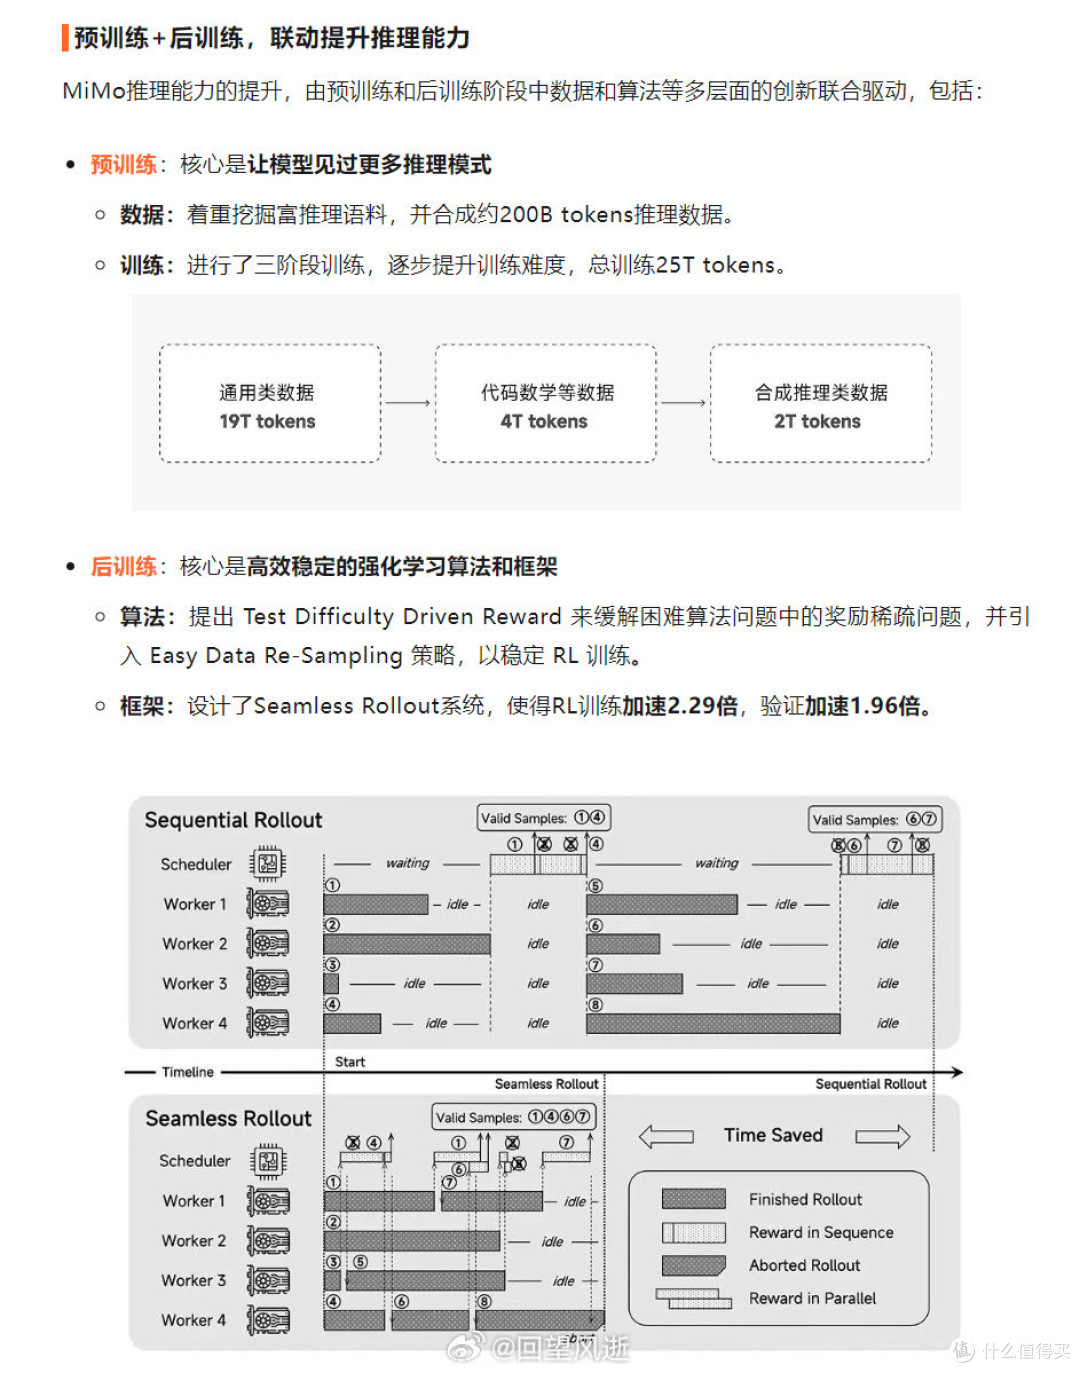
1. 预训练特训:构建200B tokens专项推理语料库,覆盖数学证明、算法题解等高阶场景,通过三阶段渐进训练(基础→STEM强化→长文本突破),累计训练量达25T tokens;
2. 算法革新:提出Test Difficulty Driven Reward(TDDR)机制,动态调整奖励权重破解“难题摆烂”困境,结合Easy Data Re-Sampling策略提升训练稳定性40%;
3. 工程突破:自研Seamless Rollout系统实现异步奖励计算与早期终止,训练速度提升2.29倍,验证效率翻倍。
战略深意:开源生态卡位与端侧AI霸权争夺
小米的布局远不止技术突破:
• 开源降维打击:全系列模型(Base/SFT/RL)开源至Hugging Face,技术报告透明公开,直接对标OpenAI闭源高收费模式(成本仅其1/3);
• 端侧生态闭环:7B参数设计适配手机、汽车等终端,推动本地化推理与隐私敏感任务处理,呼应雷军“AI未来在手机”的战略判断;
• 人才基建护城河:挖角DeepSeek核心开发者罗福莉(MLA技术之父),叠加自建万卡GPU集群,日均算力达100PFlops。
行业冲击波:从“参数内卷”到“效率觉醒”
MiMo的横空出世,对AI赛道产生三重颠覆:
1. 技术范式迁移:证明小模型通过算法密度优化可超越大模型,为算力受限企业提供突围路径;
2. 商业逻辑重构:低能耗特性契合欧盟AI能效新规,规避碳关税风险,开辟绿色AI新赛道;
3. 生态话语权争夺:开源策略吸引开发者构建“小米系”应用生态,挑战Meta、Google的开源主导权。
结语:一场静悄悄的效率革命
小米MiMo的发布,不仅是技术层面的“以小搏大”,更标志着AI竞争从“规模崇拜”转向“算法精耕”。这场由7B参数引发的推理革命,或将重塑全球AI产业格局——当巨头仍在追逐万亿参数时,中国科技企业已用“手术刀式创新”卡住了下一个十年的技术咽喉。












校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案