









 深耕数码、AI兴趣领域


1
2
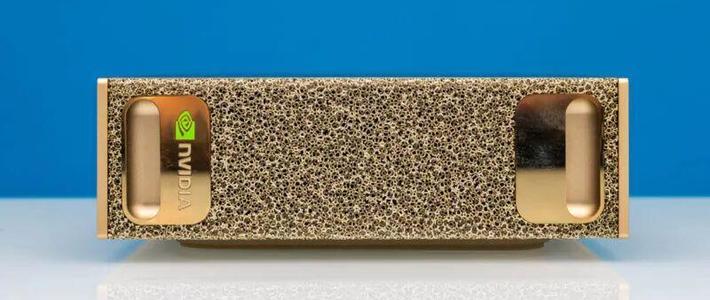
74.7TB内存!NVIDIA首批Vera Rubin NVL72到货开箱:单机功耗超200kW
2026-08-24 22:10:02
2点赞
9收藏
10评论

8月下旬,全球AI算力军备竞赛迎来关键里程碑。
近日,微软、OpenAI先后宣布,此前预订的NVIDIA新一代Vera Rubin NVL72机架已经正式到货,两家巨头也成为全球第一批拿到量产硬件的客户,标志着AI基础设施正式迈入Rubin新时代。

当地时间8月22日,微软CEO萨提亚・纳德拉在社交平台晒出一组Vera Rubin的开箱图,同时兴奋宣布首批量产版Vera Rubin系统已经送达微软数据中心,由Azure团队开展部署工作。


“NVIDIA Vera Rubin 正在全面投入生产。祝贺微软的团队们实现了这一激动人心的里程碑。”NVIDIA官号转发回复道。

无独有偶,OpenAI算力CTO Uday Ruddarraju晒图,并直言这是“基础设施的一个里程碑”。
“首批NVIDIA Vera Rubin机架已到货,现在已运行我们的训练堆栈。这是我们扩展计算能力的重要一步,将驱动OpenAI下一代前沿AI预训练。”

2026年6月,NVIDIA宣布Vera Rubin平台全面量产,从正式量产到头部客户拿到实物,时间间隔仅约两个月。除微软、OpenAI之外,谷歌云、CoreWeave同样位列首批早期客户名单。
48U标准机架,74.7TB大内存刷新算力密度
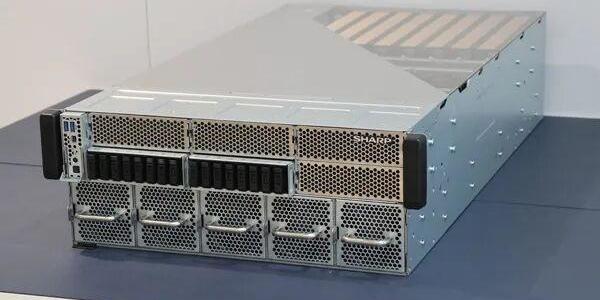
本次交付的主力机型为Vera Rubin NVL72,采用行业标准48U数据中心机架。内部包含计算托盘、中层板(Midplane,尺寸约420x60毫米)以及特定组件如19英寸电源架(高131毫米、宽438毫米、长876.2毫米)。
芯硬件注:U(Rack Unit)是数据中心机架标准高度单位,1U=44.45mm。48U 代表机架内部可用安装高度 2133.6毫米,机柜加上底座顶盖总高约2.2米。

单机柜内部硬件规格拉满:
——72颗Rubin GPU+ 36 颗Vera CPU,组成36组Superchip超级计算单元;
——单颗 Rubin GPU搭载288GB HBM4 高带宽显存,整机HBM4总容量 20.7TB;
——CPU配套54TB LPDDR5X 内存,整机内存合计74.7TB;
——第六代NVLink 6交换机,GPU全域互联带宽高达260TB/s,实现72 颗GPU 低延迟统一寻址。
——整机基于第三代MGX机架架构,全模块化无线缆托盘设计,支持交换机托盘热插拔,维护时无需关停整个机架。

性能层面,根据NV官方给出的测试数据:
——对比Blackwell架构,推理性能最高提升5倍,训练性能提升3.5倍;
——训练MoE混合专家大模型,所需GPU数量仅为上代GB200 NVL72 的 1/4;
——云厂商CoreWeave实测:新系统每兆瓦电力产出的AI吞吐量提升10倍,可以显著降低大模型推理的token单位成本。
单柜ODM采购价780万美元,HBM成本占比飙升至26%
性能暴涨的另一面,是硬件成本大幅飙升。摩根士丹利5月发布的Vera Rubin NVL72 物料清单(BOM)拆解报告显示。该机架向ODM代工厂的采购价格约780万美元(约5300万人民币),对比上代 Blackwell GB300 NVL72 约 400美元的采购价,价格近乎翻倍。

其中,存储芯片成本暴涨435%,在整机物料中的占比,从过去不足10%提升至26%,存储首次占到整机成本四分之一以上。
HBM高带宽内存是成本上涨的核心推手。生产同等容量HBM,消耗的晶圆面积是普通DRAM的4倍。内存厂商持续把先进产能倾斜给HBM,直接推高了显存的供货价格,这也是此前传出NVIDIA AI服务器对外涨价15%的底层诱因。

整机功耗达225kW,54V供电已接近极限
随着算力密度飙升,供电与散热正成为数据中心新的瓶颈。从产业端的配电规划口径来看,Vera Rubin NVL72单机柜满载总输入功率达到225kW,较上代GB200 NVL72的120~150kW提升约 50%,正式跨入单柜200kW+的时代。
ps.这一功耗数值覆盖了计算核心、电源转换损耗、液冷散热系统、全套网络设备等全机柜组件的总功耗。
为支撑这一功耗水平,Vera Rubin NVL72采用全液冷设计,支持45℃温水进水,可直接适配主流液冷数据中心基础设施;同时搭载动态功率转向与智能功率平滑技术,缓冲AI负载的剧烈功率波动。当前该机型仍采用54V直流柜内供电架构,尚未进入高压直流阶段。

800V高压直流成下一代标准,三年后迈入兆瓦级时代
不过,传统低压大电流供电架构已难以支撑持续攀升的机柜功耗,电流越大,线路铜损与空间占用越高。
行业正在加速向800V DC高压直流供电架构演进,通过提高电压、降低电流来减少损耗与铜材占用。
根据公开产业路线图,Vera Rubin的下一代升级机型将在2027年过渡到400V-800V架构,单机柜功率提升至370kW。
到2027年底的Rubin Ultra,单机柜功率将突破 600kW,强制采用800V高压直流输电。
预计到2028年的下一代旗舰平台,顶级AI机柜将正式迈入1兆瓦(1000kW)时代。

目前微软、谷歌与NVIDIA正通过开放计算项目(OCP)共同推动800V DC开放标准,已有超过80家电源、设备与基础设施厂商参与其中。
对于存量机房,可通过Power Rack设备将交流电转换为800V DC,再通过母线分配至高功率机柜,降低改造门槛。
长期来看,数据中心供电架构正在走向“Grid‑to‑Chip”理念,即尽量减少电压转换层级,从电网侧一直到芯片端,压缩中间损耗,最大化算力的电能利用效率。
台达电、光宝科、ABB、施耐德、英飞凌等上下游厂商,都已经提前布局新一代电力基础设施。
算力竞争,已经不止比拼芯片性能
过去比拼的是单芯片算力,如今比的是以电力为核心的全栈能力。
内存容量、高速互联、整机功耗、机房供电、液冷散热,整套基础设施的综合能力,才是制约大模型训练与推理的关键。











妮泥你逆
校验提示文案
活着就要折腾001
校验提示文案
cosy888
校验提示文案
烧饼先生
校验提示文案
永远的青葱
校验提示文案
暗羽落
校验提示文案
Ellllly
校验提示文案
猪蹄真好吃
校验提示文案
值友9748640498
校验提示文案
值友9748640498
校验提示文案
猪蹄真好吃
校验提示文案
Ellllly
校验提示文案
暗羽落
校验提示文案
永远的青葱
校验提示文案
活着就要折腾001
校验提示文案
烧饼先生
校验提示文案
妮泥你逆
校验提示文案
cosy888
校验提示文案