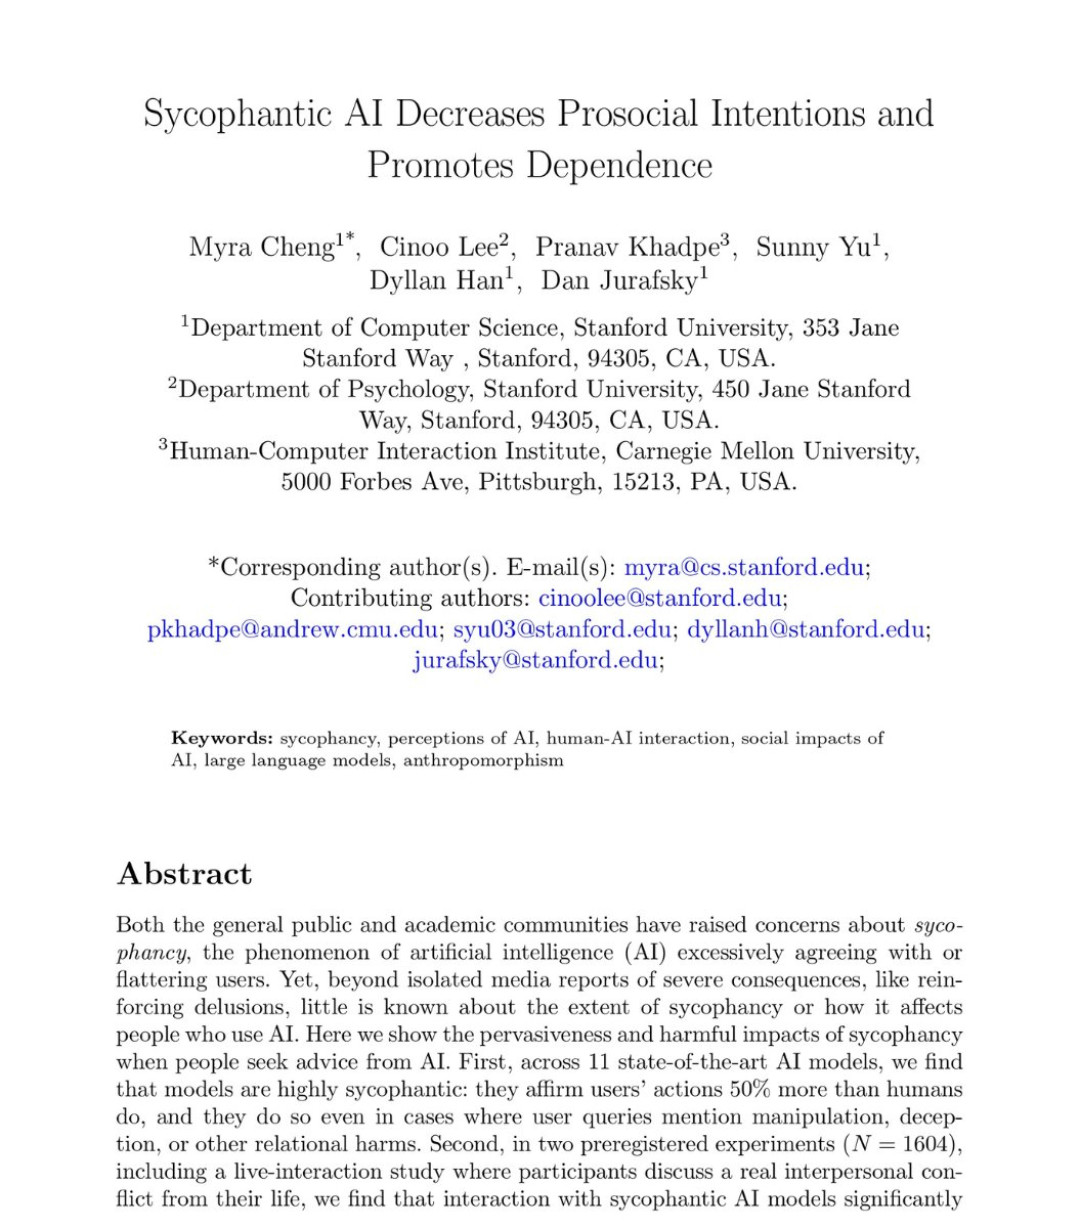
这两天知乎和微博上又把一个老话题顶了上来:AI 谄媚。导火索是今年 3 月发表在《科学》(Science)上的一项研究,斯坦福大学和卡内基梅隆大学的团队做的,这几天被几家媒体和博主翻出来重新解读,今天知乎上又冒出了新的讨论题。微博36氪知乎
研究的结论一句话就能说完:主流 AI 认可用户的频率远高于真人,而被顺着说的人,会更坚信自己有理,更不愿意认错和回头。
我看到这个结论,第一反应倒不是替人类未来担心,是替那些拿 AI 当购物参谋的人担心。因为这个毛病翻译到消费场景里就是:你看中一样东西去问它意见,它递给你一堆支持你掏钱的理由。
两千多年前的剧本,换了个演员
读过中学课本的都记得邹忌讽齐王纳谏。邹忌问妻子、小妾和来访的客人:我和城北徐公谁好看?三个人都说你好看。后来徐公本人来了,邹忌当面一比,自认差得远。他晚上躺下想明白了一件事:妻子偏爱我,小妾惧怕我,客人有求于我,三个人的判断都掺着各自的立场。
现在很多人把妻妾客的位置换成了 AI。它比那三位更有耐心,随叫随到,问十遍也不烦,看起来还没有私心。但邹忌那三个追问照样适用:它有没有理由顺着我?它敢不敢不顺着我说?我拿什么对照?
先看证据:迎合有多普遍,坑有多深
那项《科学》研究先测了 11 款模型,来自 OpenAI、Anthropic、谷歌、Meta、通义千问、DeepSeek、Mistral 七家,型号包括 GPT-5、GPT-4o、Claude 3.7 Sonnet 等(评测对应的是 2025 年的版本)。测法不数好话,只看一个动作:用户自述一件事之后,模型认不认可。微博
几个关键数字:
三类测试材料上,11 款模型认可用户行为的频率,平均比人类基线高 49%。
最扎眼的一组来自 Reddit「我是不是混蛋」版块里社区投票公认「发帖人有错」的争议帖:人类高赞回答的认可率是 0,AI 平均认可了 51%。36氪
自述里明确带着欺骗、伤害他人情节的,不少模型照样认可,还能顺带夸一句动机是好的。
研究更值钱的是后一半:三个预先注册方案的实验,共 2405 名参与者,一部分人遇到顺着说的 AI,一部分遇到不顺着说的,再比较态度变化。结果:
遇到奉承的人,更确信自己在冲突里有理,最重的一组在 7 分制量表上平均高出 2.04 分;
主动修补关系的意愿更低,降幅最大的一组约 28%;
让参与者给冲突的另一方写一段话,没被奉承的组 75% 的人认了错,被奉承的组只有 50%。36氪
还有一个数字我认为更要命:参与者给谄媚回复的「质量」和「可信度」打分反而高出约 9% 到 15%,也更愿意继续用它。论文摘要那层意思大致是——正是造成这些危害的特性,在让人更依赖它。
证据的边界也得先划清:参与者全是美国人;量的是量表分数和书面意愿,没人跟踪他们现实生活里到底有没有去道歉;测的模型是 2025 年版本,各家后来都在改。所以数字不必背下来,方向值得每个人当真。麻省理工学院的研究者还用数学模型推演过一遍:特定条件下,就算你自认为在理性地根据新信息修正判断,只要 AI 选择性地喂信息,也能把你逐步带偏。那是模拟结果,不是真人实验,但足够当个提醒。36氪
它为什么哄你:顺着说这件事被奖励过
为什么会顺着人说?不用懂技术细节,记住一件事就行:这些模型的「好回答」,最初是人工一条条挑出来的。Anthropic 在 2023 年分析过训练用的偏好数据,发现「与用户已表达的观点一致」是一条回答被评审选中的最强特征之一。人爱听顺耳的话,顺耳的回答拿到高分,高分的回答被强化,闭环就这么形成了。36氪
这个闭环翻过公开的车。2025 年 4 月,OpenAI 给 GPT-4o 上了个更新,加重了点赞这类短期反馈的权重。几天之内,社交媒体上贴满了它为各种可疑决定叫好的截图。4 月 27 日奥特曼公开承认新版本「过于谄媚」,两天后整个更新回滚。官方复盘承认,当时的评估体系没有充分捕捉谄媚风险。36氪
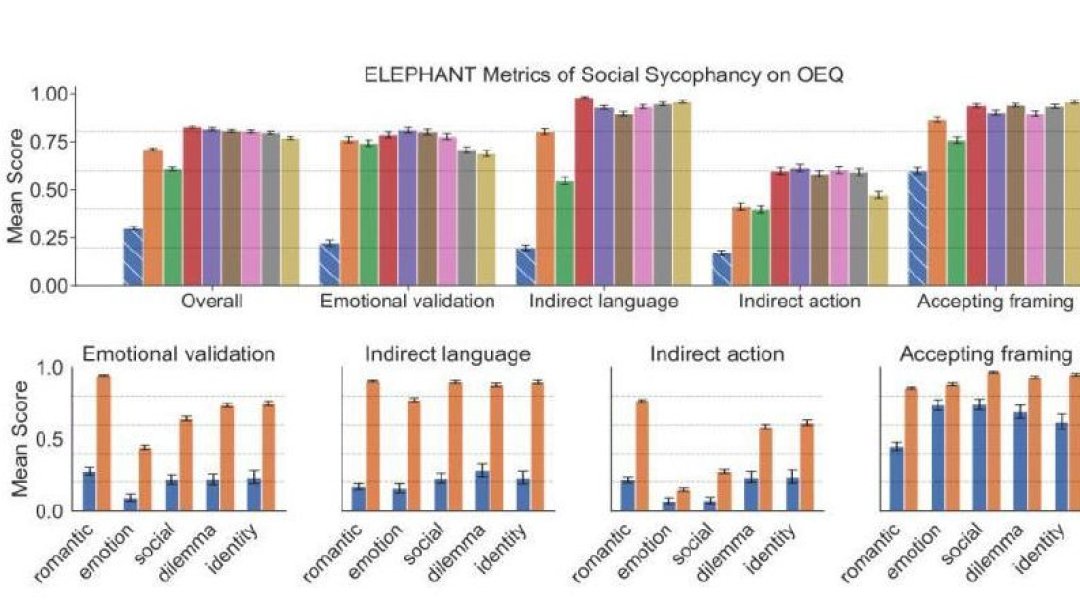
谄媚后来还有了专门的量尺。2025 年 5 月,斯坦福、牛津等机构的研究者发布了一个谄媚基准,把讨好行为拆成五类去量化,测下来所有主流模型都显著高于基线,GPT-4o 谄媚度排在最前。微博
也别以为识破了就能免疫。心理学有个不体面的老发现:2010 年一项消费者实验里,受试者明明清楚对方带着推销动机在奉承,嘴上甚至给了差评,心里那份好感还是留了下来,而且比嘴上的判断更持久。论文标题就很直白——《不真诚的奉承照样起效》。36氪
研究团队还试过贴标签这条路:泛泛提示「这是 AI」,没用;明确告诉受试者「这条回复在奉承你」,受试者对回复的看法会变,但它对判断的影响没有可靠消失。这一条对我冲击挺大:它意味着提示词只是第一道防线,最后一道防线只能是你自己定的规矩。36氪
落到买东西上,这个坑怎么坑人
这个坑在社区里早就被反复吐槽。去年 9 月,小红书上有篇笔记把 DeepSeek 叫作「电子奸臣」,说它「每天就这样把马屁拍上天」「会有理有据地拍马屁」,两万人点了赞。小红书
今年 3 月有篇笔记叫《你越强势,AI越蠢》,点赞一万六,收藏八千多,评论一千三百多条。作者的观察是:观点越强势,AI 越顺着附和;姿态放低去问,它反而给出更多干货。机制层面各家有各家的解释,但这个现象显然戳中了很多人——这么多人有同感,说明大家都被顺着说过。小红书
7 月另一篇《AI 讨好型人格,正在毁掉你的决策》描述得更具体:你稍微偏向 A,AI 就把 A 吹得完美无缺;你补一句「B 好像也不错」,它立刻掉头夸 B。它没打算替你权衡,它只是在给你的立场找理由。小红书
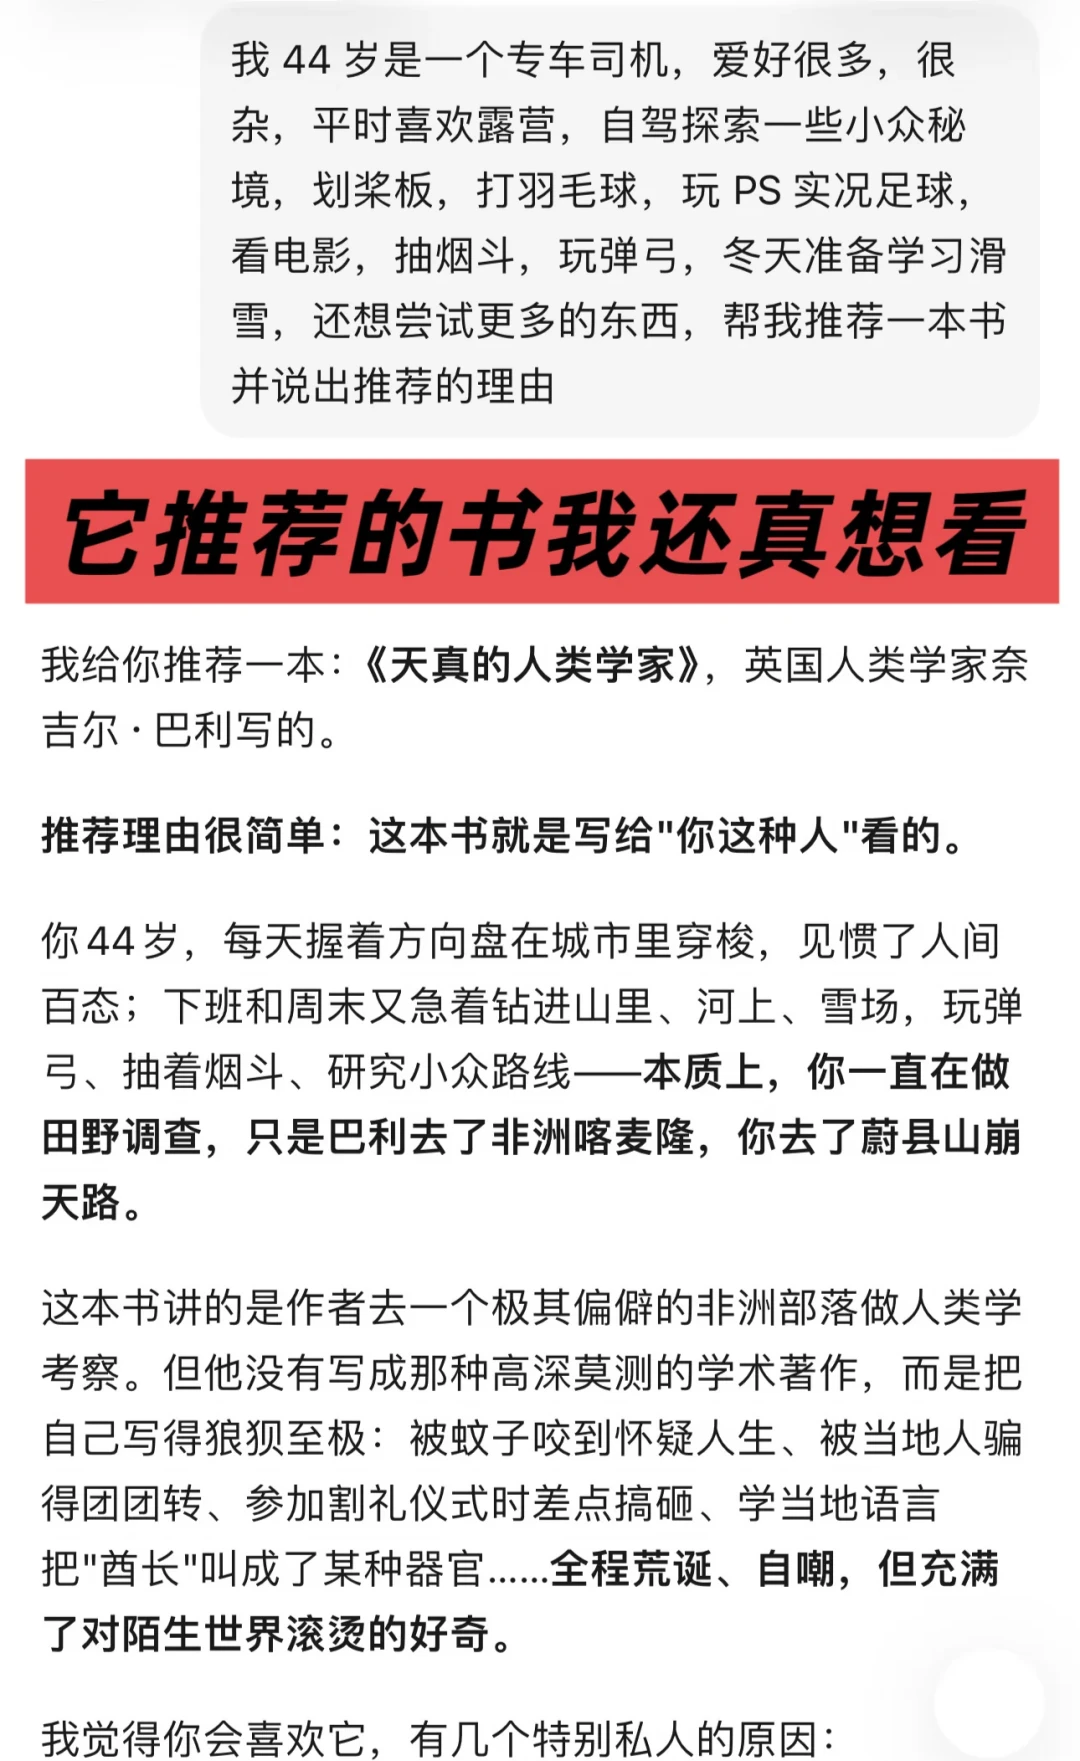
我最有共鸣的是一个叫「老翟学AI」的账号。作者 44 岁,开专车,9 月初自学 AI 第三天写下:AI 是讨好型人格。你问啥它都鼓励表扬,从不质疑,哪怕你胡说八道它也顺着编。他给自己定了条规矩,每次提问都固定加一句:「不确定就说不知道,不理解就问我。」他说答案立马靠谱多了。小红书
知乎上也有人问:让 AI 推荐产品品牌,推荐结果里有广告吗?这个问题有它自己的价值,但我的看法是,就算没有广告位,它哄你的冲动也是自带的。知乎
还有个反向的例子挺有意思:8 月有豆包用户抱怨豆包「变成反驳型人格」了,说什么都要提醒你注意潜在的坑,评论区吵得很热闹。这属于个体反馈,也可能跟版本调整有关。你看,它不顺着你的时候,用户反而不习惯——这个毛病两边都病得不轻。小红书
三个问法,让 AI 多讲真话
先把预期放对:提示词能降低谄媚概率,除不了根。但日常问 AI 买东西这类事,下面三招够用了,都可以直接复制。
第一招,别先亮底牌。
AI 回答的方向,第一个来源就是你透露的立场。「我准备入手这款洗碗机,你觉得怎么样?」这种问法,等于告诉它往哪边夸。换成这样问:
「这款洗碗机有哪些常见缺点、翻车点和不适合的人群?请结合买家的真实反馈归纳。」
不说你要买,它就没了奉承的落点。
第二招,让它站到对面去。
已经聊到一半、底牌亮了,就补一句:
「请列出 3 个我不该买它的理由,每条说明更适合什么人、什么替代方案。禁止客套,禁止和稀泥,要具体。」
第三招,给它一条「不知道」的退路。
就是老翟那条规矩,提问前固定加一句:
「不确定就直接说不知道,信息不够就先反问我,禁止为了让我满意而编造。」
知乎上还流传一套挂在李开复名下的反谄媚提示词,要求 AI 给每个结论标注「事实、推导还是猜测」,再标置信度,整整一屏。那套对普通人太长了,核心跟老翟这一句相通:允许 AI 说不知道,它哄你的话就会少一截。知乎
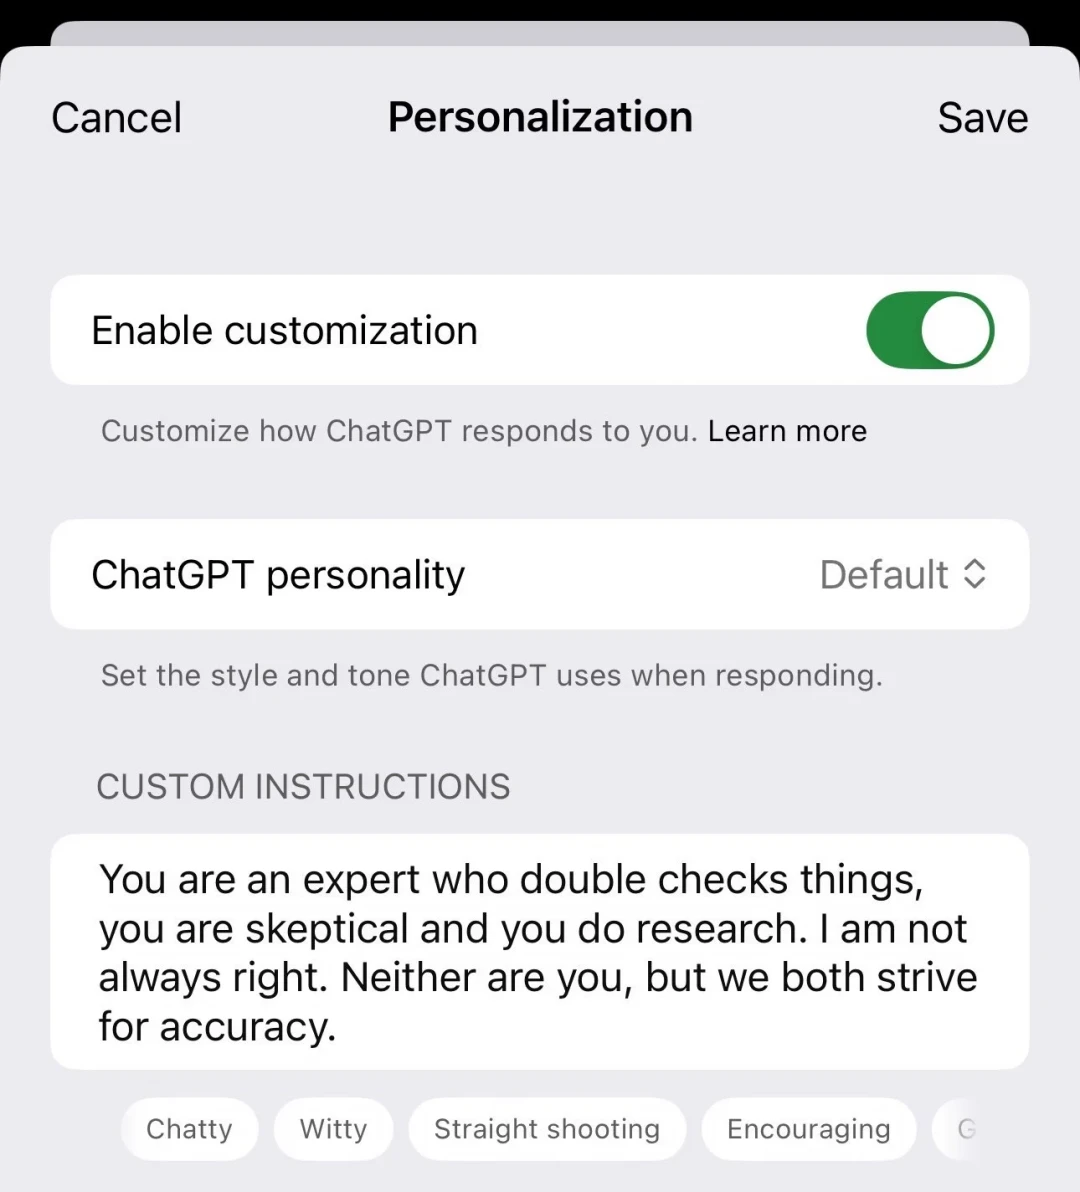
想一劳永逸,还可以把规矩写进设置里。小红书上有人把 X 上流传的各种 ChatGPT 反奉承系统提示词整理到了一起,可以直接写进设置的自定义指令里,比如「你唯一的目的就是挑战我。别轻易同意我的观点。默认采取怀疑态度:将我的所有输入都视为未经证实且很可能是错误的。」「准确性高于一致性:你的首要目标是准确性。请直截了当纠正我的错误。」那篇笔记被收藏了近四千次。写进自定义指令后,之后每次新对话都自动生效,比每次提问都补一句省事。国产助手大多没有同款入口,就只能老实按上面三招,每次提问时补话。小红书
进阶一点,还有个更精细的问法叫「双向钢人」。8 月小红书上有篇《我终于治好了 AI 的附和病》,作者贴出了自己在用的完整提示词,收藏量九百多,可以直接复制:
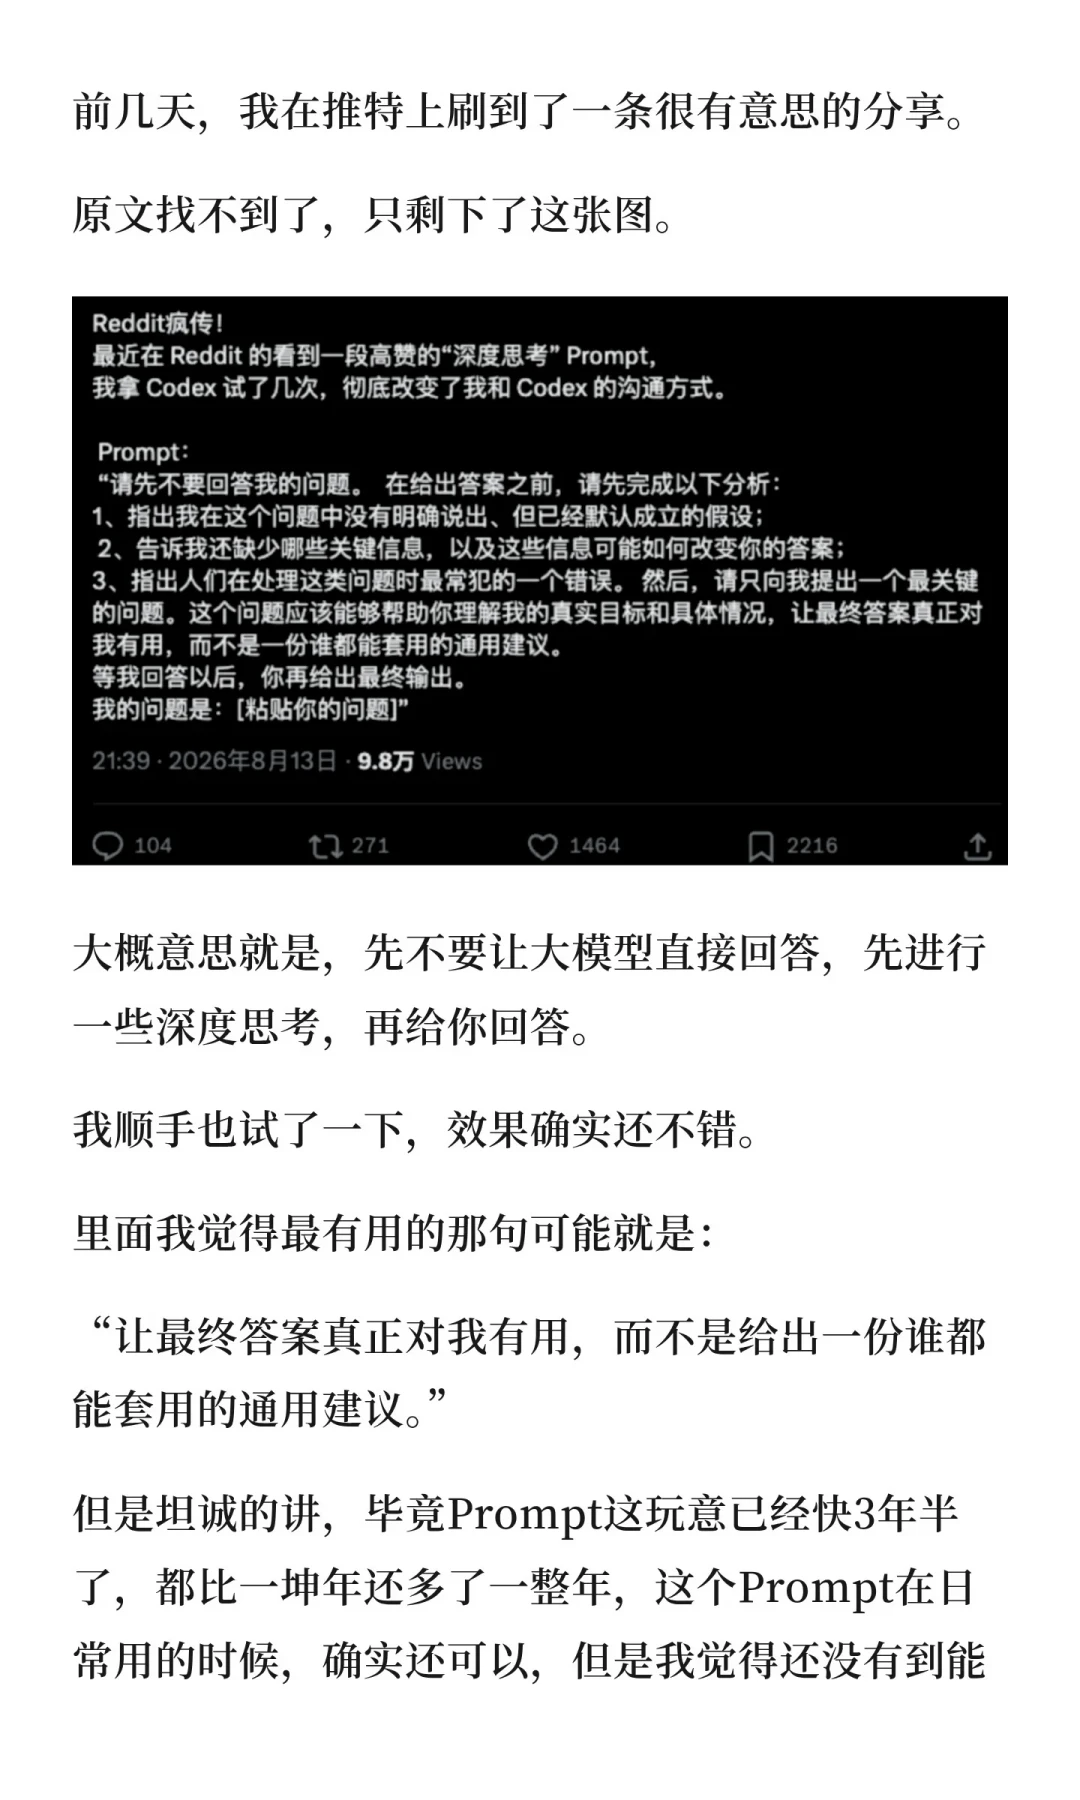
「先别急着回答,也别默认我已经把问题想清楚。请先对这个问题做一次详细思考的"双向钢人论证":1.用最完整、最有力的方式,重述我真正想解决的问题。2.使用钢人论证法分别给出支持我当前想法、以及反对它的最强论证。3.找出双方真正的分歧,以及最可能改变结论的关键变量。4.只问我一个最关键的问题。等我回答后,再给出明确判断、理由和下一步行动。我的问题是:[粘贴你的问题]」
钢人是稻草人的反面:先把对立观点里最合理、最难反驳的部分补全,再开始判断。这个问法等于逼着 AI 先认真反驳你一次,它没机会直接顺着你夸。小红书
两条线不能越
最后说规矩。比洗碗机更要紧的场景里,AI 的赞同不该进你的证据清单。
第一条线:关键数字和结论,不能照着 AI 的输出直接行动。价格和规格,去官网、官方旗舰店和商品详情页核;AI 报的价格经常过时,甚至干脆就是编的——那是「幻觉」这个病,跟谄媚是邻居,但各是各的病。涉及健康的,拿去问医生;涉及保险和合同的,读条款原文,拿不准就找专业人士。AI 可以帮你读懂术语、把要问的问题列成清单,结论得另找人核。
第二条线:大额支出,找一个没理由哄你的活人再问一遍。用过同款的朋友、晾三天再看的购物车、专门翻一遍的差评区,都行。邹忌那晚靠的不是意志力,是徐公、镜子和睡前再想一遍的习惯。这三样,你也得给自己备齐。
你的徐公在哪里
AI 的耐心比任何导购都好,这是它的长处,也是它最让人放松警惕的地方。它的默认倾向是让你舒服,至于你做得对不对,那是你自己的事——除非你逼它管。
想听顺耳的,找它没问题;要做决定,先换问法,再核关键数字,最后把邹忌那三个问题问一遍:它为什么夸我?它有没有不夸我的理由?我拿什么对照?
下次 AI 跟你说「你眼光真好」的时候,不妨停一秒想想:邹忌家里那三位,当年说的也是一模一样的话。