











 深耕数码兴趣领域




2
2
绿联AI NAS iDX6011Pro亮相英特尔大会,本地 AI+外接GPU双管齐下
2026-09-23 17:10:49
11点赞
0收藏
3评论
随着 AI 能力逐渐进入 NAS 产品,行业竞争正从传统的存储容量、传输性能,进一步延伸至本地 AI 算力、模型能力以及软硬件协同。如何在保留 NAS 数据存储与管理能力的同时,为 AI 任务提供持续、可扩展的算力,也成为厂商正在探索的新方向。
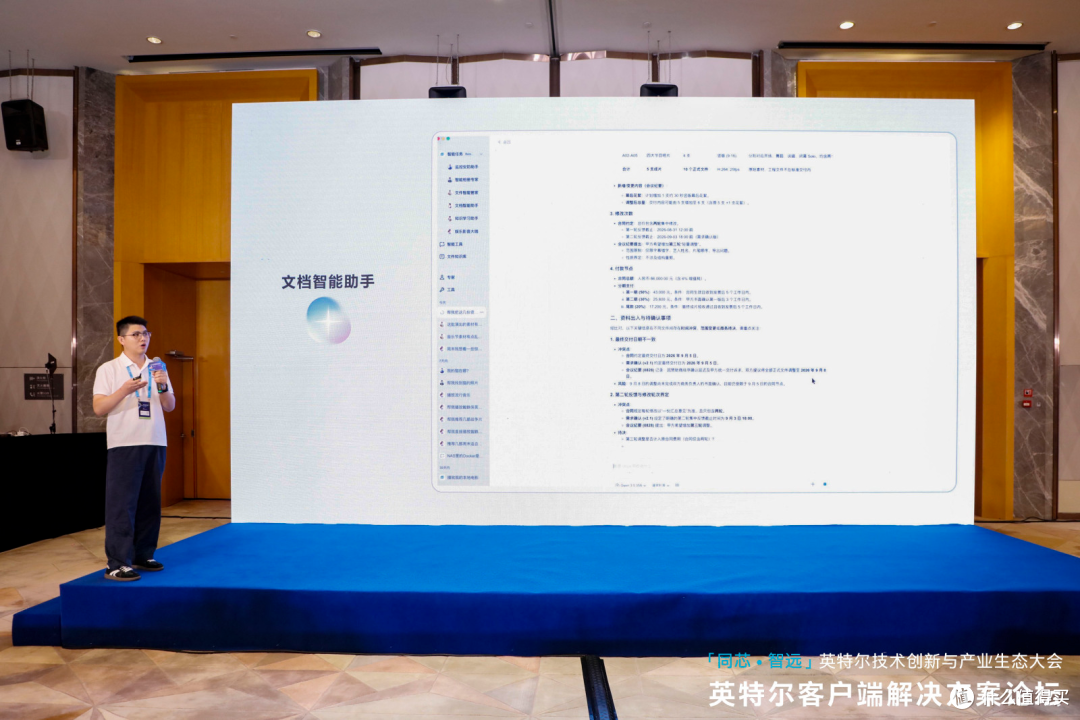
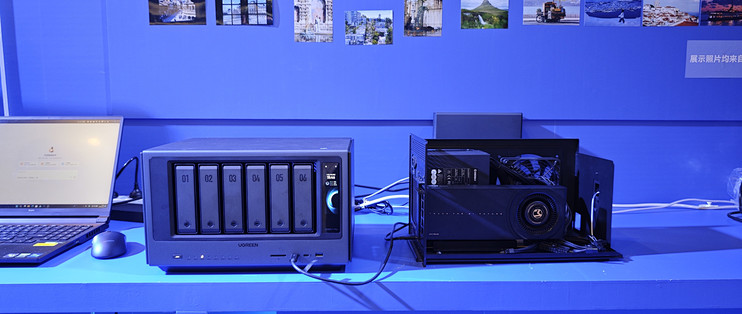
在 9 月 22 日—23 日于苏州国际博览中心举行的「2026 英特尔技术创新与产业生态大会|智存启新·AI NAS 智能体与生态落地」活动上,绿联科技展示了首款内置大语言模型(LLM)的 AI NAS 私有云 iDX6011 Pro,以及其与英特尔本地算力、外置 GPU 协同的应用方案。设备通过英特尔酷睿Ultra 7 255H 处理器提供本地 AI 能力,同时借助 OCuLink 接口连接显卡坞,尝试将存储与算力进行进一步解耦,为 AI NAS 的可扩展能力提供了一种新的产品思路。
从“AI 上 NAS”到存储与算力协同
过去一段时间,AI NAS 的产品形态更多集中在“NAS+AI 助手”:在原有网络存储能力之上增加 AI 模型,让用户能够通过自然语言搜索照片、文件或调用相关功能。
而随着 AI 应用逐渐从简单问答走向内容生成、文件处理和 Agent 自动化,对设备算力的需求也在持续提升。对于 NAS 而言,既要承担长期的数据存储、备份和文件管理,又要运行越来越复杂的 AI 任务,两类需求如何协同,也成为新的产品设计课题。
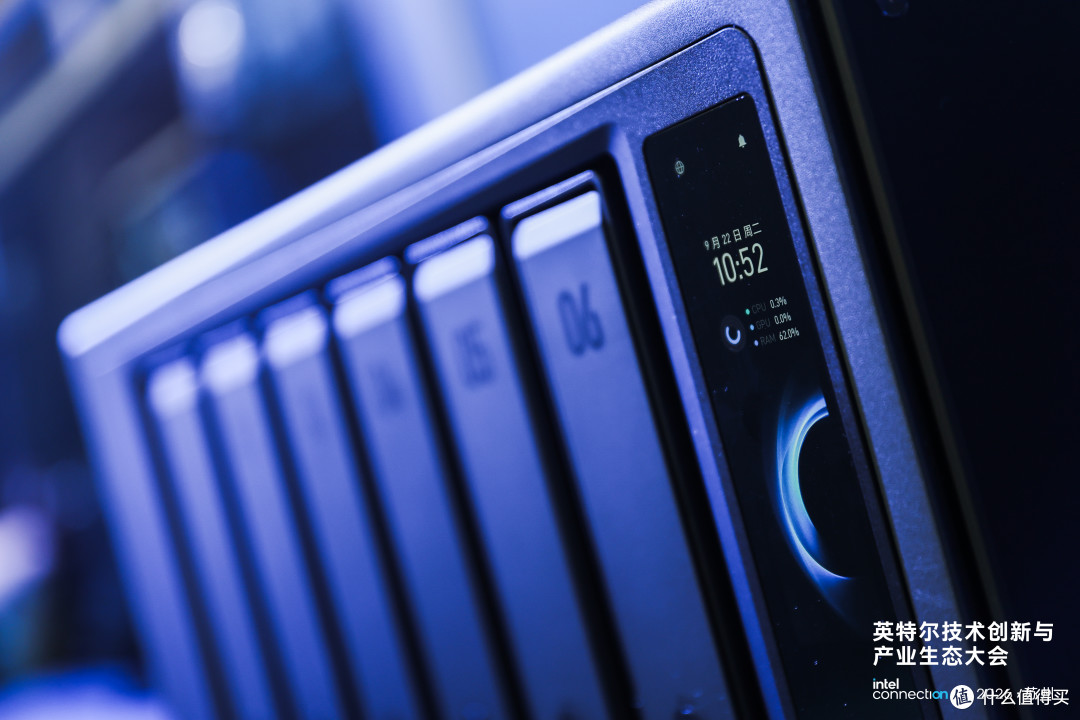
此次大会上,绿联展示的 iDX6011 Pro 采用英特尔酷睿Ultra 7 255H 处理器,由 CPU、GPU 与 NPU 三核异构协同,提供最高 96 TOPS 的 AI 综合算力;配备 64GB LPDDR5X 高速内存(最高 8400MT/s),以 6 盘位 SATA(单盘最大 32TB)搭配双 M.2 NVMe 插槽(单盘最大 8TB)组成存储组合,最高支持 208TB 容量。接口方面提供双 10GbE 万兆网口(链路聚合可达 20Gbps)、双雷电 4(Thunderbolt™ 4,40Gbps)、HDMI 8K 输出与 SD 4.0 卡槽;机身正面还配有一块 3.7 英寸 LCD 触控彩屏,不必打开客户端即可查看 CPU、内存、温度与风扇状态。
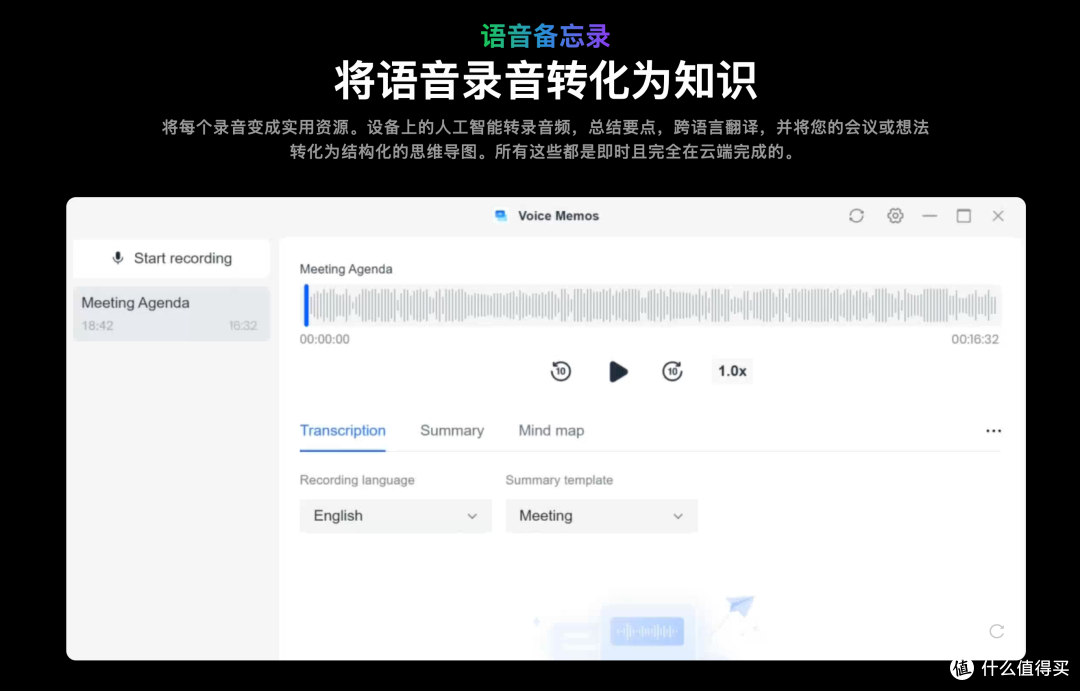
从产品定位来看,这并不是简单增加 AI 功能,而是尝试让 AI 算力与 NAS 原本的数据管理能力在同一设备中协同工作:日常的照片整理、文件检索、文档处理等任务可以更多依托本地算力完成,而面对更高负载的 AI 任务,则可以通过外部算力进一步扩展。
英特尔本地算力,让 AI 能力直接作用于本地数据
对于 NAS 用户而言,AI 真正产生价值的前提之一,是能够理解并调用设备中长期沉淀的数据。
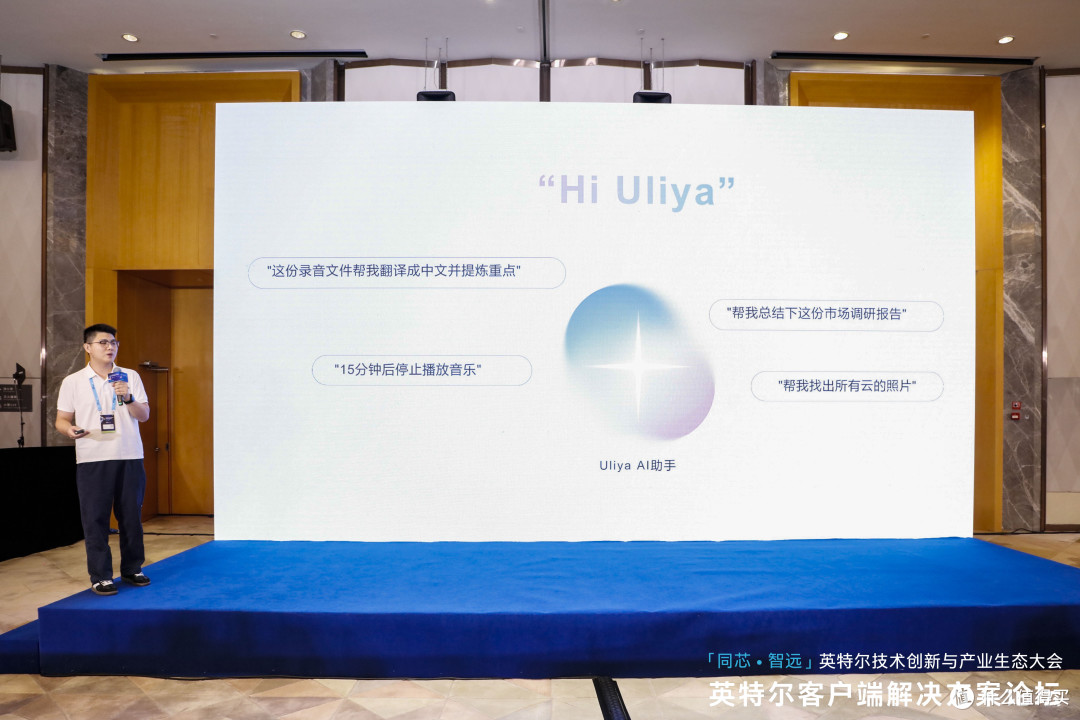
iDX6011 Pro 基于英特尔酷睿Ultra 7 255H 的 CPU、GPU 与 NPU 协同能力,为本地 AI 应用提供算力基础。绿联将这部分算力用于本地数据处理,并将 AI 能力融入文件、照片、影音、文档等使用场景:在 UGOS Pro 系统上,这些能力具体落在 AI 相册(语义搜索、按人物与场景智能分类、OCR 文字识别与相似照片去重)、AI 全局搜索(自然语言跨文档检索)、AI 文件整理与 AI 专属知识库等功能上。
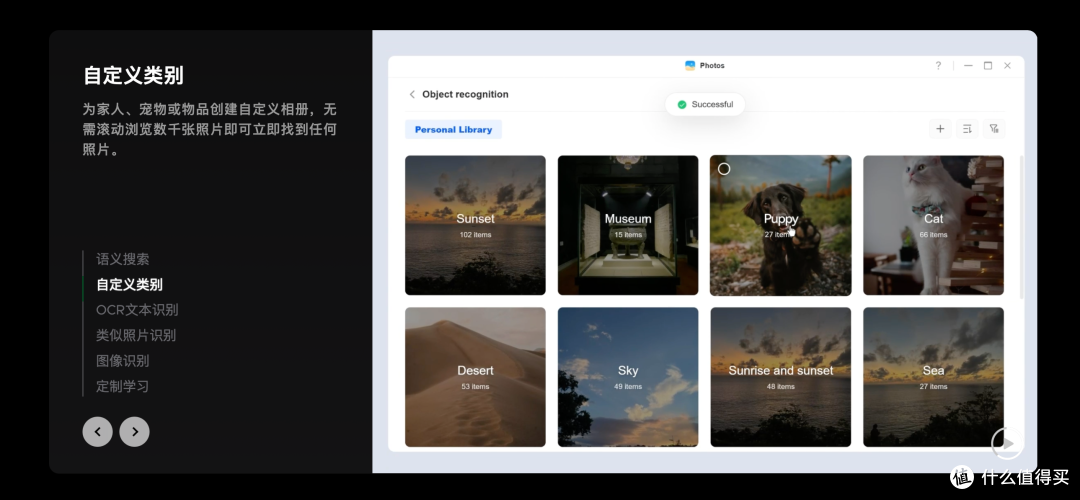
在实际应用中,用户可以通过自然语言与 NAS 中的数据进行交互,例如进行文件检索、照片整理、内容识别等操作。由于这类 AI 推理全部在本地完成,敏感数据无需上传公网,断网状态下也能正常使用;面对更复杂的任务,则可以按需切换云端模型,在本地隐私与模型能力之间进行选择。
相比把 AI 作为一个独立入口,这种方式更强调 AI 与 NAS 数据之间的连接,让存储设备中的既有数据成为 AI 可以调用和处理的内容。
OCuLink 外接显卡,探索“存储底座 + 可扩展算力”
如果说本地 AI 能力解决的是日常使用,那么面对视频生成、复杂内容处理等高负载 AI 任务,单台 NAS 内部的算力仍然存在一定边界。
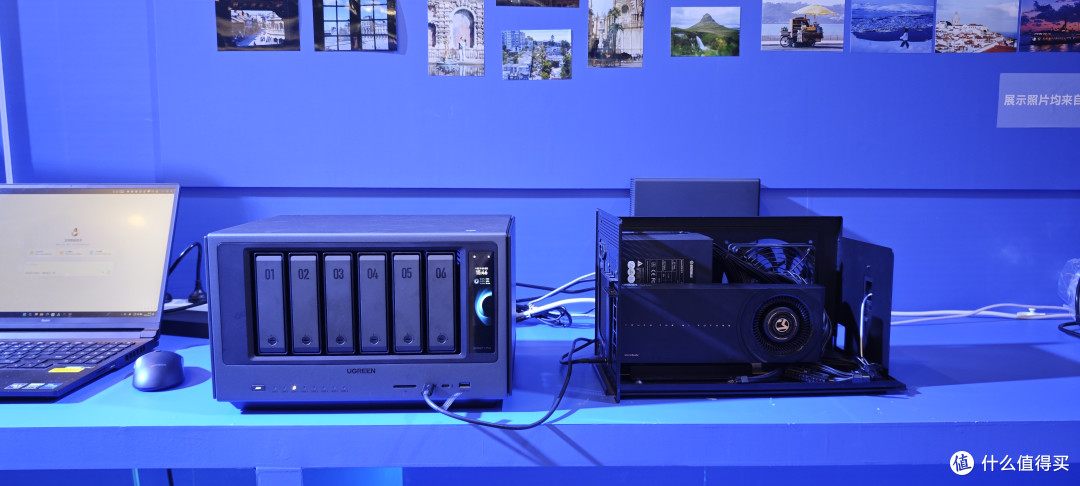
此次大会上,绿联展示了另一种解决方式:通过 OCuLink 接口连接外部 GPU,让 NAS 主机与高性能 AI 算力模块进行分工。现场方案中,iDX6011 Pro 通过 OCuLink 连接搭载英特尔锐炫 Pro B70 专业显卡(32GB GDDR6,INT8 峰值算力 367 TOPS)的外置 GPU 设备;NAS 主机继续承担文件存储、数据管理、备份等基础任务,外接 GPU 则负责更高负载的 AI 计算。
除 OCuLink 外,机身还提供 PCIe Gen4 x8 插槽,可按需扩展万兆网卡、SSD 等高速外设。相比雷电 4,OCuLink 属于原生 PCIe 直连,外接显卡时的带宽损耗更低——这也是这一方案得以成立的关键。
对于 AI NAS 而言,这种连接方式的意义并不只是增加一块 GPU,而是让“存储”和“高性能计算”形成相对独立的模块。当未来 AI 模型和应用对算力提出更高要求时,用户可以围绕外部算力进行扩展,而不必把所有能力都固化在 NAS 主机内部。存储底座保持稳定、算力按需扩展,这也为 AI NAS 提供了一种不同于传统整机升级的思路。å
两个 Demo,展示 AI NAS 如何进入真实工作流
相比纸面上的算力参数,绿联在大会上带来的两组场景化 Demo 更值得关注。
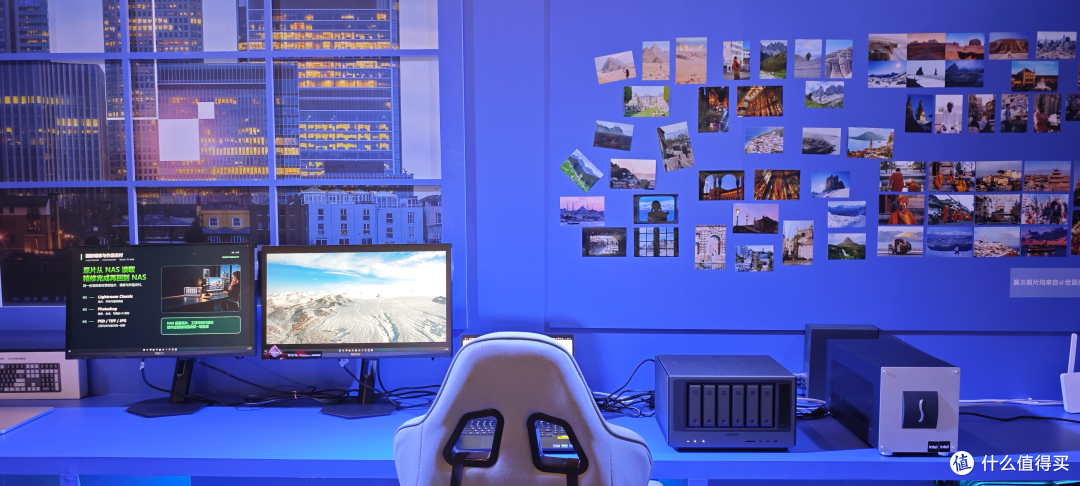
OCuLink × 英特尔锐炫Pro B70 显卡,探索本地 AI 视频生成及工作流
对于短视频创作者而言,素材存储、AI 处理和最终成片往往分散在不同设备与服务中。一方面,本地设备的算力存在上限;另一方面,把大量素材上传到第三方云端处理,也带来数据管理与隐私上的额外成本。
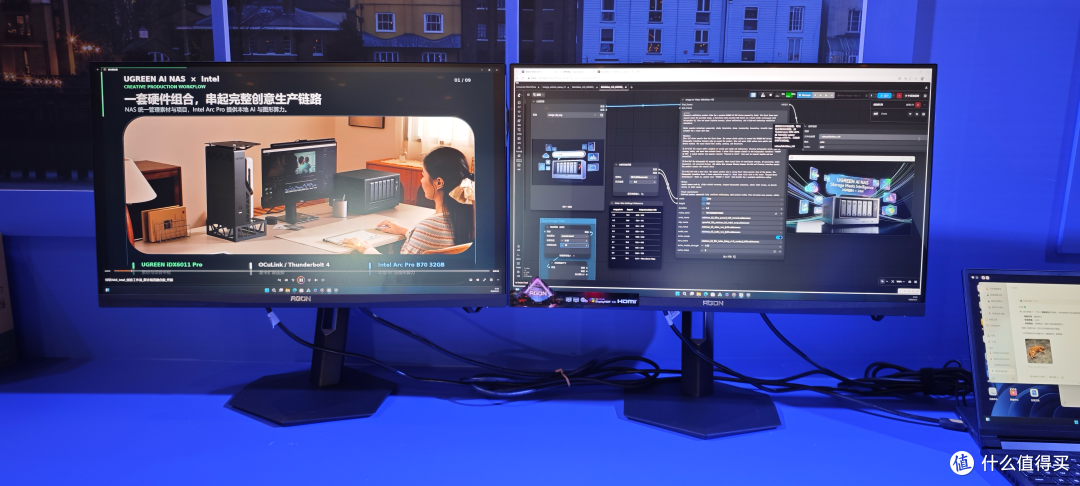
在现场演示中,iDX6011 Pro 承担素材存储与文件管理,外接的英特尔锐炫Pro B70 显卡则负责 AI 创作等高负载任务。从素材导入、AI 处理到成品生成,原始素材和最终文件都围绕 NAS 进行管理;AI 生成的内容完成后回写至 NAS 对应目录,形成“素材存储—外部算力处理—成品归档”的衔接。
这一 Demo 的重点并不是比较 GPU 的算力参数,而是通过“NAS 负责数据、GPU 负责计算”的分工,把 AI 能力嵌进创作者原本的工作流程:大量素材不必在设备之间来回搬运,NAS 仍是整个创作流程的数据底座,外部 GPU 则按需补充算力。
联动腾讯旗下AI管家Marvis(马维斯),让 Agent 直接调用 NAS 数据
另一组 Demo 则将重点放在 Agent 与 NAS 之间的协同。现场演示中,绿联展示了 iDX6011 Pro 与腾腾讯旗下AI管家Marvis马维斯的联动能力:Agent 可以调用 NAS 中的文件,并根据任务要求执行搜索、下载、分类、处理和归档等操作。
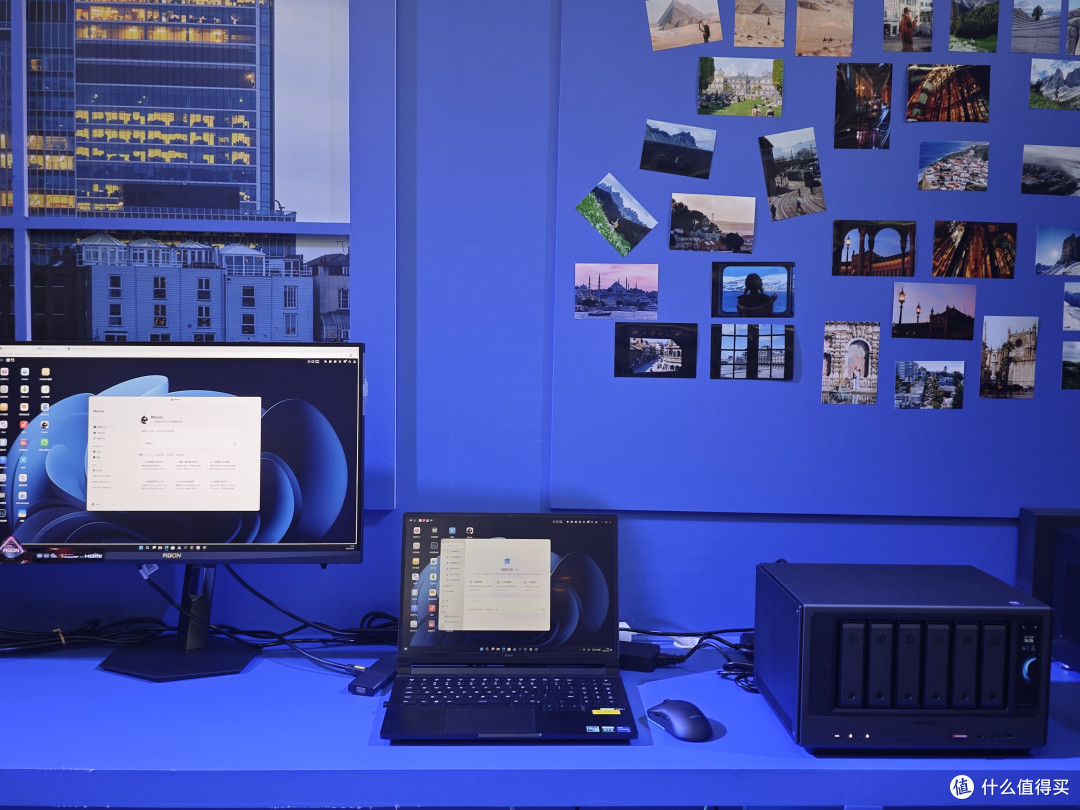
例如,在内容生产场景中,Agent 可以先通过浏览器检索符合要求的网络素材,将素材下载并保存至 NAS 指定目录;随后调用 NAS 中的图片、视频等存量素材,执行素材整理与基础处理等任务,并将产出回写至 NAS。
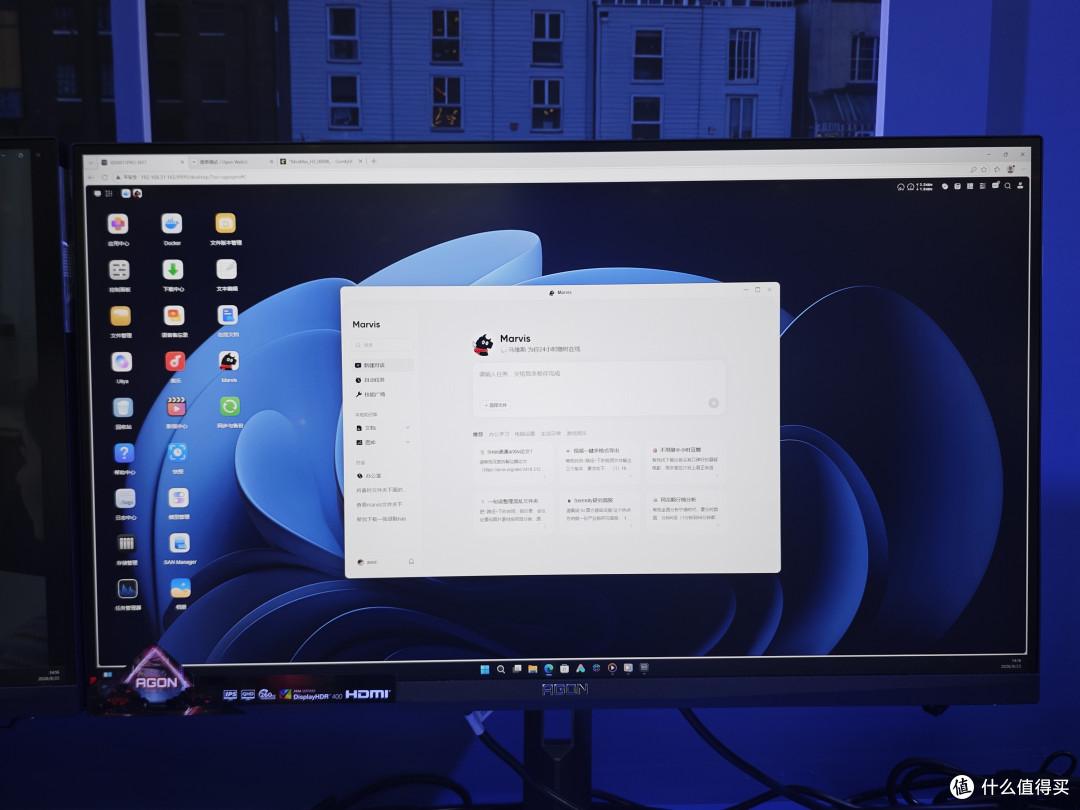
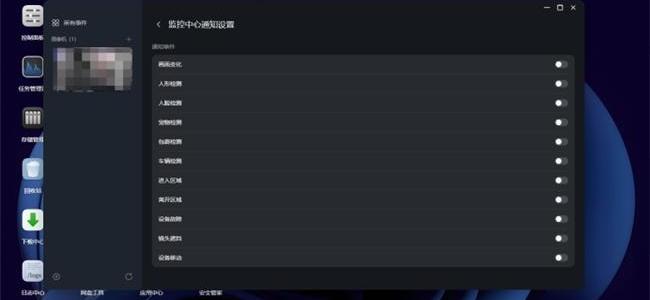
对于企业或团队积累的大量历史资料,这种能力的价值也不只是“帮用户找文件”,而是让 Agent 进一步参与数据整理和内容处理。据现场介绍,该方案还引入了沙箱隔离机制,并对删除、批量修改等高风险操作设置人工确认环节——该机制由 Agent 侧提供,NAS 侧负责数据权限与操作留痕,在自动化执行与数据安全之间增加了一道控制机制。
从这一 Demo 可以看到,AI NAS 的应用边界正在从“用户向 AI 提问”,逐步延伸到“Agent 调用本地数据并完成连续任务”。NAS 在其中扮演的角色,也从单纯的数据存储设备进一步向 AI 工作流的数据底座延伸。
从 AI 功能到 AI 工作流,NAS 正在发生什么变化
从此次大会展示的方案来看,AI 正在从 NAS 上的一项附加功能,逐步进入数据存储、内容处理和自动化工作流:一方面,iDX6011 Pro 依托英特尔酷睿Ultra 7 255H,把本地 AI 能力融入照片、文件、影音等日常数据管理;另一方面通过 OCuLink 连接外部 GPU,为更高负载的 AI 任务提供扩展空间。同时,随着与腾讯旗下AI管家Marvis马维斯等 Agent 生态的联动,NAS 中的本地数据也开始进入更加复杂的自动化工作流。
对于用户而言,未来选择 AI NAS 时,除了关注处理器、内存、盘位和网络接口等传统硬件参数,也可能需要进一步关注三个问题:本地 AI 能做什么、外部算力能否扩展,以及 AI 能否真正调用和处理自己的数据。而这些能力如何进一步落地,也将成为 AI NAS 从“具备 AI 功能”走向“真正参与用户工作流”过程中值得持续观察的方向。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~











校验提示文案
校验提示文案