


















8
5
125B模型塞进12GB显卡:显存不够就借内存条
2026-10-05 21:49:30
0点赞
1收藏
0评论
一张12GB显存的游戏卡,跑起了1250亿参数的模型,每秒吐93个token。
八月底这个模型刚开源,一位长期跟踪开源模型的博主在DGX Spark上试它,挑的是72.5GB和78.9GB两个量化版本。光权重就七十多G,比多数人的整台电脑还大。
今天Hacker News榜首那条帖子讲的是另一个场景:一张4090、128GB内存,实测124 token/s,658分。
中间隔了六周。这六周里变的东西,比"模型又升级了"更值得说。
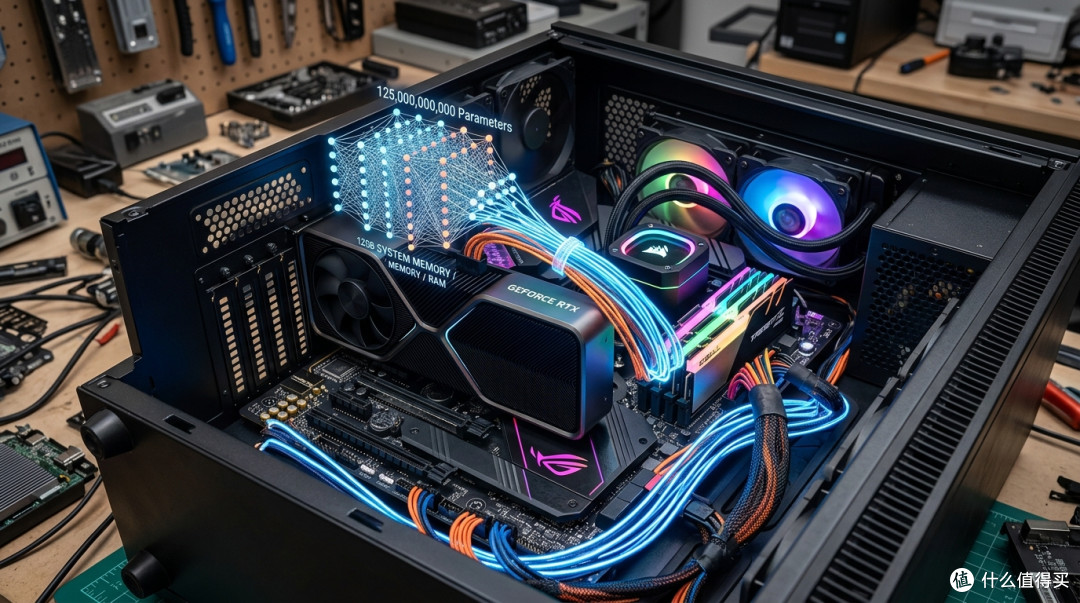
125B和12GB,这两个数字为什么能同时出现
125B说的是这个模型仓库里的全部存货。
Qwen3.8-Flash-Next是阿里八月底开源的混合专家模型,总参数1250亿,但每处理一个token,真正参与计算的只有60亿。
差出来的那一大截,是关键。
混合专家的结构里有一堆"专家"模块,每来一个token,路由器只在里面挑一小撮干活,剩下的这一轮完全不动。所以125B是仓库里的存货总量,6B是每次真正上工的人数。
挑人这个动作本身很轻。路由器只看当前这个token,在一张表里比一次相似度,选出要用的那几个专家编号。真正重的是选中之后的矩阵乘法,而这一步的规模已经被那6B限住了。
模型大不大,和算得快不快,在这套结构里被拆成了两件事。前者由仓库里的存货决定,后者由每次上工的人数决定。
后面这半句推下去很短:不参与这一轮计算的权重,不需要算得快,只需要放得下。
而"放得下"这件事,内存条比显存便宜太多。一条64GB的DDR5,价格还不如一张中端显卡。
Strata这个引擎整套逻辑就围着这一句转。它把最常被路由到的专家留在显存里,次常用的放进内存,冷门的放更慢的地方交给CPU算。用配置参数说,是--expert-cache auto这一行。
做那份八档实测的人,机器是24GB显存加64GB DDR3内存。他在参数表里写得明明白白:热专家驻显存,其余留在内存由CPU算。它没有让模型缩小,只是把装不下的那部分挪进了另一个柜子。
真正的后果是瓶颈换了位置。以前决定你能跑多大模型的是显存容量,现在变成内存容量和PCIe带宽。一张中端卡配128GB内存,有可能比旗舰卡配32GB内存跑得更多。
一个六天前建号的仓库,四天发了十个版本
今天那条帖子指向的仓库,9月24日建号。到10月4日,9194颗星。
9月30日到10月3日这四天,发了10个版本。10月2日深夜那一版把AMD一整条产品线拉进官方支持名单,从RX 9070、9070 XT到7900 XT/XTX,连工作站的R9700都在列。
官方给的速度表是这样的:一张RTX 5070,12GB显存加64GB内存,模型量化到Q2_0,93 token/s;24GB的老3090,估算在100到140之间。
冒出来的不止这一家。这几天同类项目一茬接一茬,思路都一样:不做兼容所有模型、所有硬件的通用引擎,而是为一个模型、一类硬件写一条专门的快路径。
这跟llama.cpp的选择正好相反。llama.cpp要照顾的硬件和模型太多,只能守住稳定和通用,速度上必然留余地。这批新引擎放弃通用性换速度。帖子的评论区里有人直说:这么多新引擎,每一个都比llama.cpp快。
上下文是在跟专家抢地盘的
我起初以为这类项目就是把模型塞进去、报个漂亮的速率数字。直到看见一份把八个上下文档位全测完的记录。
测试环境是一张7900 XTX(24GB)、64GB DDR3、ROCm 10.0,模型量化到IQ3_XXS。
读入prompt的速度,峰值1602 tok/s,上下文拉到256K还有1258,读满26万个token大约三分半。逐字生成的速度,16K以内83到84 tok/s。
到32K这一档,掉到48.8。
这个断崖一开始看着像玄学。原因其实很具体:投机解码的草稿层默认只回看最后32768个位置,超出之后它就看不见开头了,草拟token的接受率从93%崩到58%。把窗口参数改成65536,32K这一档回到64.5,涨了三成,而显存代价几乎是零。
真正有代价的是另一头。上下文从128K改到256K,KV缓存从1.55GiB涨到3.10GiB,这部分直接从专家缓存里扣:可用槽位从10198掉到9026,少了一成多。
后果是短prompt反而变慢了,1K档的读入速度掉了25%,因为被挤出去的那些专家只能交给CPU算。
这一组数字放在一起,是这条路上最容易被忽略的一笔账:同一块卡上,缓存长度和短对话速度是同一笔预算的两面。KV每多占一格显存,就少放一个专家。你能吞多长的文档,和你聊天时有多跟手,是同一个旋钮的两端。
快起来的另外两件事:量化和专用化
量化是把16位的权重压到3位、2位。听起来就是牺牲质量换体积。
这批量化里有个细节值得单独拎出来:IQ3的"I"指的是imatrix,重要性矩阵。它没把所有权重一刀切压到3比特,改成按重要性分配位宽:重要的权重保留Q6以上,最不重要的压到Q2以下,整体占用相当于Q3的体积。
这也顺带解释了另一件事:模型越大,越抗压。参数量里的冗余多,压掉一部分,剩下的通路还够用。
代价也真实存在。帖子里有人指出,低比特下那个coder版本会丢掉一半的专家。这不是小数目。
第二件是引擎自家的调优,噪音小,影响不小。
那位在AMD卡上做测试的人,一路把底层的矩阵库调优表补齐,读入速度从743涨到1179 tok/s,涨了58.7%。有意思的是原因:他手上那张表的版本号和运行时对不上,引擎不报错,静默回退到慢路径,回退率高达55.1%。补上两个缺失的形状,回退率降到0。
一半以上的计算都在走慢路,日志里只有一行谁也不会注意的提示。引擎慢,可能不是引擎的问题,是你手上那张表差了两行。
还有人把权重直接放到固态硬盘上
同一个思路,有人推得更狠。
133GB的权重不驻留内存。它们躺在NVMe固态硬盘上,用的时候一块块读进来,读完的先存在内存里当缓存。跑这个方案的是一张8GB的RTX 5060。
8GB对上133GB。差十六倍。
能跑起来,靠的还是那一条:大部分权重不需要同时在场。代价写在同一份说明里,9到12 tok/s。比人读字快一点,挂个长任务就是过夜的事。这条路现在是拿来看上限的,离明天就能用还差一截。
容易被看错的地方
看错一:低比特量化等于模型废了。
"4 bit是底线,再往下不能看"这句话流传很广。它有道理,从信息论上说,压得越狠丢得越多,而且丢的是哪部分权重,模型自己选不了。
但它解释不了一件事:为什么同一批低比特量化里,IQ3_XXS能有人的实测贴着未量化版本,某些任务上甚至更好用;也解释不了为什么有人用Q3的125B,效果比27B的Q6还顺手。
判断的落点不在标称位数上。要翻的是这一版量化有没有做重要性保护,方法说明里写得清楚。
看错二:token/s高就是性能好。
速率当然重要,慢到没法用就是没法用。
问题在于这个数字太容易装饰了。标不标量化位数,标不标上下文长度,缓存热没热,算不算冷启动,全都能藏。有人把133GB的权重放在固态硬盘上流式读取,一张8GB的RTX 5060跑出9到12 tok/s,数字很难看,但那跟12GB卡跑93完全不是同一件事。
能站住的规矩只有一条:速率必须和量化位数、上下文长度一起报,缺一样就没法比。
看错三:本地跑大模型是为了省钱。
省钱的说法有现实基础。帖子里有人租云上的卡,价格大约1美元一小时,在有缓存的情况下每小时能出120万token。真要单纯比单价,本地那台机器的电费和折旧未必划算。
它算不出的是另外两样东西。数据不出机器,和不用等配额、不用怕接口哪天改掉。评论区里几个换到本地的人说得很直白:换完之后很少再回落到付费接口。
本地跑大模型买的是控制权和时延的确定性,省钱只是顺手的部分。而且要把冷启动算进去,有人实测,机器暂停后再启动,把近百G的权重从磁盘读进显存要15分钟。
反方证据:同一份权重,换个引擎质量就掉
速度这一面看得差不多了,说一个不好看的数据。
同一条帖子里,另一个人想测的是它准不准。任务不复杂:50张图,每张问一个物体在哪,让它把坐标报出来。
权重没换,视觉适配器也没换。换的只是引擎。这个新引擎的中位误差154.8像素。同一个模型放在llama.cpp上,46.5。
他顺手把别的模型也测了,122B的Q3_K_M是32.9。
一个引擎的差别,比换一个量级的模型还大。掉的是视觉这种平时没人测的路径,官方速度表上一个字都不会提。
量化保护和引擎实现是两件事。前者做得再细,后者在某个环节写错了,结果照样掉。
能跑,和能用,中间还隔着几步
把它拼起来看,这条路现在的状态很清楚。
它跑得通了。4090跑124 tok/s,7900 XTX跑83,R9700跑60,都是实测数字。
但装完不是结束。你还要去补那张调优表,不然一半的计算在走慢路;要接受停机之后再启动读15分钟权重;还要记住同一个模型换个引擎,质量可能有肉眼可见的差别。这几件事,没有一件是点几下鼠标能过的。
这更像2019年前后的本地推理:现象是真的,可用性还在半路上。
这件事对你意味着什么
如果你是开发者,或者要为公司选一套能放在自己机器上的方案,现在值得动手了。先在现有的卡上试一版,重点看三个数:你实际用得到的上下文长度下,生成速率还剩多少;那一档量化能不能过你的验收;冷启动的时间你能不能接受。
如果你是装机器的人。预算表上最该重算的是内存那一栏。
过去配一台能跑大模型的机器,钱往显存上堆就对了。现在同样一笔钱,留一大块给内存容量和平台的内存带宽,性价比可能更高:16GB显存配128GB内存,很可能比24GB显存配32GB内存更实用。
以后别人问你机器什么配置,只答一句显存多少G已经不够了。
如果你只是日常用AI的人,可以再等。你真正会感受到的变化,是再过一两年,"本地的那个小助手"从玩具变成能干活的东西,离线也能用。你对"AI必须联网"的印象会慢慢松掉。
这条路接下来还能再快,但快的地方不在这块卡上。搬谁的专家、搬多少、什么时候腾位置给上下文,这类调度策略里还有没榨干的余地。相比之下,把模型做小是另一条路,眼前这条更便宜。
标题里那句"显存不够就借内存条",落到参数上其实很朴素:让闲置的部分待在该待的地方。
你手上那张卡是什么型号、跑过最大的模型多大、哪一档量化、实测多少token/s?留言给个实数,我挑几条整理成一张对照表。
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~








