


















22
20
AI做数学不再靠猜:谷歌让30个智能体互相挑错
2026-11-15 22:01:54
0点赞
0收藏
0评论
11月13日,谷歌研究团队在官方博客发了一张成绩单。第一行是 2.88万次子智能体调用,第二行是 180万行 Lean 代码,两行合起来换一份韦伊猜想的机器检查版。
这个猜想1974年就被皮埃尔·德利涅证完了。一份挂在纸上五十年的证明,被人重新抄一遍、逐行验一遍,图什么。
我把博客里那段设计说明来回读了两遍,才看清他们真正在修的东西:不是数学,是"AI怎么证明自己没骗人"这套流程。
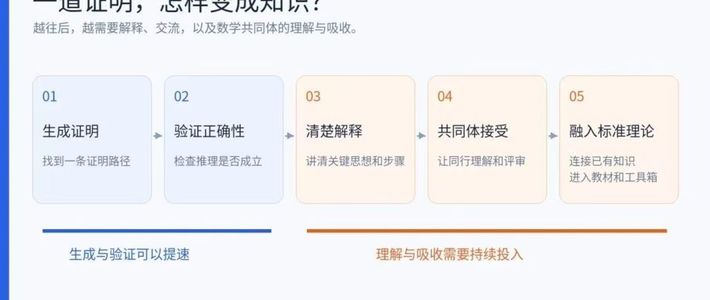
检查器只认两种结果:过,或者不过
Lean 4 是个证明检查器,装在普通电脑上就能跑。你得把推理写成它能读的代码,它一行行往下核:引用的定理在库里吗,代入的参数对不对,等价变形有没有漏掉条件。
写"显然成立"没用,它不认;中间跳过一步,它当场停下报错,只给两种回答,过,或者不过。
这种翻译活儿数学圈已经干了十几年。社区里那个叫 mathlib 的定理库,是一群人一条一条攒出来的;谷歌这次一口气交的是 180 万行。
容易读错的地方也在这儿:以为 AI 自己"想"出了新数学。这批活里 AI 干的是翻写、补洞、核对三段苦工,灵感还是人类的。
谷歌在博客里承认了两件难堪的事
第一件,模型一次生成不可预测,一次尝试和正确答案之间隔着距离,推理越长,中间拐错弯的概率越高。
他们的对策不是让模型更自信,而是多派人挑错。几个智能体分头试,Lean 4 检查器、原样不动的测试集、执行模拟器、硬件计数器负责裁决;工具说行才算行,模型之间不投票。
第二件更麻烦。任务跑上几天,上下文越堆越长,模型会忘掉前面定下的约束。谷歌的做法是把上下文切碎:每个智能体只拿到这一步要用的文件和工具,做完交给一个没看过前情的继任者;质疑者和审计者在干净上下文里复核,看不到原作者的推理过程。
人类同行评审里最难做到的那点——审稿人不知道答案是怎么来的——被搬进了工程流程。
顺带把 C++ 换成 Rust,快了30%
同一批公布的结果还有几组。核磁共振数据里认分子结构,30个专业智能体协作,Top-1 准确率 95%、Top-3 100%;自家的 AV1 解码器 libgav1 从 C++ 重写成约17万行 Rust,输出和原实现一字不差,跑起来快 20%到30%;库尔塔德-库马尔猜想的证明形式化之后,Lean 4 里是 5000万行。
数字好看,成本也摆在那儿:一个结论对着几万到几千万行代码,不是随口一问就能出的活。
这套办法,你手上的活儿也用得上
一是别让模型自己给自己打分。凡是能交给外部判定器的,就交出去——代码能不能跑、测试过不过、两份报表对不对得上、公式算出来的数是不是那个数。
二是每个环节只喂它需要的材料。整篇文档、整个仓库一股脑塞进去,它反而会漏掉关键约束;把任务切到"只解决这一步"的粒度,出错会明显少。
三是复核和创作分开。同一个人既写又审,等于没审;同一段上下文既生产又检查,等于没查。
边界很清楚:这套办法只在"存在机器可判定标准"的地方成立。写方案、做判断、谈客户,没有检查器告诉你对不对,硬套只会多花时间。
别把它读成"AI要取代数学家"
算一下账就没那么浪漫。为了形式化一个1974年就被证明的结论,花掉近3万次子智能体调用和180万行代码;那个5000万行的项目,普通团队连编译都要排队。
能被机器验证的活儿,正在被大规模自动化。写代码、改语言、对数字、验证明,这些有明确对错的地方,工具链已经能自己跑完一轮又一轮;判断"这个问题值不值得做",还留在人这边。
谷歌说 /teamwork 已经对外开放,学术研究者可以申请免费额度。想试的人不妨挑一个自己有判定器的小任务,比如让它在老项目上跑一遍测试重写,看它能不能自证。
你会把哪件"有标准答案"的活儿先交给这种互相挑错的智能体团队?留言说说,我挑几个典型的下次拆解。
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~