











2
4
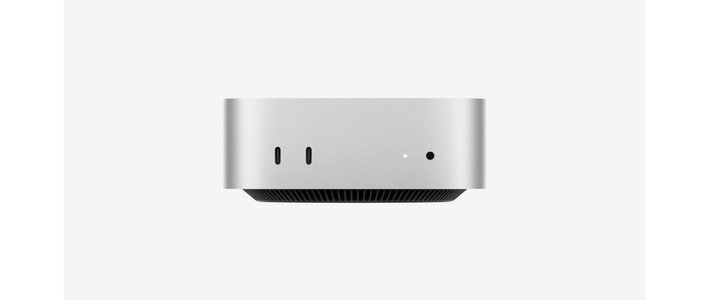
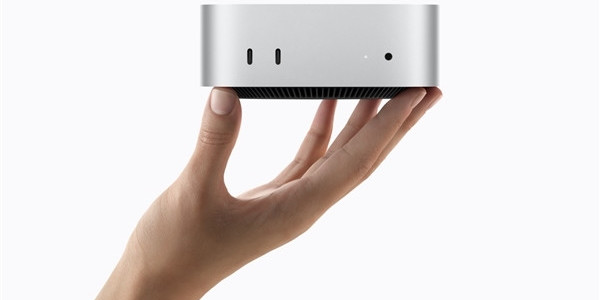
想起来就爽!两台Mac mini5通过3个雷电5链接速度360GB/s
2024-10-31 08:58:36
60点赞
378收藏
43评论
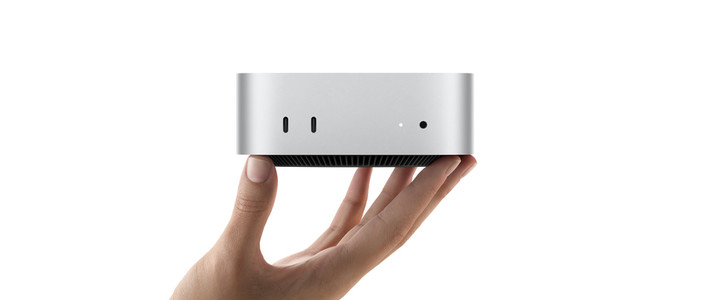
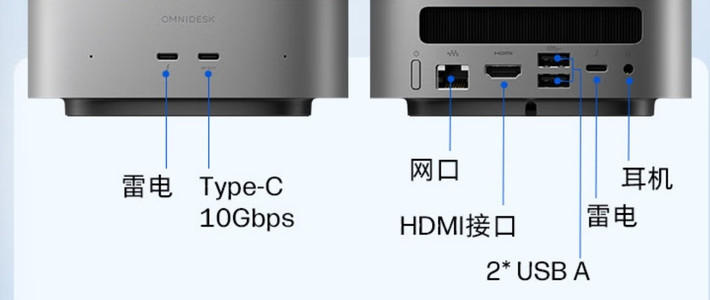
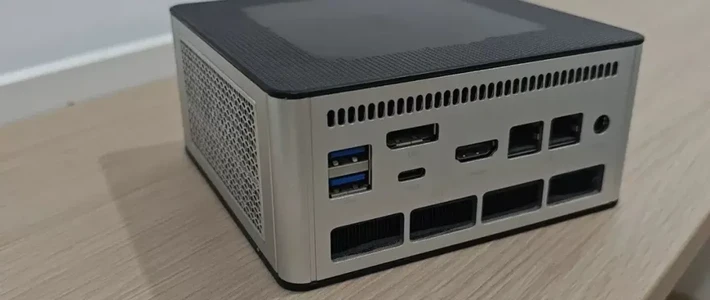
现在下单,11月8日到货,迫不及待,因为有三个雷电5,不仅可以菊花链,还可以理论上三对直连(360GB/s),玩法挺多的。下面就简单复习在两台 Mac Mini 上联合运行 LLM 大模型推理的完整指南。

在两台 Mac Mini 上联合运行 LLM 大模型推理的完整指南
您想要将两台 Mac Mini 连接在一起,联合使用它们的计算资源来运行大型语言模型(LLM)的推理任务。以下是详细的步骤,包括硬件连接方式和软件配置,以便您在两台机器上实现分布式推理。
目录
1. 硬件连接方式
• 1. 网络连接
• 2. Thunderbolt 4 直连
2. 软件配置
• 1. 环境准备
• 2. 获取 LLaMA 模型
• 3. 配置分布式计算框架
• 使用 Hugging Face Accelerate
• 4. 编写分布式推理脚本
• 5. 运行分布式推理
• 6. 性能优化
• 网络优化
• 模型优化
• 负载均衡
3. 总结与建议
4. 参考资料
硬件连接方式
1. 网络连接
这是最常见的方法,通过以太网或 Wi-Fi 将两台 Mac Mini 连接到同一网络,实现数据和任务的分配。
1.1 硬件准备
• 以太网连接:
• 网线:两根 Cat6 或以上标准的以太网网线。
• 交换机(可选):千兆或万兆以太网交换机。
• Wi-Fi 连接:
• 无线路由器:支持高速连接(802.11ac 或 802.11ax 标准)。
1.2 网络配置
• 以太网连接配置:
1. 连接硬件:将两台 Mac Mini 通过网线连接到同一个交换机,或使用交叉网线直接连接。
2. 配置静态 IP 地址:
• Mac Mini A:
• IP 地址:192.168.100.1
• 子网掩码:255.255.255.0
• Mac Mini B:
• IP 地址:192.168.100.2
• 子网掩码:255.255.255.0
3. 测试连接:
在终端中执行 ping 命令,确保两台机器互通。
• Wi-Fi 连接配置:
1. 连接到同一无线网络。
2. 确认 IP 地址在同一子网内。
3. 测试连接:使用 ping 命令验证连通性。
1.3 性能考虑
• 带宽:有线以太网通常提供更高的带宽,建议使用千兆或万兆以太网连接。
• 延迟:有线连接的延迟更低,更适合分布式计算的同步需求。
2. Thunderbolt 4 直连
如果需要更高的带宽和更低的延迟,可以使用 Thunderbolt 4 接口直接连接两台 Mac Mini。
2.1 硬件准备
• Thunderbolt 4 数据线:一根支持 Thunderbolt 4 标准的雷电数据线。
2.2 物理连接
• 将 Thunderbolt 4 数据线一端插入 Mac Mini A,另一端插入 Mac Mini B。
2.3 软件配置
步骤 1:在两台 Mac Mini 上启用 Thunderbolt Bridge。
• 打开 “系统偏好设置” > “网络”。
• 如果没有 “Thunderbolt Bridge”,点击 “+” 添加。
步骤 2:配置静态 IP 地址。
• Mac Mini A:
• IP 地址:10.0.0.1
• 子网掩码:255.255.255.0
• Mac Mini B:
• IP 地址:10.0.0.2
• 子网掩码:255.255.255.0
步骤 3:测试连接。
• 使用 ping 命令验证两台机器的连通性。
2.4 性能优化
• 网络优先级:确保分布式计算框架使用 Thunderbolt 网络的 IP 地址。
• 带宽测试:使用 iperf3 测试网络性能。
软件配置
1. 环境准备
1.1 安装 Python 环境
在每台机器上安装 Python 3.8 或更高版本,建议使用 pyenv 或 Anaconda。
# 安装 pyenv(如果未安装)
brew install pyenv
# 安装指定版本的 Python
pyenv install 3.9.7
# 创建虚拟环境
pyenv virtualenv 3.9.7 llama_env
# 激活虚拟环境
pyenv activate llama_env
1.2 安装依赖库
# 更新 pip
pip install --upgrade pip
# 安装 PyTorch(针对 Mac M1/M2 芯片)
pip install torch torchvision torchaudio --index-url 网页链接
# 安装 Transformers 库
pip install transformers
# 安装 Accelerate 库
pip install accelerate
# 安装其他必要的库
pip install sentencepiece
2. 获取 LLaMA 模型
假设您已经获得了 LLaMA 模型的权重文件,并在两台机器的相同路径下解压,例如 /home/user/llama。
3. 配置分布式计算框架
使用 Hugging Face Accelerate
Accelerate 可以简化分布式训练和推理的配置。
3.1 配置 Accelerate
在每台机器上运行:
accelerate config
根据提示进行配置:
• 运行类型:选择 0(This machine)。
• 进程数量:输入 2。
• 多机模式:输入 yes。
• 机器排名:
• 主机(Mac Mini A):输入 0。
• 从机(Mac Mini B):输入 1。
• 主机 IP 地址:输入 主机的 IP 地址(例如 10.0.0.1)。
• 通信端口:输入 29500 或其他未被占用的端口。
完成后,Accelerate 会生成配置文件。
4. 编写分布式推理脚本
创建 llama_distributed_inference.py,内容如下:
from transformers import LlamaForCausalLM, LlamaTokenizer
from accelerate import Accelerator
import torch
# 初始化 Accelerator
accelerator = Accelerator()
# 加载分词器
tokenizer = LlamaTokenizer.from_pretrained('/home/user/llama')
# 加载模型
model = LlamaForCausalLM.from_pretrained('/home/user/llama')
# 准备模型
model = accelerator.prepare(model)
# 准备输入数据
input_text = "你好,世界!"
inputs = tokenizer(input_text, return_tensors="pt")
# 将输入移动到设备
inputs = {key: value.to(accelerator.device) for key, value in inputs.items()}
# 进行推理
with torch.no_grad():
outputs = model.generate(**inputs, max_length=50)
# 解码输出
output_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
# 仅在主进程打印结果
if accelerator.is_main_process:
print(f"输入: {input_text}")
print(f"输出: {output_text}")
5. 运行分布式推理
在两台机器上分别运行:
accelerate launch llama_distributed_inference.py
Accelerate 会根据配置文件自动处理多机通信和进程启动。
6. 性能优化
网络优化
• 带宽:使用有线连接,如千兆以太网或 Thunderbolt 4,来提高带宽。
• 延迟:确保网络设备支持低延迟传输。
模型优化
• 模型量化:使用 8-bit 或 4-bit 量化来减少模型大小。
pip install bitsandbytes
在加载模型时:
model = LlamaForCausalLM.from_pretrained('/home/user/llama', load_in_8bit=True)
负载均衡
• 手动指定设备映射:
from accelerate import infer_auto_device_map
device_map = infer_auto_device_map(
model,
max_memory={0: "16GB", 1: "16GB"},
no_split_module_classes=["LlamaDecoderLayer"],
)
model = accelerator.prepare_model(model, device_map=device_map)
总结与建议
• 硬件选择:根据需求选择合适的连接方式,Thunderbolt 4 提供更高的带宽,但配置稍复杂。
• 环境一致性:确保两台机器的软件环境、库版本和模型路径一致。
• 网络配置:正确配置网络设置,确保分布式计算框架使用高速连接。
• 性能优化:通过网络和模型的优化,最大化利用硬件资源。
参考资料
• 网页链接{Hugging Face Accelerate 文档}
• 网页链接{PyTorch 分布式训练教程}
• 网页链接{使用 iperf3 测试网络带宽}
• 网页链接{Apple 官方支持:在 Mac 上使用 Thunderbolt 设备}
• 网页链接{macOS 下的网络接口配置}
如果您在配置过程中遇到任何问题,欢迎继续提问。











校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案