














10
4
06|MCP:给 Agent 接外部工具和数据
2026-09-21 14:09:34
0点赞
0收藏
0评论
本篇是《从头重新学 AI 编程》系列第 6 篇。
先说一句,如果你现在还没用过 MCP,这篇可以先当概念看,不用有任何压力。真正决定你 AI 编程体验的,还是前面那几篇讲的 Spec、AGENTS.md 和上下文管理。等你哪天开始觉得「AI 就差那么一点点信息」的时候,再回来看这篇,会更有感觉。
前五篇我们聊的东西,角色转变、Spec、AGENTS.md、冷启动、上下文管理,全都是在「怎么跟 AI 协作」这个层面打转。
从这一篇开始,往工具层面走一点。
我想聊一个你大概率已经在各种地方刷到过的词,MCP。
这个词现在被传得有点神。有人说它是 AI 编程的未来,有人说它就是过度工程,搞那么复杂干嘛。我自己用了一段时间之后的看法比较朴素,它就是个工具,解决一个很具体的问题,不神,但挺有用。
先说它到底是个啥。
MCP 全称 Model Context Protocol,是 Anthropic 在 2024 年底提出来的一个开放协议。现在 OpenAI、Google、Cursor、Claude Code、Codex 基本都支持了。
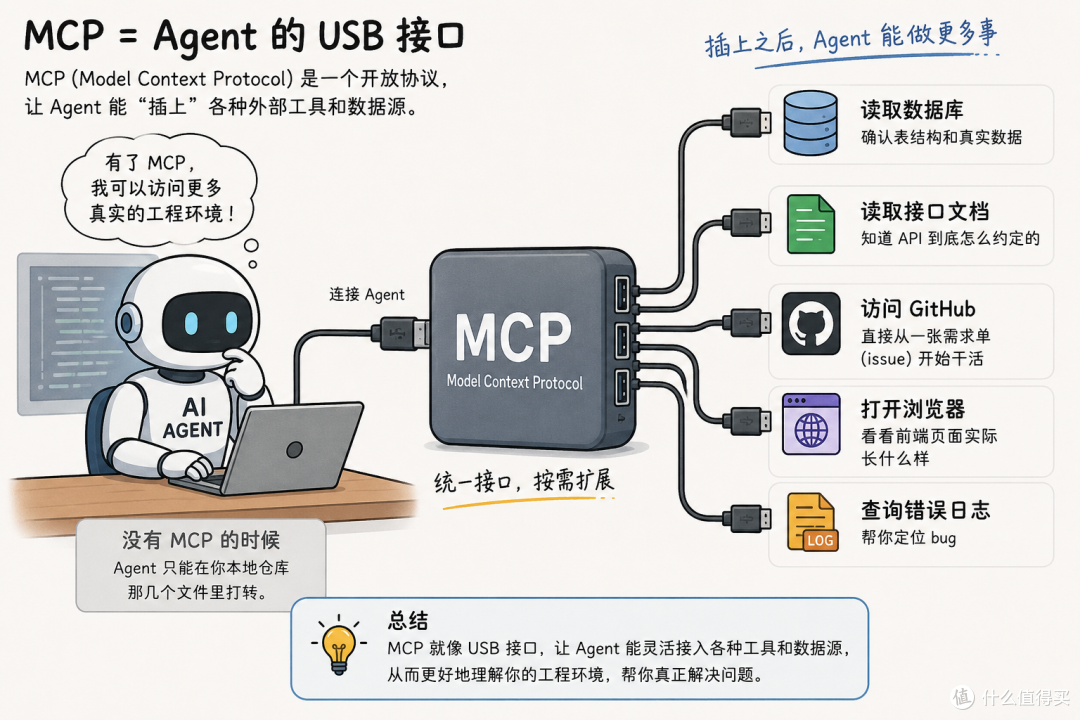
名字听着唬人,但你可以把它理解成一个特别简单的东西,Agent 的 USB 接口。
你想想看,你的电脑为什么能插 U 盘、插鼠标、插摄像头?因为有 USB 这个统一接口,不用每个设备都单独配一套专用插槽。MCP 干的就是这事,它让 Agent 能「插上」各种外部的工具和数据源,不用每接一个新东西就单独写一套集成。
插上之后能干嘛呢。它可以读你的数据库,确认表结构和真实数据。可以读你的接口文档,知道 API 到底怎么约定的。可以访问 GitHub 上的 issue,直接从一张需求单开始干活。可以打开浏览器,看看前端页面实际长什么样。还可以去查错误日志,帮你定位 bug。
没有 MCP 的时候,Agent 只能在你本地仓库那几个文件里打转。有了 MCP,它能伸手够到你真实的工程环境。
说到这,你可能会有个很自然的疑问,我现在不用 MCP,AI 写代码不也写得好好的吗?为啥非要搞这个。
这个问题问得对。我一开始也是这么想的。
但后来我遇到过太多次一种情况,AI 写出来的代码「看起来对」,但「实际上不对」。而且问题往往不在代码本身,是在它缺信息。
我给你说个特别典型的。还是我们这个系列的待办事项应用,你让 AI 帮你写一个查询待办列表的接口。它写得有模有样,逻辑也通顺,结果一跑,报错。为啥?因为它用的字段名跟你数据库里的对不上。
它不是不会写,是它压根没看过你的数据库 schema,它在那猜了一个名字。
这种时候你要是接了数据库的 MCP,它就能直接去查表结构,字段名一个都不会错。
再说个更常见的。你在修一个 bug,AI 改完代码跟你说「应该没问题了」。但你心里没底,因为你没有一个方便的办法去验证它改得到底对不对,只能自己打开页面点半天。
如果接了浏览器的 MCP,它能自己把页面打开,截个图给你看改完之后长什么样。
所以 MCP 解决的核心问题,其实就一句话,让 Agent 从「只能看代码」变成「能看到真实环境」。

光说概念有点虚,我用待办事项应用给你过三个具体场景,你就懂了。
第一个,读数据库 schema。
你让 AI 加一个筛选功能,它得知道你那张待办表有哪些字段。没 MCP 的时候,你要么自己把 schema 文件复制给它,要么让它去翻代码里的 migration 文件,绕一圈。
接了数据库 MCP,你直接说,
查一下 todos 表的结构,然后基于现有字段实现筛选功能。
它直接连数据库拿到真实表结构,字段名、类型、索引,全是准的。
第二个,读接口文档。
你这个应用前后端分离,前端要调后端的 API。AI 写前端的时候得知道后端接口长啥样,返回什么格式。
接了 GitHub MCP 或者文档类的 MCP,你可以让它直接去读,
读一下后端的 API 文档,看看 /api/todos 这个接口返回什么格式,然后写前端的请求层。
它不用猜返回结构,照着文档来就行。
第三个,访问 GitHub issue。
这个是我自己用得最爽的。你 issue 列表里躺着一条「待办事项支持拖拽排序」,你想让 AI 直接从这条 issue 开始干。
接了 GitHub MCP,
读一下 issue #42,理解需求,然后出一个实现计划。
它直接把 issue 内容读进去,连带着下面的讨论、背景一起理解,然后开始干活。你不用再手动把 issue 复制粘贴一遍。
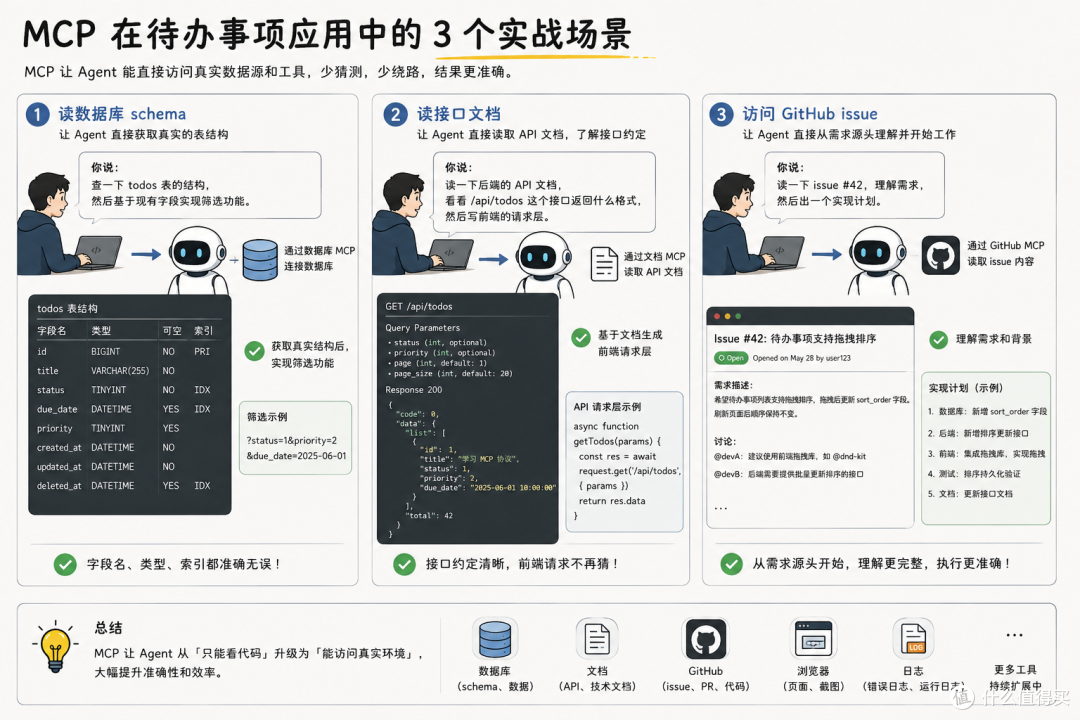
你看,这三个场景排下来,其实是一个越来越爽的过程。从「省得我贴 schema」,到「省得我查文档」,再到「省得我连需求都不用转述」。Agent 离你真实的工作流越来越近。
那配置起来难不难?
坦率的讲,没你想的难。主流工具的配置方式都差不多。Claude Code 是在 .mcp.json 文件里配,或者用 claude mcp 命令管理。Cursor 在设置界面或者 .cursor/mcp.json 里配。Codex 也有类似的连接器管理。
一个 MCP server 启动之后,会向 Agent 注册一组工具。Agent 需要的时候自己去调,对你来说是透明的,就跟它平时调用读文件、跑命令没什么区别。
不过这里有个坑我得提醒你一下,MCP 不是开得越多越好。
每个 MCP server 都会往 Agent 那儿注册一堆工具的描述信息。而这些描述,每一轮对话都要占上下文。
你还记得上一篇我们聊的上下文预算吗?开太多 MCP,结果就是你还没开始干活,上下文就先被这些工具说明给吃掉一大截。
所以我自己的几个习惯是这样的。按任务开,做后端 API 的时候把浏览器 MCP 关了,等做 UI 的时候再开。按项目配,在 AGENTS.md 里写清楚这个项目默认启用哪几个 MCP。然后定期清理,三个月没碰过的 server,删掉就完事了。
还有一件事我得点一下,但不展开。
接的工具越多,权限风险就越高。
MCP 把 Agent 的能力边界从你的仓库里,一下子扩到了仓库之外。这是好事,但它同时也把攻击面给放大了。你接多少个 server,约等于给 Agent 发了多少张门卡,每一张你都得想清楚,它需要什么权限,绝对不能碰什么。
比如数据库,给只读账号,别把生产库的写权限随手交出去。GitHub 的 token,权限能多小就多小。
这些细节我放到第 12 篇的反模式清单里专门讲,那篇会把安全的事一次性聊透,这里你先有个意识就够了。

回到 MCP 本身。
我自己的建议是,别一上来就把能接的全接上。先从你当下最缺的那一个开始,大概率是数据库 MCP,因为字段对不上这种事真的太常见了。接上用一阵子,等你确实感觉到「这个环节天天要手动喂信息给 AI」,再考虑加下一个。
工具是用来减少摩擦的,不是用来给自己增加配置负担的。
给你一个小练习。
打开你现在手头的项目,就接一个 MCP,数据库或者 GitHub 都行,挑你最常需要的那个。接完之后,让 AI 做一件以前你得手动喂信息它才能做的事,比如基于真实表结构写个查询。
你会很明显地感觉到,它从「猜」变成了「知道」。这个差别一旦体会过,你大概就回不去了。
下一篇我们聊另一个工具层面的东西,Subagent,怎么让不同的 Agent 各司其职,别把实现、审查、搜索、测试全塞进同一个聊天窗口里。跟这篇一样,如果你现在只用单个对话也完全够用,可以先理解思路,等项目复杂起来再落地。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~










