









3
5
04|冷启动一个旧项目,怎么让 AI 快速看懂代码
2026-09-15 17:11:10
0点赞
0收藏
0评论
本篇是《从头重新学 AI 编程》系列第 4 篇。
前三篇我们聊的都是「怎么跟 AI 协作」这个大方向,角色转变、写 Spec、写 AGENTS.md。这些东西更偏思维层面,你知道了就知道了。
但从这一篇开始,场景会更具体一些。
我想聊一个几乎每个人都会遇到的情况,你接手了一个已有的项目,不是你从零写的,可能是别人留下来的,可能是你自己半年前写的但已经忘了细节。然后你想用 AI 帮你干活。
这个时候你会怎么做?
我见过最多的做法是,打开 Claude Code 或者 Cursor,第一句话就是「帮我加一个 XXX 功能」。
AI 不了解这个项目。但它不会告诉你它不了解。
它会自信满满地开始写代码,用它自己习惯的风格,改它自己觉得该改的文件,引入它自己觉得合适的依赖。结果你拿到一堆能跑但跟项目格格不入的代码。风格不对、结构不对、约定全都不对。
然后你开始改,改了三轮越改越乱,最后整个重来。
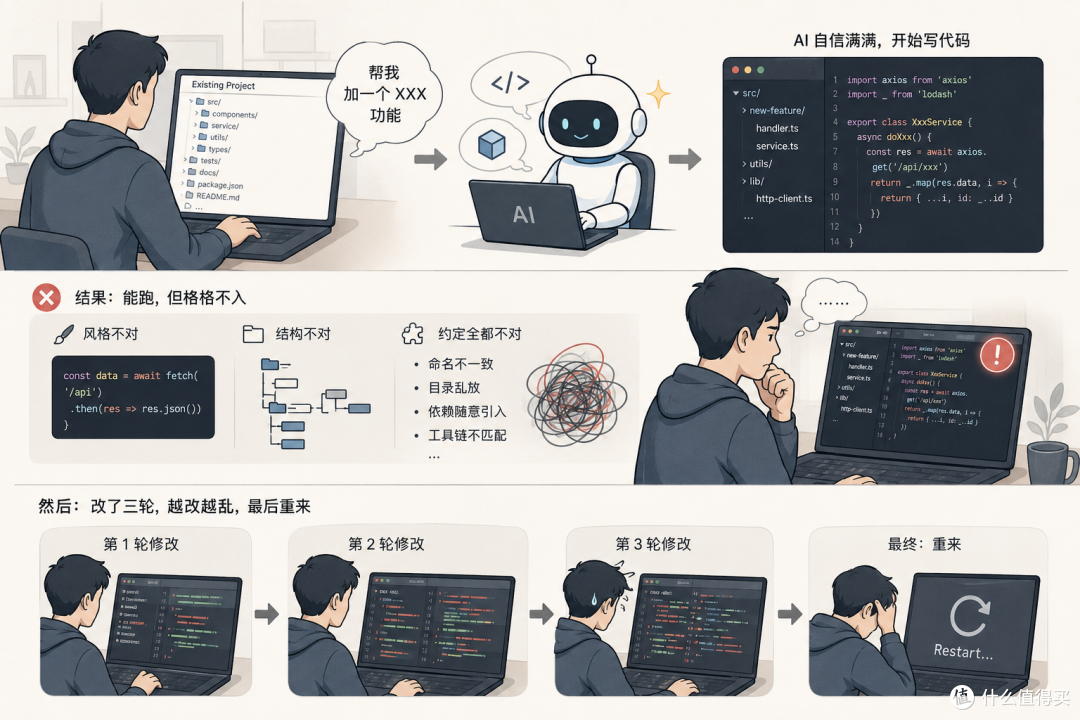
这种体验我自己经历过好几次。后来我想明白了一件事,问题不在 AI 能力不行,是我跳了一个最关键的步骤。
先让它理解,再让它动手。
这话听着像废话对吧。但你回想一下自己上次接手别人项目的时候,你是不是也是先花了一两天读代码、跑环境、问前任开发者各种问题,然后才敢动第一行代码?
你自己都需要这个过程,AI 也需要。区别是 AI 不会主动告诉你「等等我还没看懂」,你得逼着它先看。
具体怎么做呢。
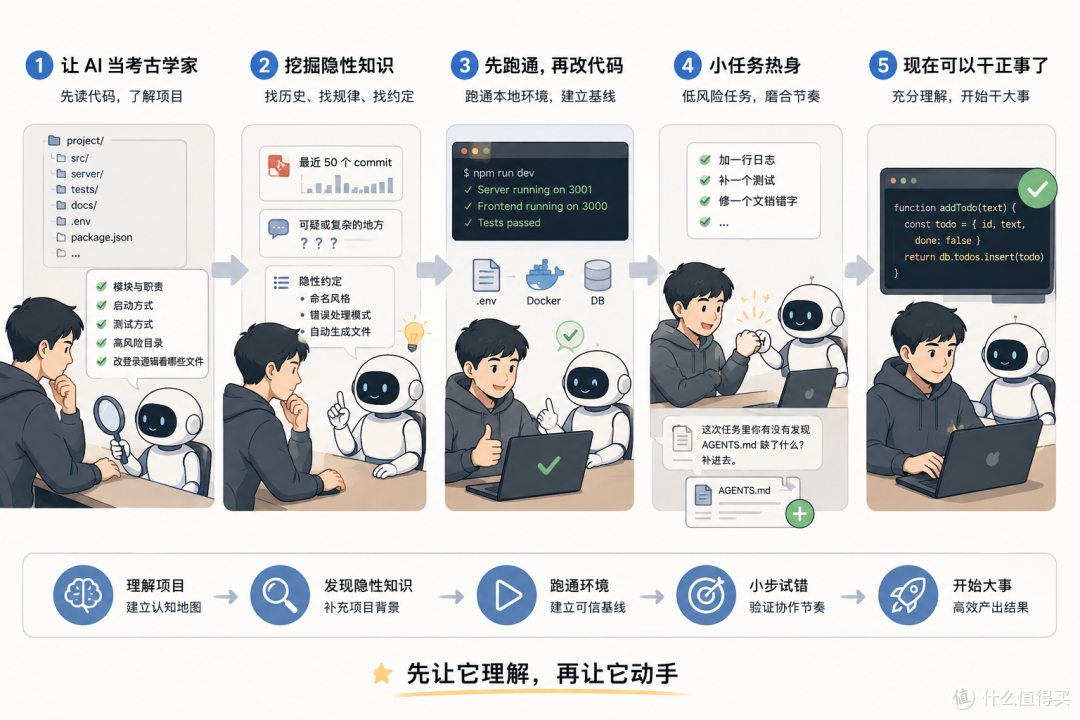
第一步,让 AI 当考古学家。
接手一个项目,第一件事不是让它写代码,而是让它读代码。我自己用得最多的一个 prompt 是这个,
先不要改代码。请帮我阅读当前项目结构,并输出,
1. 项目主要模块和职责
2. 启动方式
3. 测试方式
4. 可能的高风险目录
5. 如果我要改登录逻辑,应该先看哪些文件
这段 prompt 的核心就四个字,先读后写。
你让 AI 做的事是理解,不是改造。它输出的结果就是它对这个项目的理解报告。
以我们这个待办事项应用为例,AI 看完之后可能会输出这样的东西,
项目主要模块和职责,
- src/components/ — 前端组件,负责 UI 渲染
- src/api/ — 前端 API 调用层,封装所有后端请求
- server/routes/ — 后端 API 路由
- server/db/ — 数据库 schema 和迁移文件

启动方式,
- 前端 npm run dev(端口 3000)
- 后端需要先启动 server/ 下的服务(端口 3001)

测试方式,
- npm test(运行 Jest 测试套件)
- npm run lint(ESLint 检查)

高风险目录,
- server/db/migrations/ — 数据库迁移,改动可能影响已有数据
- src/api/ — API 层,改动影响前后端通信

改登录逻辑应该先看,
- server/routes/auth.js — 认证路由
- src/api/auth.ts — 前端认证 API 封装
- src/components/Login.tsx — 登录组件
看起来还不错对吧。模块识别对了,启动方式说对了,高风险目录也点到了。
但这里有个坑。你不能直接信。
你得自己过一遍,看几个地方。
它有没有遗漏关键信息?比如这个项目有 .env 配置文件,有 Docker 配置,有数据库迁移脚本,这些它提到了吗?遗漏了就说明它没有扫描到这些文件。
它说的高风险目录对不对?有些目录看起来不起眼但其实很关键。如果它说「所有目录风险差不多」,那说明它没深入理解。
它给出的文件路径是不是真实存在的?AI 有时候会幻觉出一些根本不存在的文件名。你随手去目录里确认一下就行。
它对模块职责的描述准不准确?如果它说 src/api/ 是后端路由,那它搞混了,这个目录明明是前端的 API 封装层。这种错误说明它没有真正理解代码结构。
发现理解有偏差的地方,直接纠正它,
你说的 src/api/ 职责不对,它是前端的 API 封装层,不是后端路由。后端路由在 server/routes/ 下。请重新理解。
AI 会根据你的纠正调整。这个过程本身就是你在建立对项目的掌控感。
坦率的讲,很多人会觉得这一步浪费时间。「我直接让它写不就行了,错了再改嘛。」
但你用一段时间就会发现,先花五分钟让它读一遍,比后面花三十分钟改烂摊子划算太多了。
好,第二步,挖掘隐性知识。
上一步让 AI 了解了项目的骨架。但每个项目都有一些只活在老员工脑子里的东西,隐性约定、历史教训、大家都这么做但没人写下来的规矩。
这些东西代码里看不出来,但你可以让 AI 帮你挖。
翻一下最近 50 个 commit,看看有没有反复修同一个 bug 的情况。
这通常意味着那里有隐藏的复杂度。
找出代码里你觉得可疑或者看不懂的地方。
找出约定但没写下来的东西,
- 命名风格是驼峰还是下划线
- 错误处理有什么模式
- 哪些文件是自动生成不要手改的
这些问题的答案,就是 AGENTS.md 里最该补充的内容。你在第 3 篇里写的那份 AGENTS.md,到这里就可以进一步完善了。
第三步,先跑通,再改代码。
这个我反复强调,本地环境没跑通之前,不要改任何代码。
为什么?因为你不知道改之前是什么样,就没办法验证改之后有没有出问题。AI 告诉你「这个改动应该可以」,你没有任何办法证伪。
让 AI 帮你把项目跑起来,
帮我把这个项目在本地跑起来。
遇到错误就告诉我,不要瞎猜配置。
把每一个手动步骤记下来,完事后我们更新到 AGENTS.md。
跑通的过程本身就是在读代码。报错信息会逼着 AI 和你去读关键的配置文件、入口文件、依赖关系。很多隐性知识就在这一步浮出水面,某个环境变量没文档、某个端口被占了、某个服务要先起来。
跑通等于你手里有了一个已知能 work 的版本。后面任何改动失败了,你都能退回这个状态。没有这个基线,出问题的时候你分不清是改坏的还是本来就是坏的。
第四步,做一个低风险的小任务热身。
环境跑通了,先别急着上大功能。挑一个最小的事,加一行日志、补一个测试、修一个文档错字,什么都行。
借这个小任务跑一遍完整的「读代码 → 修改 → 测试 → 提交」循环。你和 AI 都在这个过程中磨合协作节奏。
跑完之后问 AI 一句,
这次任务里你有没有发现 AGENTS.md 缺了什么?补进去。
AGENTS.md 是活的,每次协作都应该让它变得更完整一点。
第五步,现在可以做你真正想做的事了。
经过前面四步,AI 已经对项目有了相当的了解。你手里有了跑通的本地环境、更新过的 AGENTS.md、和一个验证过的协作节奏。
这时候再让 AI 做你真正想做的事,结果会好太多。
顺着这个再聊一下,如果你不是接手旧项目,而是从零开始呢?
流程会不太一样。
从零开始的话,第一件事是先写 Spec,不是先写代码。你可以跟 AI 说,
我要做一个 X,大概这样这样。帮我先写一个 spec,不要写代码。问我所有不清楚的问题。
让 AI 反问你 5 到 10 个问题。这些问题本身就是冷启动最大的价值,它逼你想清楚边界。
然后让 AI 出技术方案,
基于这份 spec,提出 3 套技术方案,各自的取舍是什么?先不要建文件。
确定方案后,让 AI 初始化项目骨架和 AGENTS.md。初版不用追求完美,先保证有,后面边用边迭代。之后就是小步建设,每个 session 完成一个明确的单元,提交一次。
好,回到整个冷启动这件事。
我觉得很多人用 AI 写代码效果不好,不是因为 AI 不够聪明,而是因为一上来就让它跑,没有给它一个认识项目的过程。你自己接手别人项目都需要几天适应期,AI 也一样,只不过它的适应期可以被你压缩到十五分钟。
关键就一句话,先让它当考古学家,再让它当施工队。
给你一个小练习。打开你手头一个已有的项目,用这篇里那段「先读后写」的 prompt 让 AI 做一次考古。看看它输出了什么,有没有理解错的地方,有没有遗漏的信息。然后把发现补充到 AGENTS.md 里。
下一篇我们聊一个很多人遇到过但不知道怎么处理的问题,AI 走偏了怎么办,上下文管理。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~