













5
5
30B大模型装进手机内存扛不住?江波龙给存储“加码”
2026-09-28 20:18:23
0点赞
0收藏
0评论
过去几年里,手机厂商在AI上的竞争,基本都围绕着我们非常熟悉的几个点展开:模型参数、NPU算力、端侧部署能力。尤其在人均端侧AI的当下,AI已经成为手机的「必备」功能之一。
而随着手机AI能力的不断增强,新的问题也随之出现:芯片的算力越来越大,模型在运行时要处理的数据也越来越多。处理器算得再快,也得先拿到数据,模型越大,需要存放和调度的数据越多,存储和内存也自然成为影响端侧AI体验的重要一环。
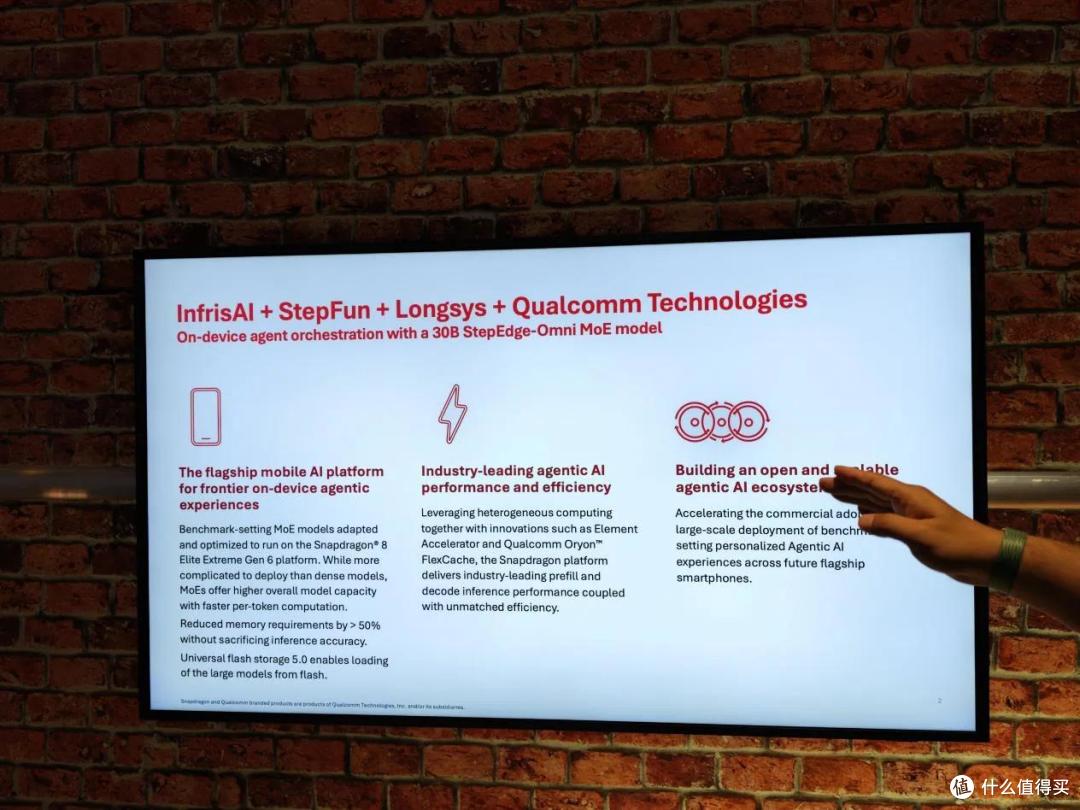
在今年的高通骁龙峰会上,江波龙带来的iSA智能体成为首批适配高通第六代骁龙8超级至尊版的产品,并配合UFS 4.1亮相。此前iSA已经在AMD锐龙 AI Max+395平台完成联合调优,如今又适配了旗舰手机平台。它想要解决的正是手机市场当今遇到的难题:当端侧模型越来越大,手机AI的竞争已经不能只看CPU、GPU 和NPU,数据放在哪,怎么调用,同样会影响用户的实际体验。
大模型塞进手机,先扛不住的是内存?
过去手机上的AI,大多数执行的是单次任务,比如识别一张照片、总结一段文字、任务持续时间短,需要同时处理的数据也不多。但现阶段的Agent不一样,它需要理解上下文、拆解任务、调用不同模型,有些任务还会持续运行很长时间,模型规模和运行时间也在持续不断地增加。问题在于,手机的DRAM容量跟不上模型规模增长的速度。
这个问题已经发展到什么程度了?江波龙副总裁、嵌入式存储事业部总经理黄强在接受雷科技专访时表示:目前旗舰手机的DRAM普遍为12GB到16GB,应付现在的日常需求完全够用,但随着30B级大模型开始进入手机,对容量、速度、功耗、成本和能效比都提出了更高的要求。手机内部空间和散热条件有限,也没法像云端服务器一样不断增加硬件资源。
江波龙旗下慧忆微副总裁王舒翀进一步解释,安卓系统本身就要占用几GB内存,如果再运行一些大型App,真正能够留给AI的空间其实没有多少。而一个没有经过充分压缩和优化的30B模型,仅参数就可能占用约30GB。
也就是说,即便当前最高端的旗舰手机,也无法把模型参数全部塞进DRAM。
而此次高通峰会上展示的30B MoE模型,对模型、推理和存储都做了针对性优化,模型侧可以通过剪枝、量化等方式继续压缩,MoE架构每次推理又只会激活一部分专家参数,再配合端侧推理和存储优化,最终把运行过程中需要占用和调度的资源控制在数GB量级。按照江波龙的说法,目前这套30B模型已经可以在手机参考设计上流畅运行。
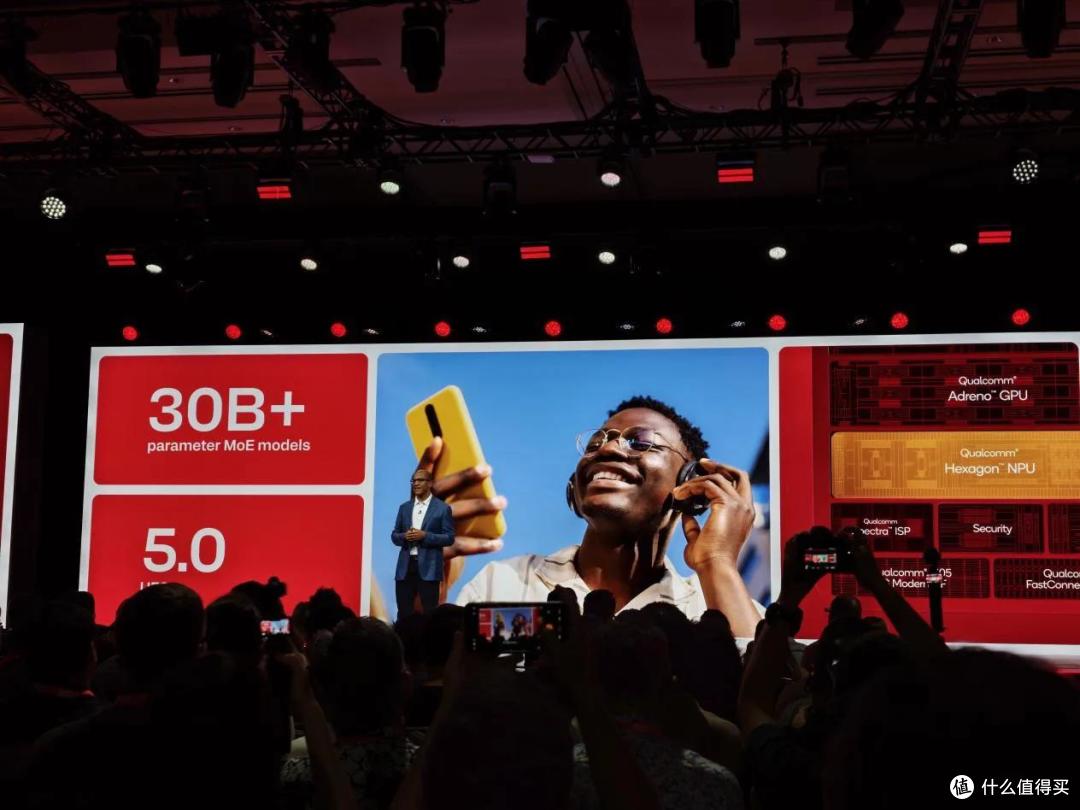
MoE,也就是混合专家架构,现在已经被越来越多的大模型采用。它的原理很好理解:一个MoE模型里有很多负责不同任务的「专家」,在每次推理时不会把所有专家都「派出来」,是根据任务的需求选择其中一部分参与计算。
既然一次只会用到部分专家,那些暂时没有被激活的参数,也就没必要一直放在DRAM「占位置」。而江波龙的iSA就把专家放在容量更大的手机NAND中,等模型需要调用这些「专家」时,再把对应参数搬进DRAM里。
好的,空间的问题是有办法解决了,但读写速度又成了新难题。
王舒翀表示,手机上普通App、照片、文件的数据通常比较连续,NAND很多时候可以顺着往下读,就像是拿着一本书从前往后翻,前后内容挨在一起,阅读速度很快。但MoE不一样,它每次需要调用哪个专家都要根据当前任务决定,这一次可能调用专家A,下一次又可能是专家F,更像是看一本工具书,需要什么就直接翻到对应的章节。
这种读取方式对存储的要求也变了。过去很多数据可以一口气连续读取,现在模型可能频繁在不同专家之间切换,NAND需要不断读取不同的数据,随机读取的重要性也随之提高。对于端侧大模型来说,UFS光有很高的顺序读取速度还不够,在面对这种更零散的数据调用时同样得足够快。
更麻烦的是,哪怕NAND读写再快也比不上DRAM。模型需要的专家如果已经在DRAM里,手机NPU就可以直接拿来计算,但如果还躺在NAND里,就要先读取搬运过来后再进行计算,输出速度又会受到影响。
而iSA要处理的,就是这个问题。
把模型装进手机,只解决了一半问题
江波龙给出的办法是「智能预取」:尽量赶在NPU真正需要某个专家之前,就把对应的数据从NAND调进DRAM。
但想提前读取还有个前提:iSA得知道模型接下来可能会用到哪些专家。
iSA会参考模型本身的运行规律,同时结合当前的上下文。首次加载时,可以先参考已有的专家激活规律;进入推理阶段后,用户输入的Prompt、此前的上下文,以及当前所处的推理阶段都会成为参考信息。上层推理引擎会把这些信息传递给iSA,iSA再据此判断接下来可能用到哪些专家,并提前准备相应的数据。
比如用户刚刚还在向模型查询夏威夷茂宜岛的相关信息,下一轮继续询问当地酒店、景点的概率,显然比突然跳到北京天气要高。对于模型来说,前后两轮对话存在上下文联系,对应的专家调用也有一定规律,iSA可以利用这些信息扩大预取范围,提前把可能用到的专家从NAND调进DRAM。
当然,预取就算再聪明,也不可能每次都猜中。如果提前调进DRAM的专家最后没有被用到,真正需要的数据还是得重新从NAND读取。王舒翀透露,iSA的预取策略也可以根据实际情况调得更激进或者更保守:多预取一些,命中的机会更高,但会带来额外的I/O;少预取一些,对存储的压力更小,但预测失败时等待时间也会更长。不同模型的专家激活规律存在差异,因此iSA现阶段还需要针对具体模型和推理引擎做相应适配。
iSA解决了什么时候该取、该取哪些数据的问题,但具体的数据读写还得落到存储硬件上。这次和iSA一起亮相的江波龙UFS 4.1,就承担起了这部分工作。
前文曾提到,MoE调用专家时的数据读取比较零散,对随机读取的要求也更高。江波龙UFS 4.1配合慧忆微自研主控,可以针对这类AI负载优化随机读取效率和访问延迟,让iSA提前选中的专家参数更快从NAND调入DRAM,尽量减少NPU等数据的时间。
再往下还有慧忆微的自研UFS主控,除了完成实际的数据读写,还负责数据放置、空间管理和磨损均衡等工作,对存储寿命和长期稳定性也会有帮助。
除了MoE专家权重,大模型在运行过程中还有一个东西会持续吃掉内存——KV Cache。
大模型进行多轮对话时,为了减少重复计算,会把此前已经计算过的一部分信息保留下来。聊得越久、上下文越长,KV Cache占用的空间也会跟着增加。以前手机AI做一次图片识别或者文字总结,任务很快就结束了;Agent以后可能连续规划一次旅行、分析一份长文档,甚至跨多个App持续工作,对KV Cache的需求也会明显增加。
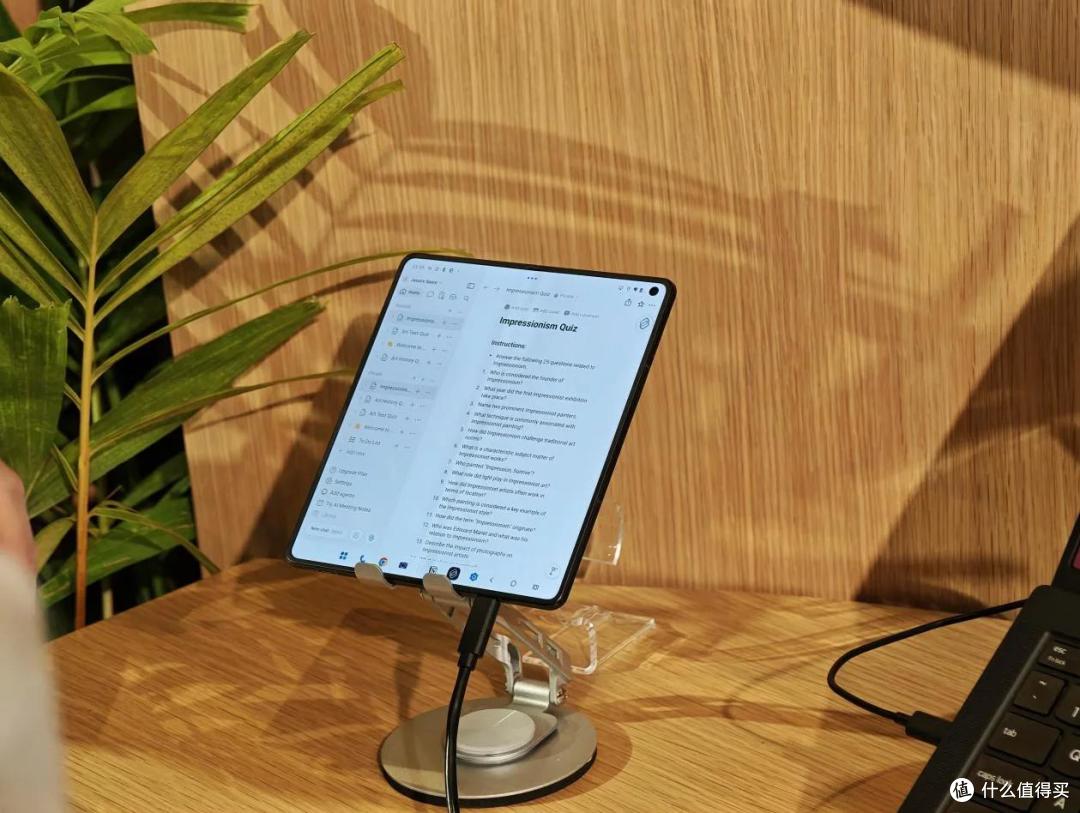
手机只有十几GB DRAM,还得同时留给系统和其他App,KV Cache自然不能一直往里面堆。iSA会对这部分数据进行分层管理,把一部分缓存放到容量更大的存储中,同时清理已经没有必要继续保留的缓存。这样一来,专家权重和KV Cache都可以根据实际使用情况在DRAM和NAND之间调度,尽量把有限的DRAM留给当前更需要的数据。
当然,把更多AI运行数据交给NAND之后,另一个问题也随之出现:闪存的寿命会不会受到影响?
毕竟Agent如果以后真的变成手机常驻功能,模型参数和相关数据每天都会被频繁访问,内存要面对的读写压力会变大,时间一长自然会让人担心寿命。对此黄强表示,十几GB的模型对于DRAM来说很大,但放进256GB、512GB的NAND里,占比就小了很多,对寿命的影响相当有限。而且慧忆微自研主控还可以配合iSA进行寿命管理、空间优化和磨损均衡,如果某些区域写入次数过多,可以重新调整数据位置,避免长期集中擦写。
不过目前Agent还没有真正成为手机上的高频常驻应用,不同模型的读写方式、使用频率和工作负载也不一样。如果以后AI一天运行几个小时甚至长期挂在后台,对NAND的写入量、功耗和温度究竟会增加多少,还得等真实终端长期运行之后再能知晓。
同样需要等量产产品验证的,还有iSA最终能省下多少DRAM、降低多少首Token延迟,以及提高多少Token生成速度。不同模型的专家激活规律会影响预取效果,换一套模型、推理引擎甚至终端环境,最后得到的数据都有可能不同。
从Demo到量产,iSA离我们还有多远?
第六代骁龙8超级至尊版并非iSA首次适配的计算平台。此前江波龙已经在AMD锐龙AI Max+ 395平台上完成联合调优,覆盖了AI PC、AI BOX等产品形态。但在手机上,情况又有些不同。手机的内存容量更小,对功耗和散热也更加敏感,iSA需要面对的限制自然更多。
当然,iSA目前最大的问题还是适配。不同大模型的专家激活规律不一样,iSA需要根据模型特点分别调整。这次Demo使用的是阶跃的模型和无量火的推理引擎,江波龙需要和两边共同优化。到了真正的手机产品上,还要考虑手机厂商自己的模型、系统调度和App策略。用同一套预取策略很难复刻所有的结果。
不过好消息是,硬件这边已经准备得差不多了。黄强在专访中表示,搭载慧忆微自研主控的江波龙UFS 4.1标准产品已实现批量出货,并具备规模化量产商用的条件。下一步将推动 iSA 导入具体手机项目,针对功耗、稳定性和可靠性做进一步验证。
所以iSA距离真正出现在量产手机上,目前主要差的是最后的适配和工程化工作。
对于江波龙来说,这最后一步可能比之前的还重要。参考设计上的30B MoE证明了这套方案是完全可行的,但手机厂商真正关心的还是用了iSA之后能省下多少DRAM、首Token延迟能降低多少,长时间运行又会增加多少功耗。这些数据只有在量产机上运行后,才真正有说服力。
而对于我们普通用户来说,大家并不在意专家参数究竟放在DRAM还是NAND里,也不会在意这套算法背后做了多少次智能预取。最后能感受到的,无非是手机上的Agent响应会不会更快,长时间使用AI手机的功耗会不会增加以及后台挂着AI时会不会影响其他App的使用。
如果iSA最后能把这些问题处理好,江波龙这次在骁龙峰会上展示的30B MoE,可能就不只是一个Demo了。
至少下一次我们再聊起手机端侧AI,除了看SoC和模型,可能还得多看一眼存储。