








 深耕数码、汽车、AI兴趣领域


11
9
国产AI开始自我优化国产芯片:GLM-5.3 Flash两周实现3.2倍性能
2026-09-17 19:20:33
0点赞
0收藏
0评论
快科技9月17日消息,新一代大模型开始转向RSI自我递归升级,国内的大模型公司智谱今天也宣布这方面的进展,GLM-5.3 Flash在两周时间内自我优化大幅提升了国产AI芯片的性能。
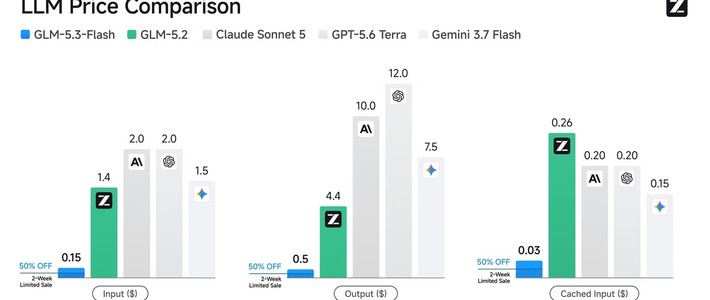
GLM-5.3 Flash是智谱前不久才发布的多模态大模型,跟GLM-5.3相比速度快得多,而且是首次使用了全国产芯片部署,多达10万块国产AI芯片使得单位Token推理成本较年初下降80%。
不仅硬件上有所突破,智谱这次还首次看到了RSI自我递归能力上的早期迹象,创始人唐杰表示GLM-5.3开始帮助优化GLM-5.3-Flash在国产芯片上的部署。
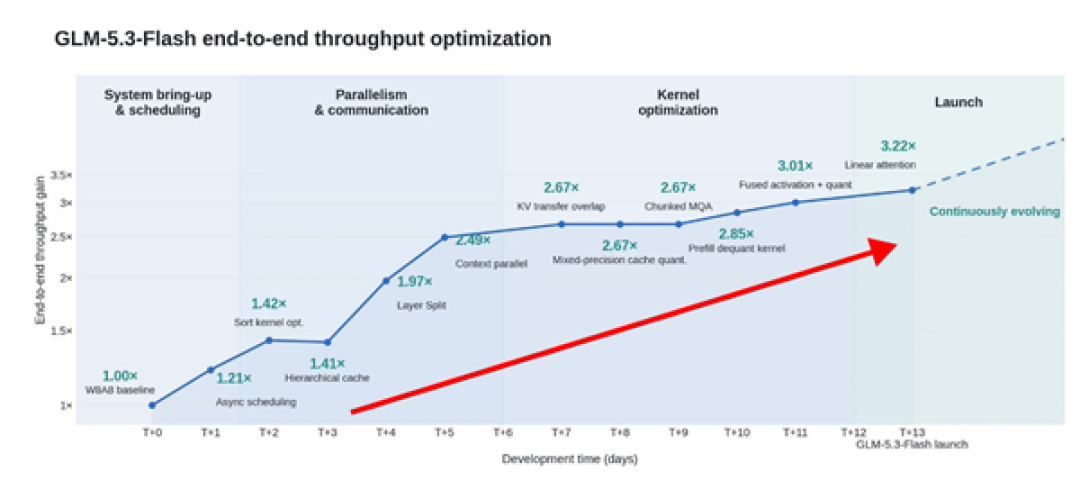
根据他公布的信息,一个由GLM-5.3驱动的Infra Agent用两周时间,帮助GLM-5.3-Flash在国产加速卡上第一次跑通,到承载全部线上流量,端到端吞吐提升至3.2倍。
他提到GLM-5.3驱动的Infra Agent解决了三个关键问题:修复KDA精度漂移,将KV传输开销从30%以上降至1%以内,并通过重构Decode算子获得1.71倍加速。
详细技术细节可以参考智谱官方发布的技术报告。
这还只是智谱在RSI方向的一次探索,此前的财报会议上唐杰还确认了下一代大模型GLM-6要做到fully self-training(完全自训练),从预训练到中训练、再到后训练,都可以完全自己训练自己,并且做自我进化。
这是一个很大的挑战,最大的问题在于:模型能自己判断”什么时候停止、什么时候纠正自己”——这是最大的难题,而不是简单地”把模型训大、直接往下做”,所以未来模型会作为一个重点来研究。
编辑:宪瑞
【本文结束】如需转载请务必注明出处:快科技