














15
17
当年王谢堂前燕,飞入寻常百姓家
2022-10-03 13:04:49
106点赞
284收藏
67评论
2016年9月13日,GTC China大会上,NVIDIA发布了Tesla P4 GPU。这是一块采用Pascal架构、2560个CUDA核心、8GB GDDR5显存、显存带宽192.0GB/S半高Data Center系列GPU。这款GPU为了深度学习推理而生,搭载了当时最先进特性的同时只有50/75W的功耗。当初售价高达一万多的P4 GPU,如今闲鱼售价只要500多,我们重新审视这款GPU,它的某些特性依然能为我们所用,包括时至今日在60W功耗下依然算强劲的性能,支持INT8,能够加速神经网络推理,较大的显存以及对编解码的较好支持。低功耗、小体型、编解码性能良好、可以跑常用模型(训练+应用)以及比GTX 1080更好的特性能否让它在现在深度学习的浪潮中,依然有一席之地?
简介
Tesla P4的GPU算力为6.1,核心代号为GP104,同GTX1080一样。具有4个GPC,20个SM单元,每个GPC有5个SM,每个SM有128个CUDA核心,共计2560个CUDA核心,提供5.5TFLOPS的单精度计算性能,,256KB寄存器,96KB的Shared Memory,总共48KB的L1缓存和8个纹理单元。GPU的整体架构图如下图所示:
 Block Diagram of the GP104 GPU
SM的结构图如下图所示:
 GP104 SM Diagram
从SM结构图我们可以看出,这代架构SharedMemory和L1 Cache是分开的。与Maxwell相同,GP104的L2 Cache依然是2048KB。
这代架构的Tuning Guide很短,在之前的CUDA阅读100天(DAY85:阅读 Compute Capability 6.x(gpuworld.cn))里已经有了详细介绍,如果有需要的同学可以自行翻阅CUDA 100天的内容,我们只在这里粗略介绍一下。
Pascal Tuning Guide一开始就说这代架构跟之前的架构比较相似,不需要改任何代码就可以看到明显的加速,然后说这代架构分两个版本,GP100和GP104,同时给出了P100的白皮书和GTX 1080的白皮书,而Tesla P4就是专业卡版本的GTX 1080,之所以说差不多,是说某些详细参数上有些差异,但是核心参数是一样的,比如GTX1080采用的是GDDR5X的显存,显存带宽也是320GB/S,核心频率也较高,当然功耗也高。
下面就说了一些SM里的资源情况,指出了GP100和GP104在资源上的不同,这里可以详细参考CUDA 100天的内容。在新的计算指令里提到,Pascal架构支持FP16和INT8,但是FP16速度上,GP100是2xFP32,跟Jetson Nano一样,GP104上是1/64,感觉用还不如不用。
INT8的小节中,NVIDIA这么描述” GP104 provides specialized instructions for two-way and four-wayinteger dot products. These are well suited for accelerating Deep Learninginference workloads.”意思是GP104上提供了dp4a和dp2a指令,但是没说GP100上也提供,这样看GP100不支持INT8(实际上也不支持,INT8是从算力6.1开始支持的)。在性能上” Both instructions offera throughput equal to that of FP32 arithmetic.”和FP32具有一样的吞吐率,但是这句之前有一句:” The __dp4a intrinsic computes a dot product of four 8-bit integerswith accumulation into a 32-bit integer.”这样就可以理解为是说前者一条的代价,和一条普通的FP32指令一样,但是前者是4组int8打包的,所以是400%的吞吐率,也即理论上提供22T的INT8性能。在下面TRT实验中,我们也可以看到提升了一倍的加速效果。
新的特性还有Atomic Memory Operations也即介绍原子操作的一些东西,共享内存以及共享内存带宽,以及新的统一内存,这些都在CUDA 100天上有详细介绍,这里不再累述。
以上都是关于这张卡计算部分的总结,下面我们来看看这张卡另一个重要特性,也即视频编解码,Tesla P4对当今(2022年)主流的编解码支持依然非常友好。我们根据NVIDIA Vedio Encode and Decode GPU Support Matrix表来看下T4 GPU的视频编解码能力。
P4 GPU视频编码支持如下:
 Encode GPU Support Matrix
图中大红圈里的为P4GPU的编码支持,可以看出,P4 GPU属于数据中心系列,支持h.264标准 YUV420采样,444采样和Lossless、支持h.265标准 YUV420采样,444采样和Lossless,支持最大编码分辨率为8K,同时h.265支持10bit编码,但是不支持B Frame,不支持AV1编码。拥有两个编码硬核,注意小红圈里的Unrestricted,无限制,我们再看下GTX 1080的编码支持中这部分的描述:
 GTX 1080’s Encoder
我同样用小红圈将其画出,GTX 1080只支持3路视频编码。注意这里的3,是只整机支持的数目,也就是说,你将机器中插入8张GTX 1080,依然只能支持3路视频编码,而P4是无限制的。2颗编码硬核的编码速度大约为1000fps,如果用来编码本地视频,3路和无限制其实区别并不大,3x333fps跟33x30fps对本地视频来说没有本质区别,都能最大化利用编码硬核性能。但是对实时视频就不一样了,对于直接读取摄像头视频,然后推理,编码保存这个过程来说,摄像头帧率一般为15~30帧,3路最多也只有90fps的编码性能,只利用了1/10不到,后面实验部分我们可以看到,视频编码有个基本功率,这个功率非常大,编码硬核利用率越低,这个代价就越大。而P4对编码路数没有限制,实验中我们可以看到随着编码路数的增加,显卡功耗并没有太大变化。
P4视频解码支持如下:
 Decode GPU Support Matrix
可以看出解码应对当今主流视频标准依然没什么压力,支持h.264,h.265 8bit 10bit,支持VP8和VP9 8bit,不支持h.265 444采样,不支持AV1解码。不过考虑到目前h.265444采样依然没有推广开来,片源很少,AV1编码的视频同样片源很少,不管是下载的电影资源也好,还是摄像头的实时视频也好,基本都是420采样的h.264或者420采样的h.265,所以可以看出,视频解码部分依然支持良好。
由于解码部分性能消耗相对很小,这部分放不放到GPU里做其实区别不大,因此这部分我们不做深究,也不做实验测试。
下面继续介绍一些它的其他特性:
半高:半高显卡属于小众市场,但是确实有很多场景又需要半高显卡,各个显卡厂家也都退出了性能不错的半高显卡,比如半高GTX 1650,半高750等,甚至还有半高的3060专业版——A2000。半高显卡受众较小,价格一般相对比较昂贵,比如半高的GTX 1650这张卡只有FP16性能比P4好一点,其他方面性能均不如P4,闲鱼价格要700多,而各方面都很差的GTX750半高卡,也要200块左右,相对来说P4从价格上还是很划算的。
单槽:P4是一张单槽卡,A2000是双槽卡,由于我的nas机箱只支持半高单槽,所以没法用A2000。
被动散热:这张卡定位是Data Center系列,没有主动散热器,这是这张卡使用最麻烦的地方,我先手动锁定功耗到60W,然后用了一个8cm的风扇侧吹,跑训练测试的时候温度88度,功耗不稳定,但约45W左右,用yolov5s模型+coco128数据集,能基本不降频跑完300个epochs测试。虽然闲鱼上有人卖散热模块,其他地方也有魔改散热教程,但是折腾都需要付出一定的时间精力,这点需要考虑好。
没有外接供电口:无需外接供电,这点必须好评。
没有显示输出口:这个可能在一般的电脑上没有什么问题,有核显就用核显输出,没有核显可以再加块亮机卡就解决了,但是我这块主板为X99E/ITX,只有一个pciex16的插槽,X99支持的CPU天然没有核显,因此局面一度非常尴尬,我只能先接一张亮机卡,然后调整bios里的各种选项,确保系统无问题了,再将亮机卡换成P4,然后开机,不过还好很顺利,直接就进系统了。如果亮机卡无问题,换P4启动不了,甚至没法排查。不过没有显示输出接口,理论上又能省点电。
ECC内存支持:P4支持ECC校验,开启后会损失一部分显存,好评。
 GPU Memory on enable ECC
开启过后,显存可用为7611MB,下图显示关闭ECC时显存:
 GPU memory with ECC disabled
可用为8121MB,差了500MB。值得注意的是开启ECC关闭ECC这个操作是有寿命的,开关几千次就不能再继续开关了。
虚拟化支持:P4支持虚拟化,可以切分,但是我没用过虚拟化,贴一张官网的P4 FOR VIRTUALIZATION。
 P4 FOR VIRTUALIZATION
至此,P4的特性基本介绍完毕,下面开始测试部分。
测试
1. DeviceQuery测试
 DeviceQueryTest
2. 显存带宽测试
 BandwidthTest
在虚拟机里实测显存读写143.8GB/s,跨PCIE为10.6GB/s,这个结果还可以。
3. 深度学习模型训练
环境介绍:
框架:pytorch
模型:yolov5s
数据集:coco128
BatchSize:16
ImageSize:640
Epochs: 300
加8cm风扇侧吹,训练耗时0.7个小时,温度稳定88度,核心频率800~900MHz,基本稳定,可以看出散热压力还是大。
我手头没有性能相近的其他显卡,也没T4,但是有2080,同参数下,2080跑完训练耗时为0.155小时,但是此成绩不能代表T4成绩,因为T4也有功耗75W和被动散热的限制。不过我觉得0.7个小时其实还好。
同参数下,3080的耗时为0.11个小时,3090的耗时为0.1个小时。
未对其他模型进行进行测试,不过在其他卡上我有不同模型的详细测试数据,需要注意的是,模型训练过程中,会卡7611显存容量大小,比如将bs设置成32的话,或者模型yolov5l,imagesize设置成1024 都会吃掉7.9GB左右的容量,这个时候,开启ECC无法训练,但是关闭ECC却可以。
4. 深度学习模型推理
我们直接采用yolov5s模型,trtexec 转onnx模型,得到的测试结果作为推理耗时:
 Yolo V5s InferencePerformance -FP32
单帧推理约8ms,按40ms的时间检测,约能支持5路视频实时推理。
如果换成INT8,结果如下:
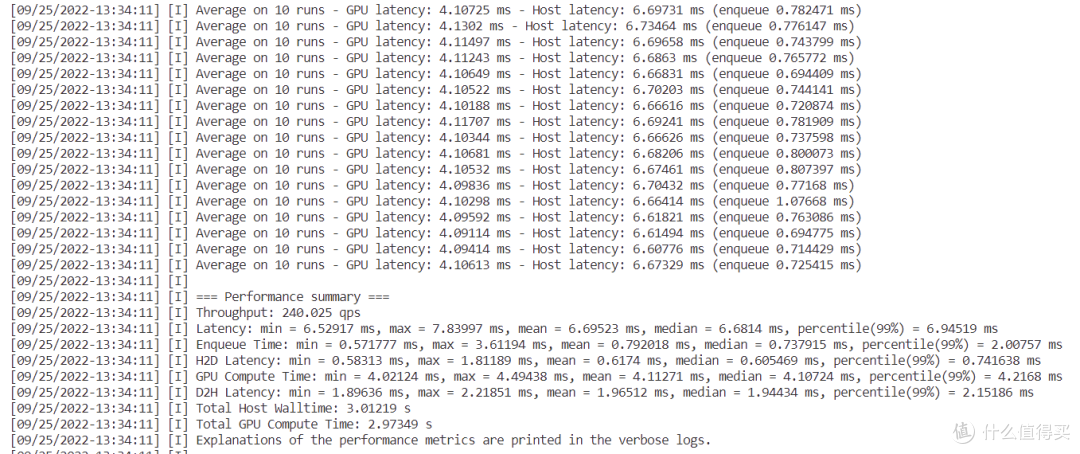 Yolo V5s InferencePerformance -INT8
约4.1ms,差不多快了一倍,约能支持10路视频实时推理。
由于手头的其他显卡成绩都比这个性能强很多,不拿其他显卡做对比测试,而选用Jetson系列的产品作为对比测试:同模型Jetson Nano的推理时间为96ms左右,Jetson Xavier NX推理时间为15ms。这个推理成绩其实还不错。
5. 视频编码性能测试
使用ffmpeg进行编码性能测试,编码参数:
ffmpeg -vsync 0 -hwaccel cuvid -c:v h264_cuvid -i test.mp4 -c:v h264_nvenc -preset slow-profile main -qp 20 output.mp4
frame=14427 fps=344 q=19.0 size= 231168kB time=00:16:49.66bitrate=1875.6kbits/s speed= 24.1x
 nvidia-smidmon results for single video encoding
可以看到编码速度344fps,encoder芯片利用率约为50%,同时再跑一路:
frame= 8914 fps=238 q=19.0 size= 142848kB time=00:10:23.74bitrate=1876.1kbits/s speed=16.6x
 nvidia-smi dmon results for two videos encoding
功耗略微增加,视频编码硬核编码速度为332+238约570fps,编码硬核只有70%利用率,解码硬核已经100%了,将第二路的视频解码换成CPU继续测试。
ffmpeg -vsync 0 -itestencoder.mp4 -c:v h264_nvenc -preset slow -profile main -qp 20 output22.mp4
frame=10883 fps=339 q=19.0 size= 174336kB time=00:12:41.72bitrate=1874.9kbits/s speed=23.8x
frame= 9504 fps=266 q=19.0 size= 152320kB time=00:11:05.47 bitrate=1875.1kbits/sspeed=18.7x
总共约339 + 266 =605fps的编码速率,编码硬核利用率约90%,功耗约为30W。
 nvidia-smidmon results for two videos encoding with CPU decoding
ffmpeg -vsync 0 -hwaccel cuvid -c:v h264_cuvid -i testencoder.mp4 -c:v h264_nvenc-preset faster -profile main -qp 20 output.mp4
frame= 8932 fps=427 q=19.0 size= 150784kB time=00:10:25.02bitrate=1976.3kbits/s speed=29.9x
frame=10908 fps=322 q=19.0 size= 184064kB time=00:12:43.77bitrate=1974.2kbits/s speed=22.5x
 nvidia-smidmon results for two videos encoding with CPU decoding
改用preset fast 可以达到427 + 322 = 749fps的速度,利用率依然不到100%,功耗总共30W。
还可以改变参数继续测试,但是我认为已经没什么必要了,可以看出编码速度非常非常快,甚至解码速度都赶不上编码速度(只有一个解码硬核,而有两个编码硬核)。不过我们需要注意的是,这时的功耗,单路视频编解码时,功耗为28W,我个人认为这个是启动功耗,也即基础开销,这28W是显存、GPU核心等单元共同使用的,再增加一路视频编码,功耗为30W,说明增加的那一路视频编码功耗只高了2W,这样两颗编码硬核功耗就约为4W,能提供约800fps的编码速度,这个能效比还是很好的,同时需要注意,编码时sm一样有利用率,说明利用GPU编解码视频时,执行推理时就无法利用全部的CUDA Core理论性能。开nvidia-cuda-mps-control -d后,能普通CUDA计算,和转码几乎同时压满(需要一点点小技巧,CUDA计算创建流的时候用cudaStreamCreateWithPriority(),选低优先级计算即可(传输参数0)。
6. B帧对HEVC编码成品体积影响
最后我们来简单测试下B帧对HEVC编码体积的影响,由于P4不支持HEVC B Frame,因此这个测试是在3090上做的,做这个测试的目的是为了探讨不支持HEVC B Frame是否非常影响最终编码体积。
测试环境为监控摄像头,其他参数一致的情况下,我们记录180秒监控视频,来对比两者体积变化。视频动态非常小,几乎为静止画面。
关闭B帧:
ffmpeg -vsync 0 -i testencoder.mp4 -c:v hevc_nvenc-preset fast -b_ref_mode 0-t 180 output33.mp4fps = 826
编码视频体积 46.4MB
指定b_ref_mode为2:
ffmpeg -vsync 0 -itestencoder.mp4 -c:v h264_nvenc -preset fast -b_ref_mode 2 -t 180 output22.mp4
fps = 868
编码视频 体积46.4MB
同参数下选用h.264编码:
ffmpeg -vsync 0 -itestencoder.mp4 -c:v h264_nvenc -preset fast -t 180 output33.mp4
fps = 816
编码视频体积 45.5MB
可以看出,这个B Frame的支持,对成品体积控制而言,几乎没什么效果。但是根据另一位工程师反映,同样的参数,使用B帧能在30系上能小10-20%体积。我懒得继续调参测试,就没继续测。
总结
这张卡目前价格为500元左右,甚至批量买500张,可以低到300/张,性能测试下来,其实也不错,一些特性直至今天用依然非常够用,包括性能。尤其是考虑到半高单槽,这个价格应该没有性价比更高的,包括A卡在内。问题也有两点,一是散热很不好做,容易碰到过热降频;二是没有显示输出,显卡3060矿卡价格大概是800元左右了,性能要比这个好很多,除非是限制了只能半高单槽。3060是有显示输出的,不需要再外接亮机卡。可能也有人担心3060是矿卡,寿命应该不长,但是挖矿消耗的是显存、供电等周边设备,这种数据中心的卡,不仅7x24小时耗显存、供电,同时还耗核心,核心也都是一直满载的,当然机房的环境肯定是比矿场好很多的,所以也难说这种卡和矿卡谁先挂。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~











hifier
校验提示文案
悠远之风
校验提示文案
好好小饼干
校验提示文案
一边玩去
校验提示文案
真败家
校验提示文案
不是浮云
校验提示文案
weiOiseau
校验提示文案
狂野小凶许
校验提示文案
tutugreen
校验提示文案
点钞票
校验提示文案
ex-sugumi
校验提示文案
dongyi945
可惜这卡只能当玩具,而且是个门槛非常高的玩具。
校验提示文案
pengben
校验提示文案
都德丶
校验提示文案
eyh911
校验提示文案
max629
校验提示文案
梅雯桦
校验提示文案
猫皮
校验提示文案
darkblue
校验提示文案
魔术师EW
校验提示文案
向往自由生活的布莱特
校验提示文案
股票大涨
校验提示文案
[已注销]
校验提示文案
yulll
校验提示文案
macdogy
校验提示文案
[已注销]
校验提示文案
不记得了
校验提示文案
boeing7xx
校验提示文案
值友8366786178
校验提示文案
volnet
校验提示文案
HOUSEN1
校验提示文案
值友5120685312
校验提示文案
连吃两个西红柿
校验提示文案
值友4598185122
校验提示文案
snakesgun
校验提示文案
ex-sugumi
校验提示文案
值友3008898037
校验提示文案
值友4470834208
校验提示文案
weiOiseau
校验提示文案
pengben
校验提示文案