












12
8
别再把整页网页塞给 AI 了:Crawl4AI 帮你整理成 Markdown
2026-10-12 11:42:35
0点赞
2收藏
1评论
想让 AI 总结一篇文章,把链接发过去,它却读不到正文。
换成复制整个网页,又把导航、相关推荐、订阅提示一起带了进去。几篇资料还好,几十个链接就得反复清理。
如果你经常搜集文章、整理产品资料,或者准备搭建自己的知识库,可以了解一下 Crawl4AI。
它把网页访问、内容整理和数据提取放进同一个流程,输出便于阅读的 Markdown,或者方便程序处理的 JSON。整理好的内容,可以继续交给 AI 做摘要、对比和问答。
01|它能帮你省掉哪一步?
Crawl4AI 是 unclecode 发起的开源网页抓取工具,主要面向大模型和 AI 应用的数据准备。
你给它一个网页地址,它通过浏览器访问页面,再把内容转换为 Markdown。文章里的标题、段落、列表和链接,可以保留成比较清楚的结构。
这一步解决的是:让网页内容更容易被后续工具使用。
比如整理十篇产品说明,先把它们抓取成 Markdown,再让 AI 按“功能、适用人群、限制”对比;做知识库时,先整理文档,再进行切分、检索和问答。
基础抓取和 Markdown 转换不要求配置大模型 API Key。只有选择模型驱动的提取或过滤功能时,才需要相应的模型服务。
截至 2026 年 10 月 12 日,GitHub 与 PyPI 核对到的最新正式版本均为 v0.9.4,Python 要求为 3.10 及以上。项目采用 Apache-2.0 许可证。
02|把网页变成可整理的材料
第一,保留文章结构。
直接拿到 HTML,里面往往有大量脚本、样式和页面布局标签。转成 Markdown 后,文本与层级更容易看清,也更方便存到笔记或知识库中。
但要分清两种结果:普通 Markdown 转换,并不意味着所有侧栏和推荐内容都会消失。
想进一步筛掉杂项,可以配置内容过滤器。例如,剪枝过滤器会按文本密度等特征筛选区块;BM25 过滤器可以围绕你给出的查询,挑出更相关的内容。
过滤后的内容更短,也可能漏掉信息。 价格条件、表格备注和例外说明,都值得与原网页再对一遍。
第二,读取需要等待的页面。
有些网站打开后,正文才通过 JavaScript 加载;还有些需要滚动、点击“加载更多”才能看到后续内容。
Crawl4AI 使用 Playwright 浏览器流程,支持设置等待条件、执行页面脚本和管理会话。对这类页面,可以按实际加载方式配置抓取步骤。
关键是等到目标内容出现。浏览器成功打开页面,不代表需要的数据已经加载完整。
第三,批量处理多个链接。
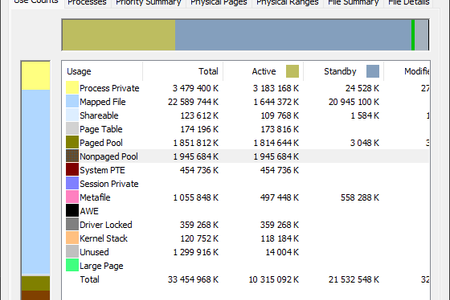
整理文档库或跟踪多个产品页面时,工具支持并发抓取,也提供根据内存情况调整任务调度的机制。
项目文档用下面的界面展示任务状态、内存占用与耗时,便于观察一批任务的运行情况。
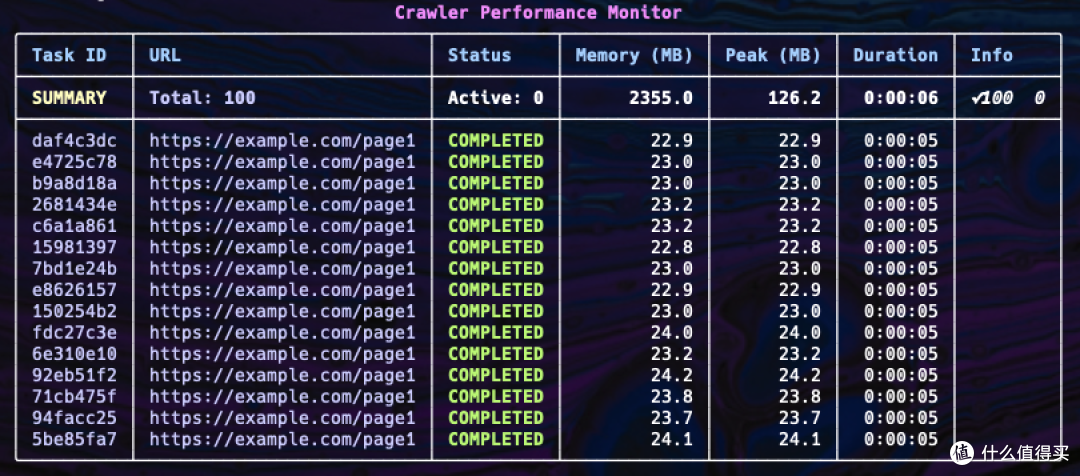 Crawl4AI 项目文档中的并发任务监控示例
并发数量要结合电脑内存、页面复杂度和网站响应调整。少量链接先跑通、确认内容完整,再扩大范围,会更容易定位问题。
03|需要表格数据时,可以输出 JSON
如果你要整理的是一批商品名称、规格、价格,或者文章标题、发布日期和链接,只保存整篇文字还不够方便。
Crawl4AI 提供了两类常见方法。
页面结构比较固定,可以用 CSS 或 XPath 规则提取。 指定标题在哪个元素里、链接从哪个属性读取,就能按字段输出。这条路径无需调用大模型,但页面结构改了,规则也可能需要调整。
页面结构不统一,可以考虑模型提取。 先说明想要哪些字段,再让模型按要求整理为 JSON。
后者更灵活,也增加了模型调用成本与结果校验工作。尤其是价格、单位和日期,提取完成后仍应抽查,缺失字段也要保留为缺失,不能让模型自行补齐。
如果只是做文章摘要,先把 Markdown 整理好通常就够了,不必一开始就上模型提取。
04|第一次用,先完成一个小任务
它的开源 Python 版需要安装环境、运行命令。对完全不接触代码的读者,学习成本会比普通浏览器插件高一些。
愿意尝试的话,建议先设定一个很小的目标:把一篇可公开访问的网页保存成 Markdown 文件。
确认电脑已经安装 Python 3.10 或更高版本,然后在独立环境中安装。以下命令以本文核对的 v0.9.4 为例:
python -m pip install crawl4ai==0.9.4
crawl4ai-setup
crawl4ai-doctor
第二条命令用于准备浏览器环境,首次执行可能需要下载组件;第三条命令检查安装情况。Windows、macOS 和 Linux 的浏览器依赖处理可能有所不同,遇到报错以官方安装文档为准。
安装完成后,可以把下面的代码保存为 first_crawl.py:
import asyncio
from pathlib import Path
from crawl4ai import AsyncWebCrawler

async def main():
    async with AsyncWebCrawler() as crawler:
        result = await crawler.arun(
            url="https://example.com"
        )
        if not result.success:
            print(result.error_message)
            return
        Path("page.md").write_text(
            result.markdown.raw_markdown,
            encoding="utf-8"
        )

asyncio.run(main())
在文件所在目录运行 python first_crawl.py。示例先使用简单的公开页面;随后再把地址换成你有权访问和处理的目标网页。
生成文件后,先打开检查标题、正文与链接。发现导航内容混进来,再配置正文范围或过滤器;遇到缺字,再检查页面等待和加载方式。
这段代码按官方接口整理,未在本文中独立运行测试。
05|适合谁?哪些期待要先放下?
经常批量整理资料的人。 技术文档、产品说明、公开报道,需要定期汇总时,可以把重复的网页整理步骤做成流程。
搭建本地知识库的人。 Markdown 更方便后续切分与索引。保存时最好同步记录原始网址和获取日期,回答问题时才能回到出处核对。
开发 AI 工具的人。 可以把抓取、规则提取与模型处理串起来,根据页面类型选择不同方法。
如果只是偶尔读一两篇文章,手动复制正文也很直接。Crawl4AI 的优势更容易体现在重复任务中。
至于“每页 200 毫秒”“固定省掉 95% Token”,不能当作通用承诺。耗时与输入长度取决于网络、浏览器启动、页面内容、缓存和过滤设置;更精简的输入也不自动等于更准确的回答。
登录、验证码与访问限制仍可能让抓取失败。工具提供的浏览器、代理和会话配置,不代表所有网站都能直接读取。
它也不会替你完成文章事实核对。来源是否可靠、信息是否过期、图片能否使用,仍要逐项判断。
06|从官方入口开始
如果你正打算把资料收集接入 AI 工作流,可以先用一篇网页验证:抓取是否完整、Markdown 是否清楚、后续摘要是否保留了关键条件。
作者还提供了一小时的官方教程,覆盖基础抓取、过滤 Markdown、结构化提取和页面交互,适合跟着示例继续学习。
项目与下载入口:
• GitHub:https://github.com/unclecode/crawl4ai
• Python 安装包:https://pypi.org/project/crawl4ai/
• 官方文档:https://docs.crawl4ai.com/
你最想先整理哪类网页:文章资料、产品说明,还是自己的知识库文档?
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~






校验提示文案
校验提示文案