
















15
27
双卡2080Ti跑Qwen3.8 27B,200tok/s还能战吗?
2026-09-26 23:03:51
0点赞
0收藏
1评论
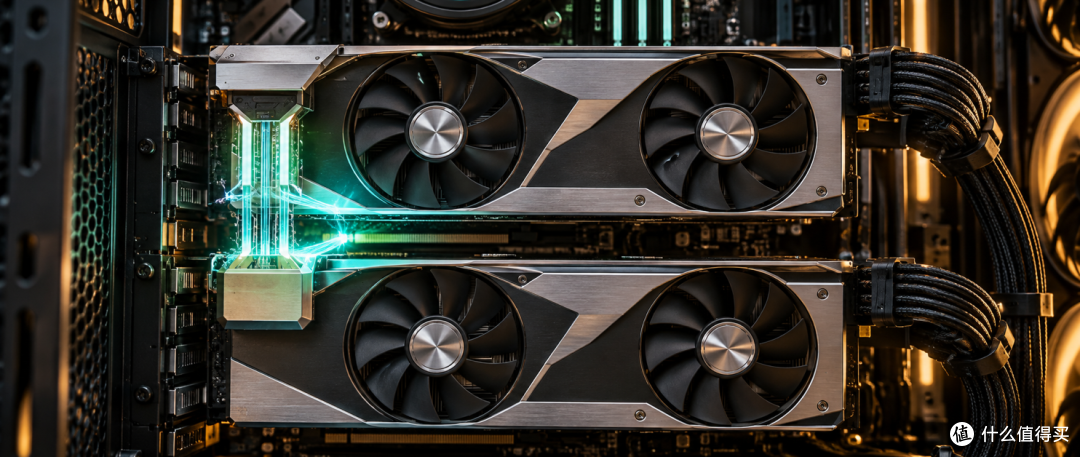
双卡 RTX 2080 Ti 跑 Qwen3.8 27B 超过 200 tok/s,老显卡还能再战吗?
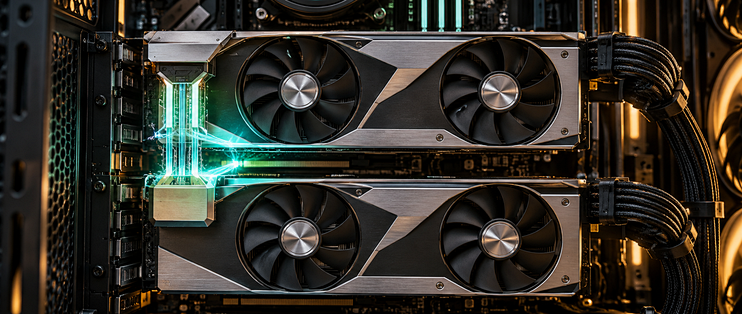
最近我在研究本地运行大模型,发现一套比较有意思的方案:使用两张 RTX 2080 Ti,搭配 Qwen3.8 27B,在单请求测试中可以达到 200 tok/s 以上的解码速度。
这个成绩乍看非常夸张,但仔细分析后会发现,真正起作用的并不只是两张显卡,模型量化、推理框架以及推测解码同样重要。
双卡 2080 Ti 的表现如何?
在特定配置下,Qwen3.8 27B 的解码速度可以达到 200~220 tok/s 左右,Prefill Speed 则超过 1000 tok/s。
不同测试阶段的结果会有一定波动,首 token 延迟、生成 token 数量和实时速度也会随任务变化。因此,我更愿意把这个成绩理解为:
双卡 RTX 2080 Ti 在合适的模型和推理配置下,有机会把 Qwen3.8 27B 推到 200 tok/s 级别。
这并不意味着所有双卡 2080 Ti 都能稳定达到同样的速度,更不能简单理解为两张显卡叠加后就一定能获得固定性能。
关键不只是显卡数量
这套方案的加速效果,和推理环境有很大关系。
常见的优化项目包括 FlashInfer、FlashAttention2、MTP、TurboQuant KV 和 RoPE Extension 等。它们分别涉及注意力计算、推测解码、KV Cache 显存占用和上下文扩展等环节。
其中比较关键的可能是推测解码。
简单来说,系统会先让一个较快的预测过程猜测后续 token,再由主模型进行批量验证。如果预测结果的接受率比较高,就能减少主模型逐 token 生成的次数,从而显著提升整体速度。
所以,最终能不能达到 200 tok/s,不仅取决于显卡算力,还取决于模型输出内容、接受率、上下文长度以及具体的推理框架。
这套方案适合哪些人?
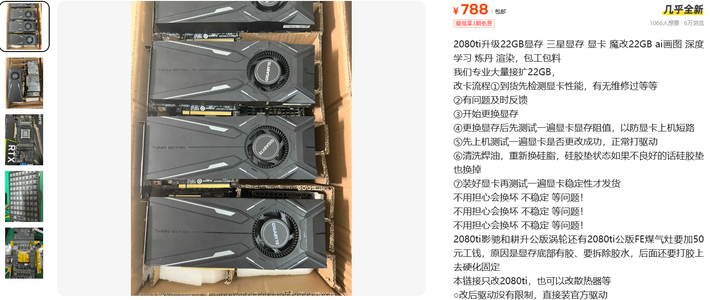
如果手里已经有两张 RTX 2080 Ti,并且愿意折腾本地 AI,这套方案值得尝试。
它的优点比较明显:
老显卡还能继续发挥作用;
本地运行大模型,不需要长期依赖在线 API;
单用户聊天、代码补全等场景可以获得非常快的输出速度;
硬件成本有机会低于购买新一代高显存显卡。
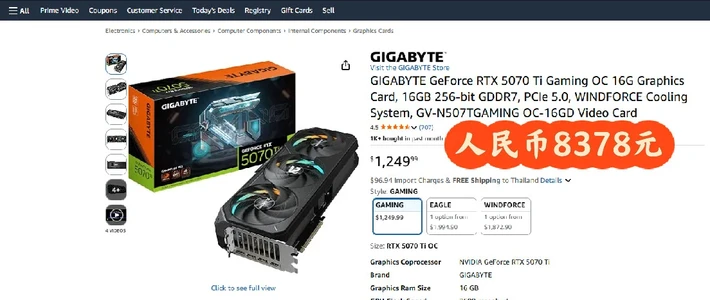
不过,如果是为了这套方案专门购买二手显卡,我建议先把整机成本算清楚。
除了显卡本身,还要考虑主板插槽、电源容量、显卡间通信方式、机箱空间、散热和噪音。两张老显卡虽然价格可能比较便宜,但功耗、发热和调试成本也可能更高。
200 tok/s 并不代表所有场景都一样快
本地大模型的速度很容易受到使用场景影响。
下面这些情况,都可能导致实际速度明显下降:
输入提示词很长;
上下文不断累积;
进行多轮复杂对话;
运行代码或深度推理任务;
多用户同时访问;
推测解码接受率降低;
显存不足,需要频繁进行数据转移。
因此,200 tok/s 更适合作为特定环境下的性能参考,而不是所有机器都能达到的标准成绩。
如果只是日常聊天,几十 tok/s 通常已经足够流畅;如果需要长上下文、复杂代码任务或多人并发,就不能只看峰值速度,还要关注显存容量、持续吞吐、延迟和稳定性。
我的看法
我认为,双卡 RTX 2080 Ti 跑 Qwen3.8 27B 的意义,不在于证明老显卡可以全面替代新显卡,而是说明本地 AI 还有很多低成本折腾空间。
对于已经拥有旧显卡的用户,这是一条值得研究的路线。通过合适的模型量化、推理框架和解码优化,老硬件依然可能获得不错的本地 AI 体验。
但对于准备购买硬件的新用户,我不建议只看到“200 tok/s”就直接下单。最好先确认显卡显存、主板、电源、散热和二手成色,再结合自己的使用需求计算总成本。
如果只是为了聊天,单张新显卡可能更加省心;如果希望低成本运行较大的本地模型,并且愿意自己调试,双卡 2080 Ti 仍然有一定吸引力。
总的来说,这套方案证明了老显卡并没有完全失去价值,但它更适合喜欢折腾、重视性价比的玩家,而不是追求开箱即用的普通用户。
作者提示含AI生成内容。










校验提示文案
校验提示文案